amd64 微架构级别对 Go 程序性能提升多少?

在 Go 1.17 之前,Go 编译器总是生成可由任何 64 位 x86 处理器执行的 x86 二进制文件。
Go 1.18 为 AMD64 引入了 4 个架构级别 。每个级别在编译器可以包含在生成的二进制文件中的 x86 指令集上有所不同:

  • GOAMD64=v1(默认值):基准模式。仅生成所有 64 位 x86 处理器都能执行的指令。
  • GOAMD64=v2:所有 v1 指令,加上 CMPXCHG16B、LAHF、SAHF、POPCNT、SSE3、SSE4.1、SSE4.2、SSSE3。
  • GOAMD64=v3:所有 v2 指令,加上 AVX、AVX2、BMI1、BMI2、F16C、FMA、LZCNT、MOVBE、OSXSAVE。
  • GOAMD64=v4:所有 v3 指令,加上 AVX512F、AVX512BW、AVX512CD、AVX512DQ、AVX512VL。

例如,设置 GOAMD64=v3 将允许 Go 编译器在生成的二进制文件中使用 AVX2 指令(这在某些情况下可能会提高性能);但是这些二进制文件将无法在不支持 AVX2 的旧 x86 处理器上运行。
Go 工具链也可能生成更新的指令,但会通过动态检查来确保它们只在支持的处理器上执行。例如,如果设置了 GOAMD64=v1,并且 CPUID 报告 POPCNT 指令可用,那么 math/bits.OnesCount 仍然会使用该指令。否则,它会回退到通用实现。
Go 工具链目前不生成任何 AVX512 指令。
不支持 SSE3 的平台不支持种族检测器。

64 位 Intel 和 AMD 处理器已经演进了几十年。当你为 64 位 Intel 或 AMD 处理器编译 Go 程序时,编译器默认面向的是一个将近 20 年前的指令集。生成的二进制文件几乎能在任何 x64 芯片上运行,但同时也放弃了自 2003 年以来添加的所有指令。

我们通常用微架构级别(microarchitecture levels)来描述这一分层。每个级别捆绑了一组可以假定存在的指令集扩展:

级别 新增内容(大致)
v1 原始 AMD64 基线(SSE2)
v2 popcnt、SSE4.2
v3 AVX2
v4 AVX-512(F/BW/DQ/VL)

阅读全文

Loop Engineering 实践:我把 RDMA 开发库移植到 Go 语言,花费 239 块钱

一次几乎全自动的库开发实验:从一份 PRD 出发,15 个 issue 串成流水线,让 Agent 一路 实现 → 审查 → 记录 → 发布,最后我只在真机上验证。本文复盘整个过程,验证了Loop Engineering和实际的花费。

0. 缘起

我想要一个 Go 语言的 RDMA 库。

从去年我们做高性能网络的黑盒监控起,就开始尝试用 RDMA 做探测。但我们的技术栈是 Go,找了几个库,实现得不好也不稳定;换成 C 语言技术栈对团队同学来说成本太高;自己实现当时觉得挺有挑战,于是这件事就搁下了,最后还是退回到用普通 UDP 协议探测。

阅读全文

告别死锁和陈旧语法、告别性能瓶颈:三个开源 Skill,新手Gopher 秒变 Go 语言大神

你是不是也曾经盯着 pprof 火焰图发呆?

线上服务 P99 延迟从 50ms 飙到 800ms,Grafana 告警刷了满屏。CPU profile 翻来覆去看了三遍,热点函数是 sync.Mutex.Lock —— 锁竞争。但问题出在哪?锁粒度大、false sharing、还是并发模型本身选错了?脑子里闪过一堆可能性,每一条都够排查半小时。

如果有一个 Go语言的并发专家和性能专家在身边多好。

还有,对于有经验的老Go程序员,已经习惯了历史的Go语法和代码,对于新的特性反而没有新手更了解,如何保持与时俱进而不被新人所唾弃?

现在,这个愿望变成了现实:三个skill = 顶级有活力的Go语言专家。

三个 Skill,把 Go 的三座大山装进 AI

做 Go 开发这些年,我发现 Go 程序员面对的最棘手的问题,几乎都可以归为三类:

第一类:并发。 死锁、数据竞争、goroutine 泄漏、channel 关闭时机不对、WaitGroup 计数配不平、锁重入导致自死锁……你写过 Go,就一定被其中至少一个坑过。

阅读全文

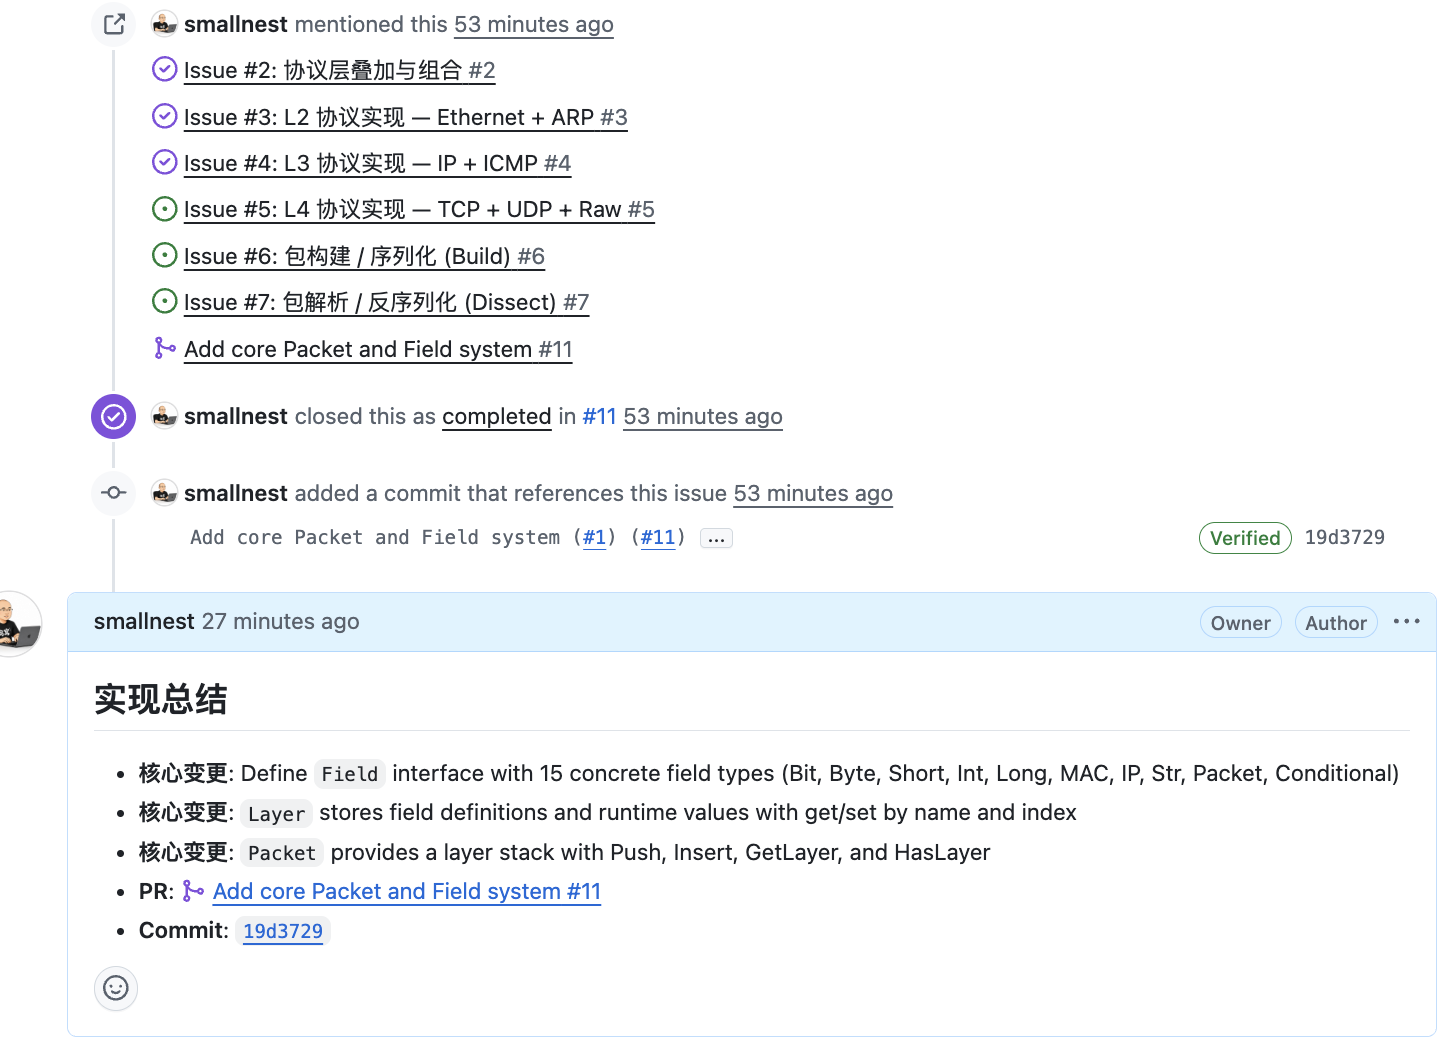
爽呆了,不费吹灰之力,我把scapy翻译成了Go语言

创建需求文档

1
❯ /prd 将 https://github.com/secdev/scapy port到Go语言,保持它的功能和便利性

扫描全国的公网IP需要多久?

自从加入百度负责物理网络的监控业务之后,我大部分的都是编写各种各样额度底层的网络程序。业余时间我也是编写一些有趣的网络程序,不仅仅是兴趣,也是为未来的某个业务探索一下技术方案。

而且这次,我想知道,就在我这一个10年前的小mini机器4核机器上,在家庭网络中扫描全国(中国大陆)的所有的公网IP地址需要多少时间。

利用它,我可以知道和全国各省市的运营商、云服务商的联通情况。有没有运营商的出口故障以及IP已没有被运营商或者有关部门劫持。

TL;DR: 一共扫描了3亿个地址(343142912),当前ping的通的IP 592万个(5923768),耗时1小时(1h2m57.973755197s)。

这次我重构了以前的一个扫描公网IP的程序。先前的程序使用gopacket收发包,也使用gopacket组装包。但是gopacket很讨厌的的一个地方是它依赖libpcap库,没有办法在禁用CGO的情况下。

事实上利用Go的扩展包icmp和ipv4,我们完全可以不使用gopacket实现这个功能,本文介绍具体的实现。

程序的全部代码在:https://github.com/smallnest/fishfinder

阅读全文

使用ebpf跟踪rpcx微服务

ebpf是一种创新的革命性技术,它能在内核中运行沙箱程序, 而无需修改内核源码或者加载内核模块。将 Linux 内核变成可编程之后,就能基于现有的(而非增加新的)抽象层来打造更加智能、 功能更加丰富的基础设施软件,而不会增加系统的复杂度,也不会牺牲执行效率和安全性。

BPF的第一个版本在1994年问世。我们在使用tcpdump工具编写规则的时候其实就使用到它了,该工具用于查看或”嗅探”网络数据包。

阅读全文

强制更改Go标准库的实现

Go标准库中有一些单例的实现,比如log包中默认的Logger、net.DefaultResolver, 这些对象提供了便利的方法,但是有的时候,我们需要做一些定制话的功能,需要更改这些对象,
甚至有的时候,我们需要更改标准库的特定方法,常规手段是不起作用的, 必须使用一些"骇客"的方式。

国庆北京连绵秋雨,整好我窝在家里,实现了一个原本想12月份实现的产品,在开发项目的过程中,也遇到了一些需要更改标准库默认行为的需求,所以在这方面做了一些探索,整理出这篇文章,以飨读者。

阅读全文

[译]使用 bcc/BPF 分析 go 程序

BCC 是基于 BPF 的 Linux IO 分析、监控、网络工具集合。BPF Compiler Collection (BCC) 是创建高效内核追踪和处理程序的工具包,包含几个有用的工具和用例。BCC 扩展了 BPF (Berkeley Packet Filters) 的用途,BPF 之前被称为 eBPF,是 Linux 3.15 新增的一个新特性。BCC 大部分的功能都要求 Linux 4.1+。

本文翻译自性能分析大牛Brendan Gregg的 2017年中旬的一篇文章: Golang bcc/BPF Function Tracing, 介绍如何使用最新的工具更加深入的分析Go程序。

阅读全文