TypeScript 名师 Matt Pocock 开源了一套 Claude Code Skills(https://github.com/mattpocock/skills)。据他在 X(Twitter)上的说明,这套 skills 的核心是 5 个命令串起来的一条主线:
/grill-with-docs → /to-spec → /to-tickets → /implement → /code-review
即:先把想法拷问清楚 → 写成规范 → 拆成卡片 → 动手实现 → 双轴评审。
这套 skills 的问题在于文档跟不上功能,很多人拿到手不知道怎么用。我此前也搭过一套类似流程,并用这套 skills 开发了一个 Go 版本的 pi agent(https://github.com/smallnest/pigo ,仓库里的 issues 都是这套 skill 生成的),因此对它的运作有一定了解。本文介绍这套流程。
安装命令:
1 | npx skills add mattpocock/skills |
开篇:一条从"想法"到"交付"的产线
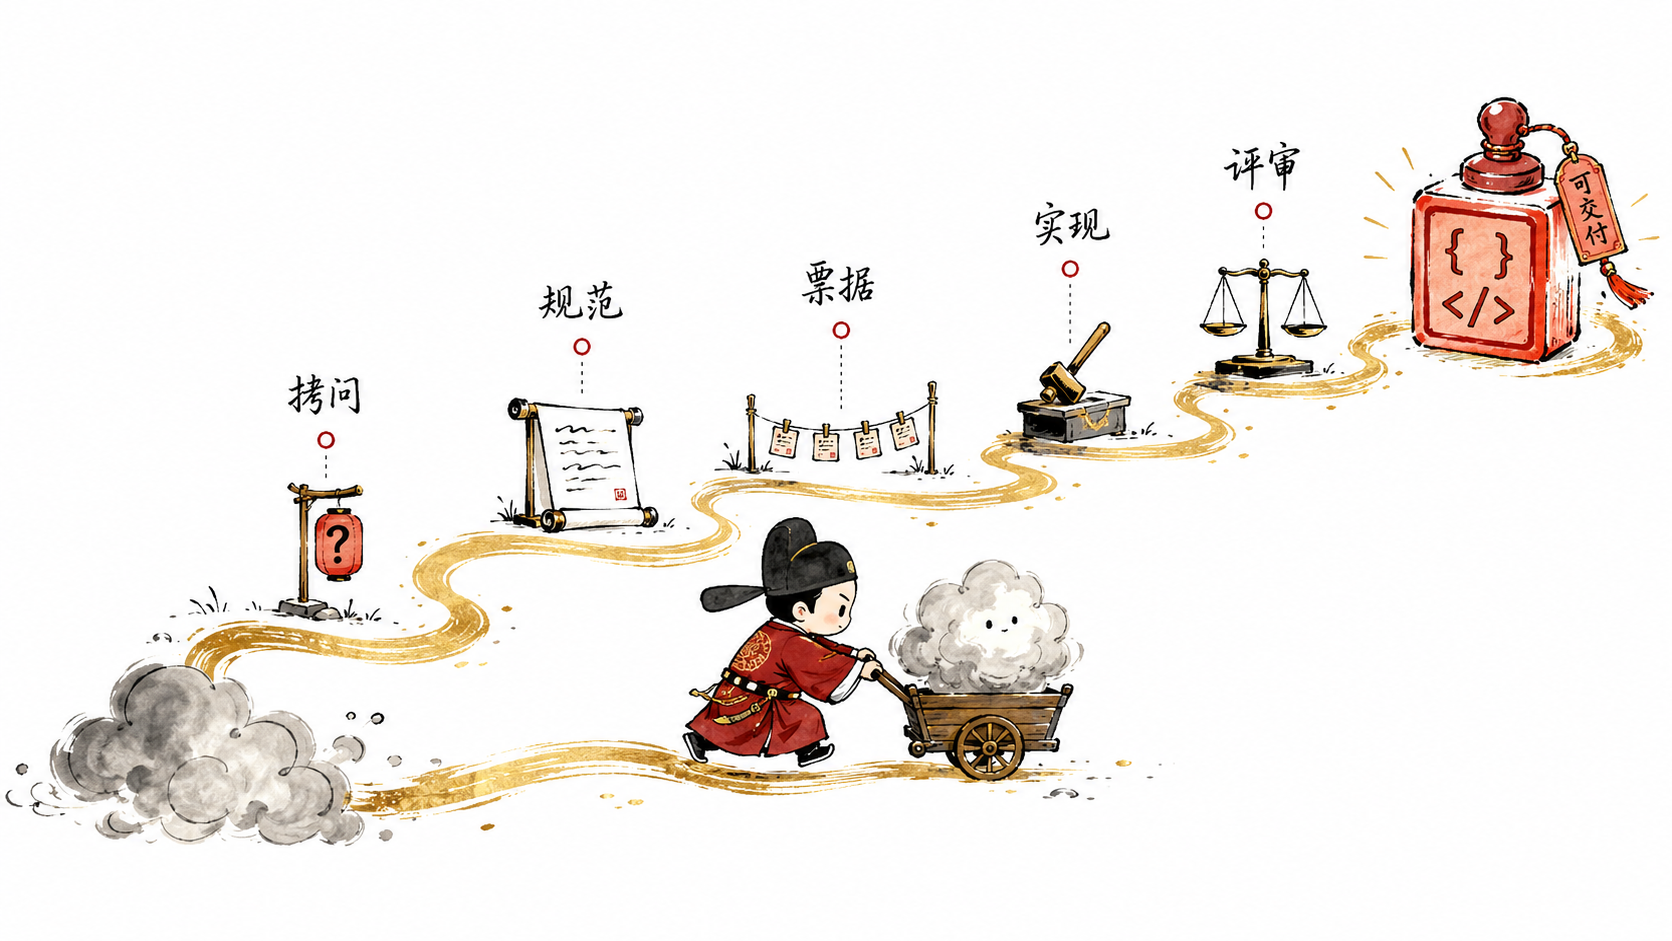
这套流程的出发点很简单:动手写代码之前,先把话说清楚、把结构定下来。前三步几乎都不写代码,只做认知对齐。
先看全景:Engineering 分类里都有哪些 skill
在钻进那条 5 步主线之前,先看一眼 README 里 engineering 这一大类的全貌。Matt 把它们分成两拨——用户主动调用的(User-invoked) 和 模型自己会调的(Model-invoked):
用户主动调用的(User-invoked)
| Skill | 一句话 |
|---|---|
ask-matt |
拿不准该用哪条流程时问它,它是所有 user-invoked 技能的"路由器" |
wayfinder |
目标又大又模糊、一个会话装不下时,先在 issue 上铺一张调查地图 |
grill-with-docs |
一次一个问题拷问计划,同步沉淀 CONTEXT.md / ADR |
to-spec |
把对话综合成规范并发到 issue 跟踪器 |
to-tickets |
把计划拆成一串带阻塞依赖的"示踪弹"票据 |
implement |
照票据/规范施工,驱动 /tdd、收尾自动 /code-review |
triage |
让 issue 在一套分诊角色状态机里流转 |
improve-codebase-architecture |
扫描代码库找"深化机会",出 HTML 报告,再逐个拷问 |
setup-matt-pocock-skills |
每个仓库先跑一次,配好 issue 跟踪器/分诊标签/领域文档结构 |
| 模型自己会调的(Model-invoked) |
| Skill | 一句话 |
|---|---|
code-review |
对 diff 做双轴评审(标准 × 规范),并行子 Agent |
tdd |
红-绿-重构,一次一个垂直切片 |
codebase-design |
设计深模块的共享纪律与词汇(Design It Twice) |
domain-modeling |
主动构建并打磨项目领域模型 |
prototype |
造一个用完即弃的原型来回答某个设计问题 |
diagnosing-bugs |
硬 bug/性能回归的纪律化诊断循环 |
research |
后台 Agent,对高可信一手资料调研并落成带引用的 Markdown |
resolving-merge-conflicts |
逐块解 merge/rebase 冲突,绝不 --abort |
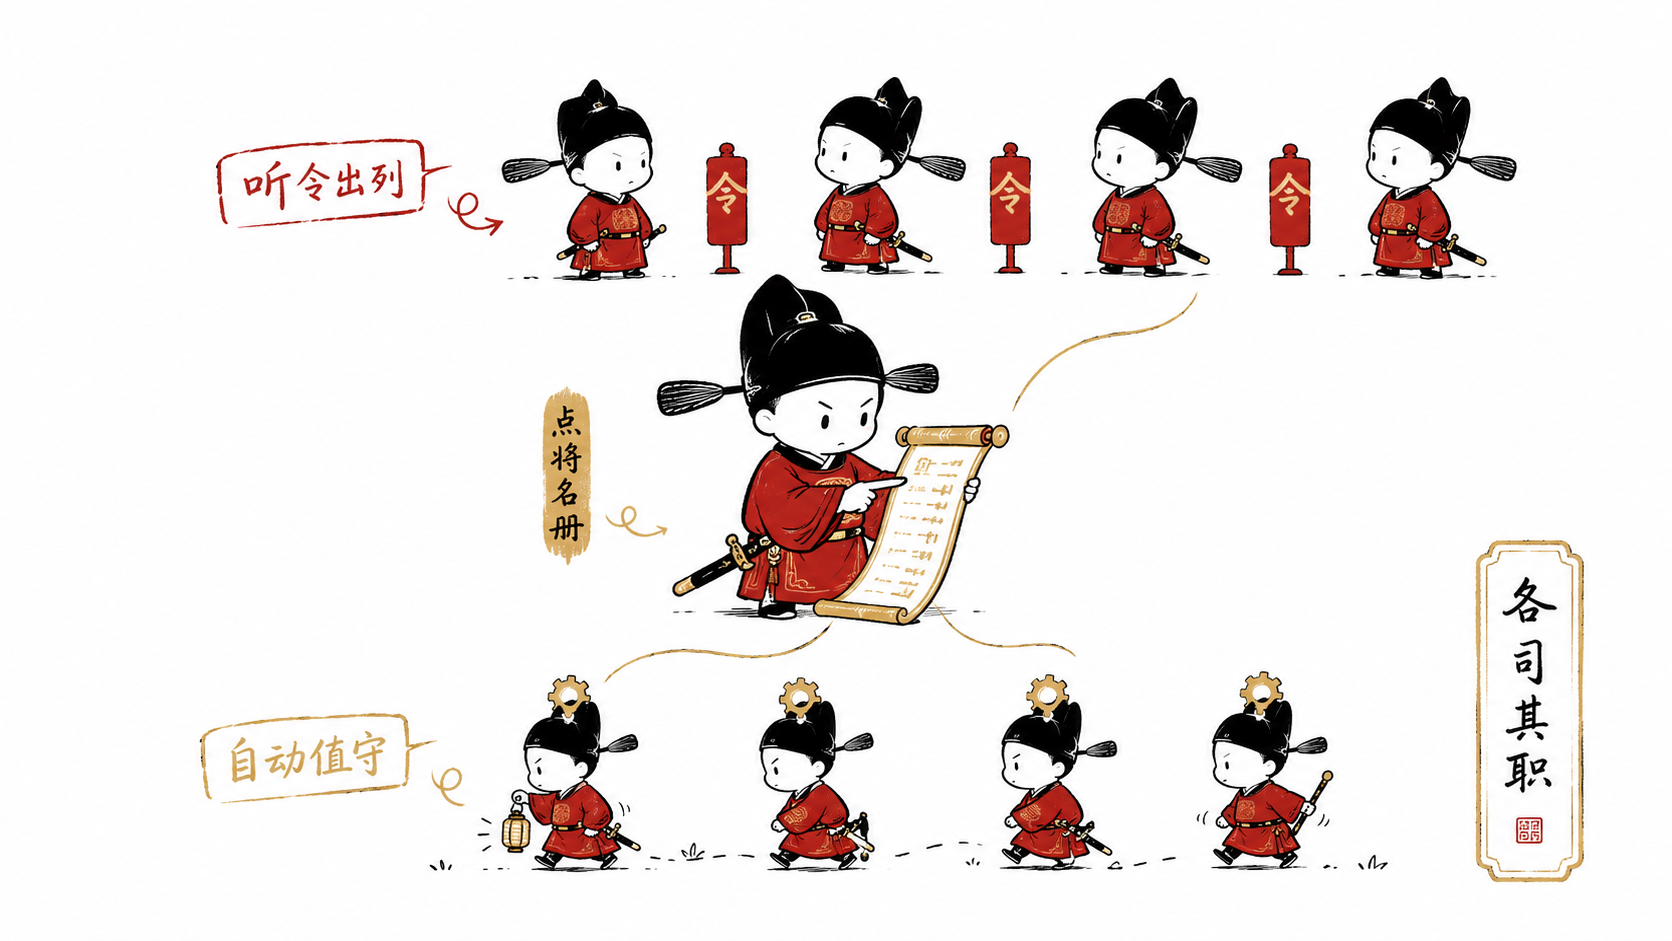
这一整套技能中,Matt 亲自点名的主线核心是 5 个 user-invoked 技能(外加上游的 wayfinder),形成了一套开发流程。下面逐步介绍这流程中的五步。
第一步 · /grill-with-docs —— 用文档拷问你的计划
⚠️ Matt现在主推他的新技能
wayfinder:目标太大的话优先使用wayfinder
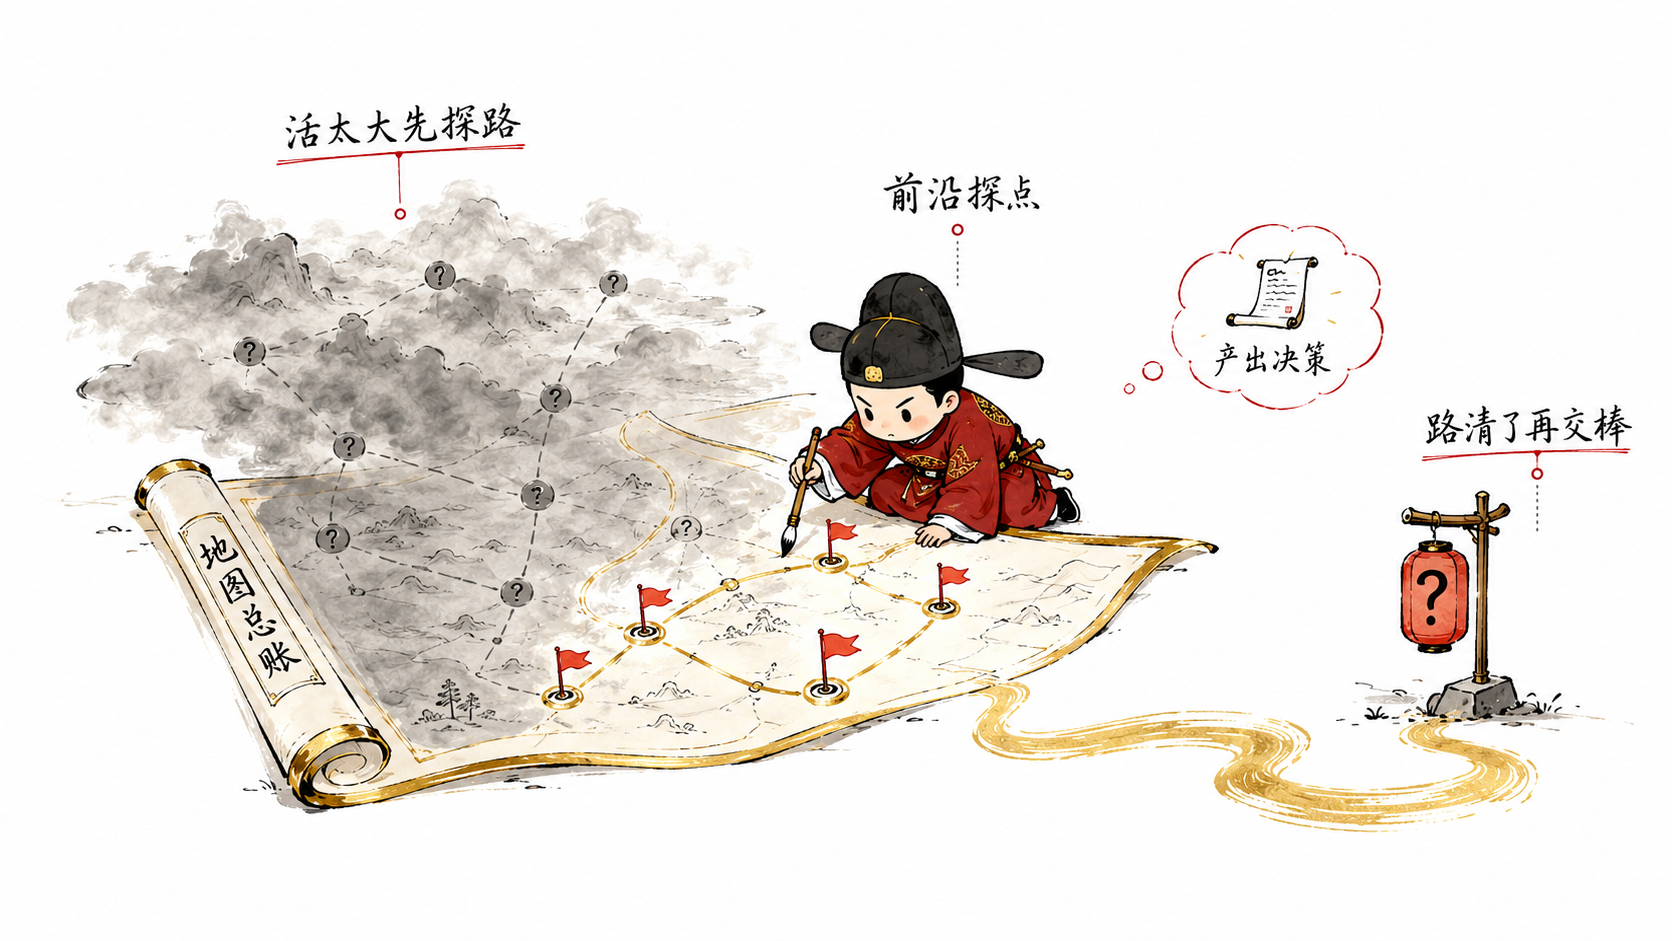
很多人以为
wayfinder替代了grill-with-docs,其实两者互补,wayfinder 在上游:
grill-with-docs处理的是一个会话内、一个已经明确的想法。wayfinder处理的是又大又模糊、一个会话根本装不下的绿地项目或大型功能。wayfinder 怎么干:它在 issue 跟踪器上开一个打着
wayfinder:map标签的"地图"总 issue,把项目笔记、已定决策、仍模糊的部分都记在上面;再把每个待调查的问题拆成带wayfinder:<type>(research / prototype / grilling / task)标签的子 issue,用原生阻塞链接串起依赖。它靠**"前沿查询"**找出"所有前置都已完成、且没人认领"的子任务作为可动手的前沿,Agent 认领→解决→把答案和上下文指针写回地图。wayfinder 的产出是决策,不是交付物——等所有决策都明确、通往目标的路径清晰了,它就把活儿移交给grill-with-docs/to-spec/implement。事实上
grill-with-docs自己会主动向上提示:如果发现工作量太大,请先去用wayfinder推开迷雾。 所以想法越模糊庞大,越该从 wayfinder 起步;想法已经聚焦,直接进 grill。
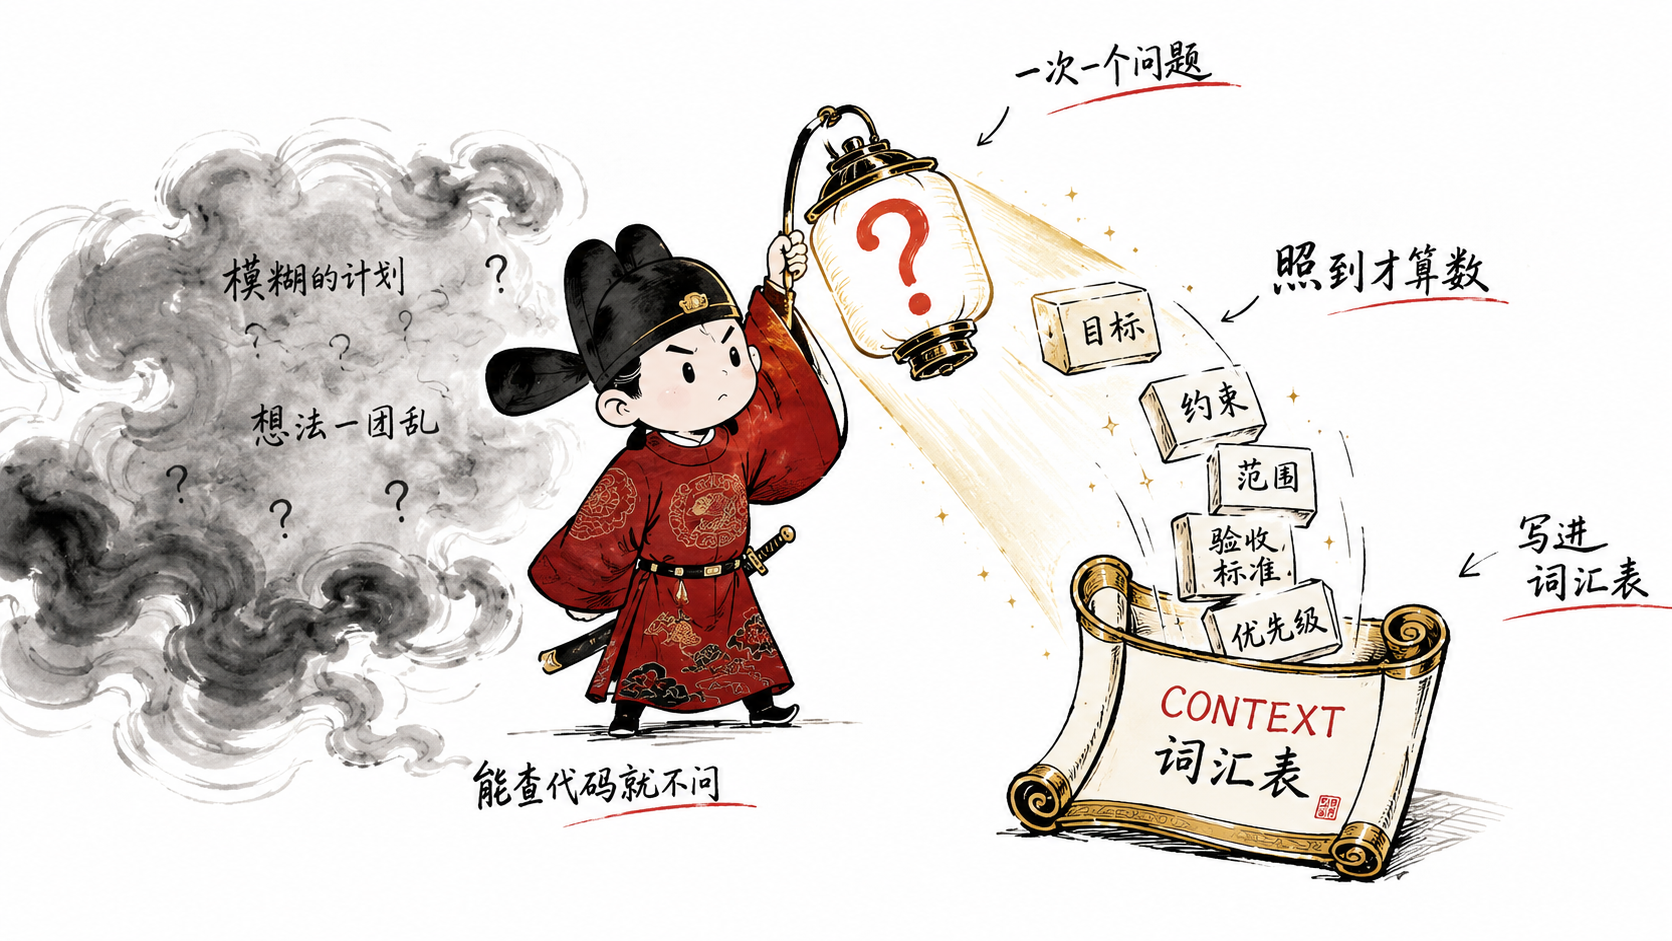
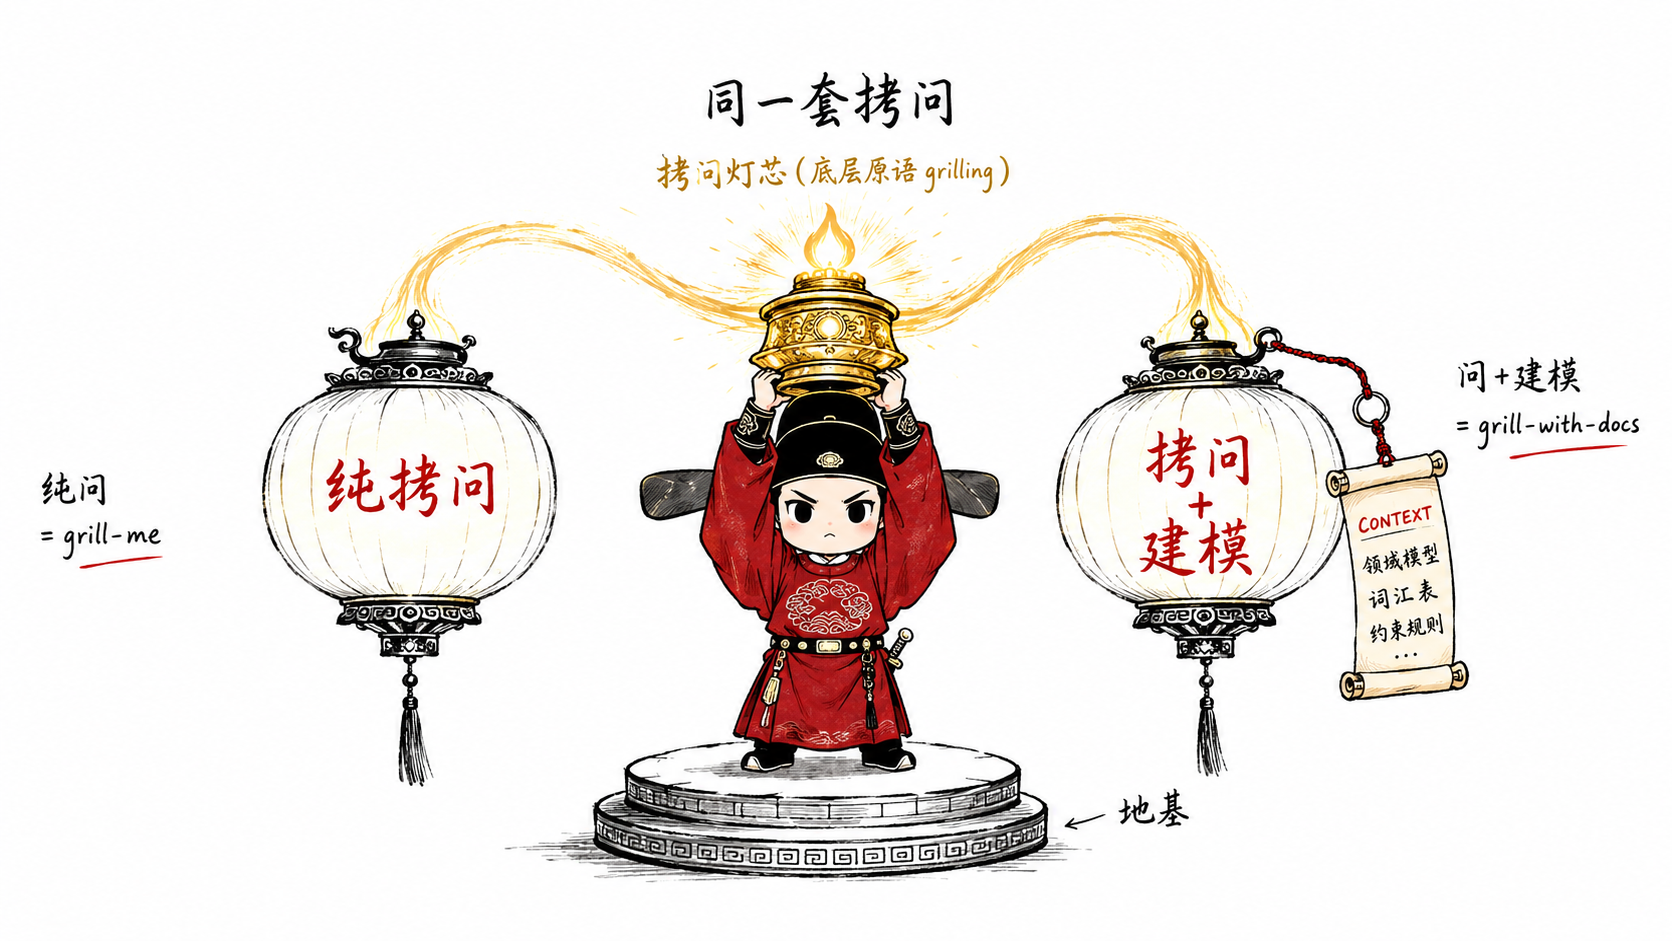
翻开它的 SKILL.md,正文只有一句话:跑一次 /grilling,配合 /domain-modeling。所以 grill-with-docs 本质是两个底层能力的组合——一套无情的访谈循环,加上领域建模。它的角色定位是「拷问一个计划或设计,让它变得锋利」,同时在这个过程里顺手把文档(ADR 和术语表)攒出来。
访谈是一次一个问题地进行的。它像遍历一棵决策树,先解决前置的依赖,再往下走,从不一口气抛给你一堆问题让你无从下手。如果某个答案能从代码库里读出来,它就自己去读,不来占用你的注意力——你只需要回答那些代码回答不了的部分。聊的过程中,你嘴里那些模糊的说法会被逐渐提炼成确定的术语,边聊边写进 CONTEXT.md 的词汇表;而那些难以逆转、又确实是在做取舍的决定,才会被升级成一条 ADR 记录下来。
第二步 · /to-spec —— 把对话凝结成规范
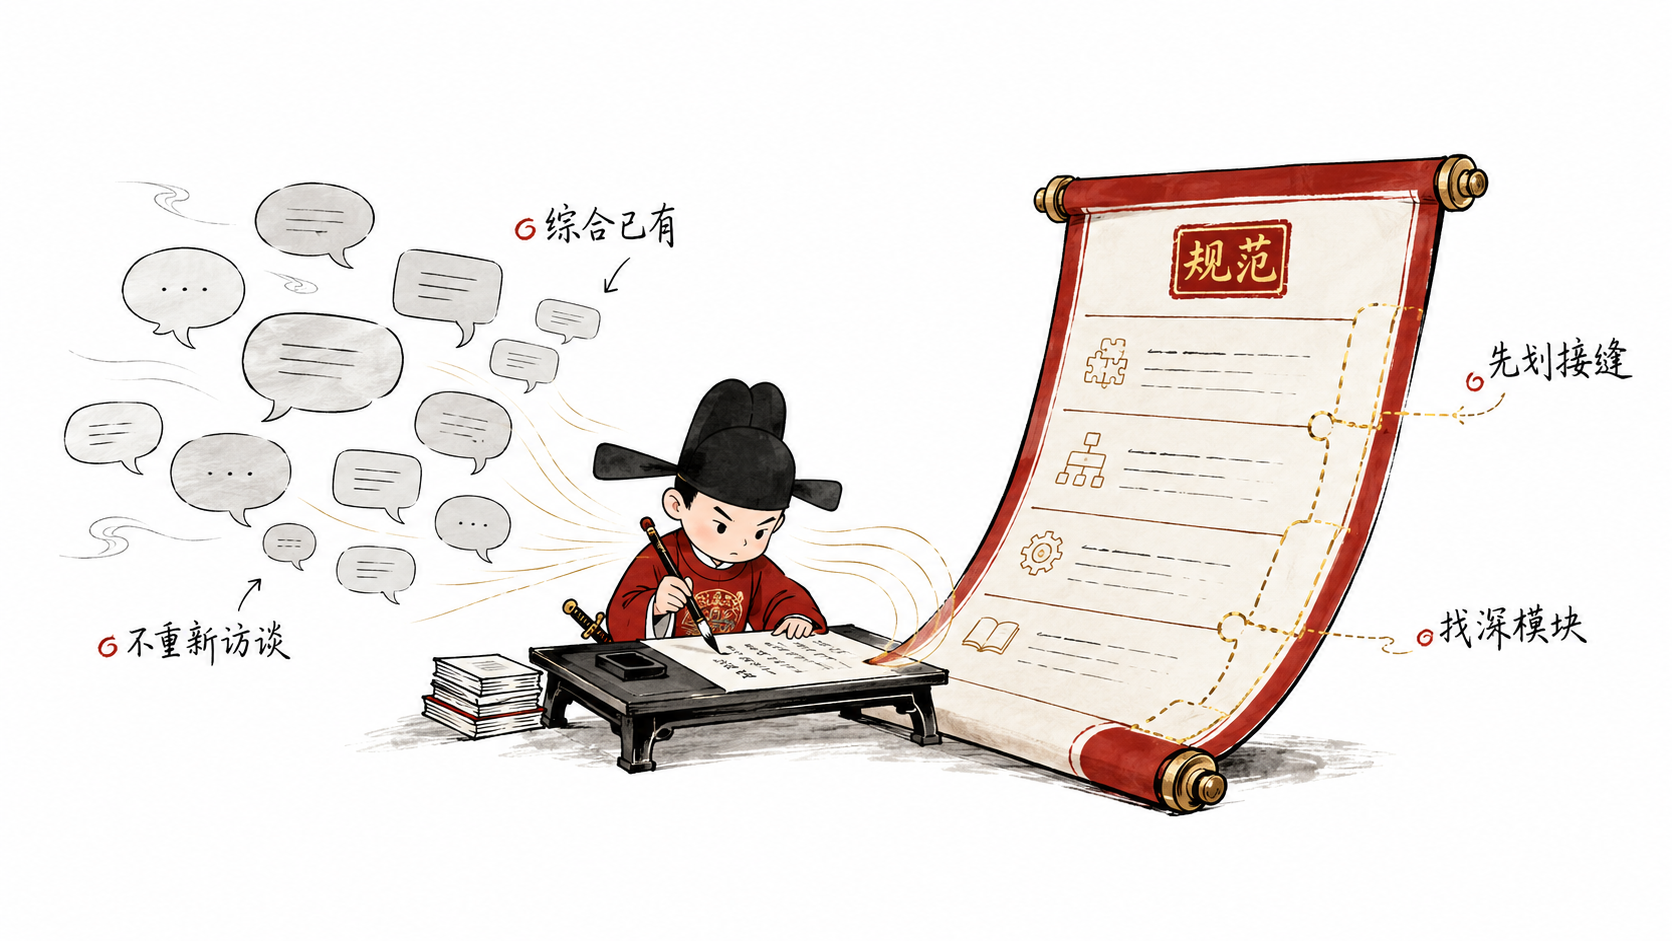
拷问结束,脑子里的东西已经清楚了,接下来该落成白纸黑字。to-spec 干的就是这件事:把当前对话的上下文和它对代码库的理解,综合成一份规范(PRD),发到 issue 跟踪器上。它的 SKILL.md 里有一句很重的强调——不要再访谈用户,只做综合。也就是说该问的问题上一步已经问完了,这一步不重新盘问,只把已有的信息整理成型。
动笔之前,它会先去代码库里转一圈,把上一步沉淀的术语表和 ADR 都读进来。然后做一件关键的事:勾出这个功能将来会被测试的「接缝(seam)」——优先复用已有的接缝,位置尽量往高处放,数量尽量少,最理想是只有一个,定下来之前还会跟你确认。规范本身按固定模板写:问题陈述、解决方案、用户故事、实现决策、测试决策、范围之外、其他备注。写完打上 ready-for-agent 标签发布。整份规范里不写具体文件路径,也不贴代码片段——那些是下游的事。
第三步 · /to-tickets —— 拆成"示踪弹"垂直切片
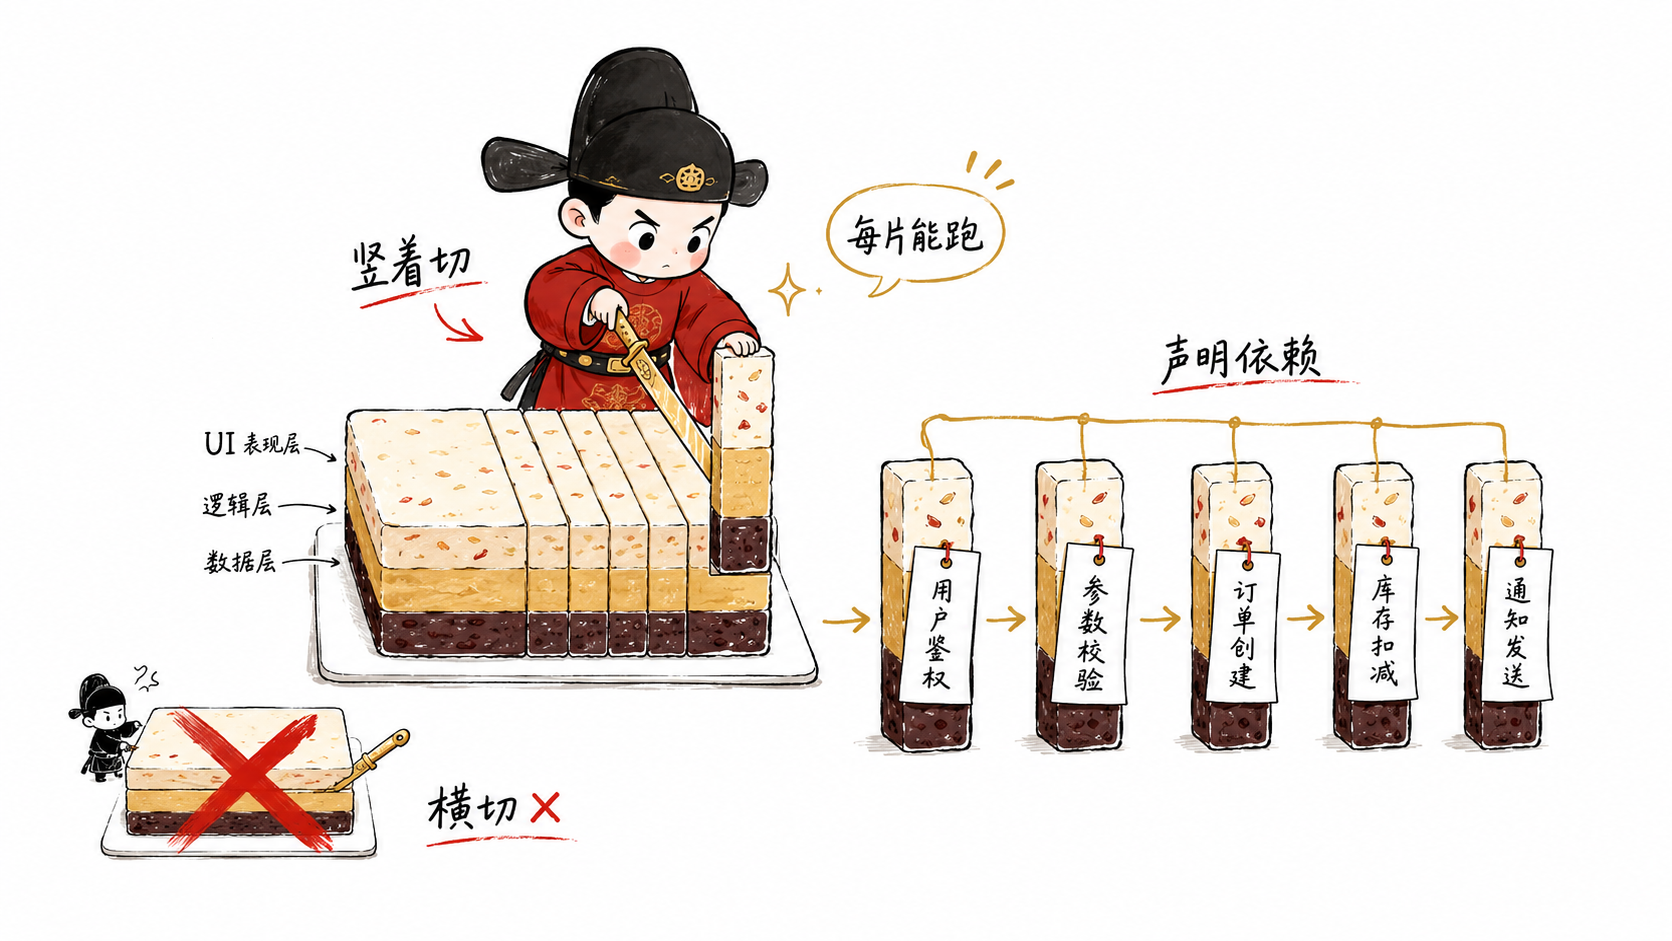
规范写好了,但它还是一整块,没法直接施工。to-tickets 负责把规范、计划、对话拆成一串票据(issues),按依赖顺序发到跟踪器上。它拆的每一张票都不是随便切的,而是一颗「示踪弹(tracer-bullet)」——一条从头贯通到尾的最小垂直切片。票与票之间用阻塞关系(blocking edges)声明先后,谁挡着谁一目了然。
两个术语的解释:"示踪弹"和"垂直切片"
示踪弹原指军队里拖着亮光的曳光弹,打出去能顺着光看到弹道落点。用在软件里,指先做一条从头贯通到尾的最小功能,把整条链路先跑通、可验证,而不是先堆一批彼此看不见的零件。
垂直切片 vs 水平横切,以开发登录功能为例:
- 水平横切:先把所有数据库表建完,再把所有接口写完,最后才拼界面。前两个阶段无法演示,都是半成品,拼合时才暴露不匹配。
- 垂直切片:先只做"用户登录"一个功能,但从数据库、接口、界面到测试一次做通。完成当天即可实际登录、验证跑通。
因此一颗"示踪弹垂直切片"是一个范围窄、但从上到下完整可运行、可当场演示的小功能。后续每颗切片再叠加一条链路,逐步补全系统。
拆票有几条硬规矩:每张票必须是窄而完整的一刀,贯穿 schema、API、UI、测试所有层,而不是只做某一层的水平横切;每张票都得能单独演示验证;粒度要小到能塞进一个上下文窗口里做完。真要动到大范围的重构,它不会硬拆,而是走「扩展-收缩(expand-contract)」——先加新的、让改动变容易,再动手改,最后把旧的收掉。拆的过程中它还会反过来盘问你,确认粒度和边界对不对。全部拆完按依赖顺序发布,这样每张票的「Blocked by」都能指到一张真实存在的票上。用 Kent Beck 那句话说:先让改动变容易,再去做那个容易的改动。
第四步 · /implement —— 照着票据,TDD 把它造出来
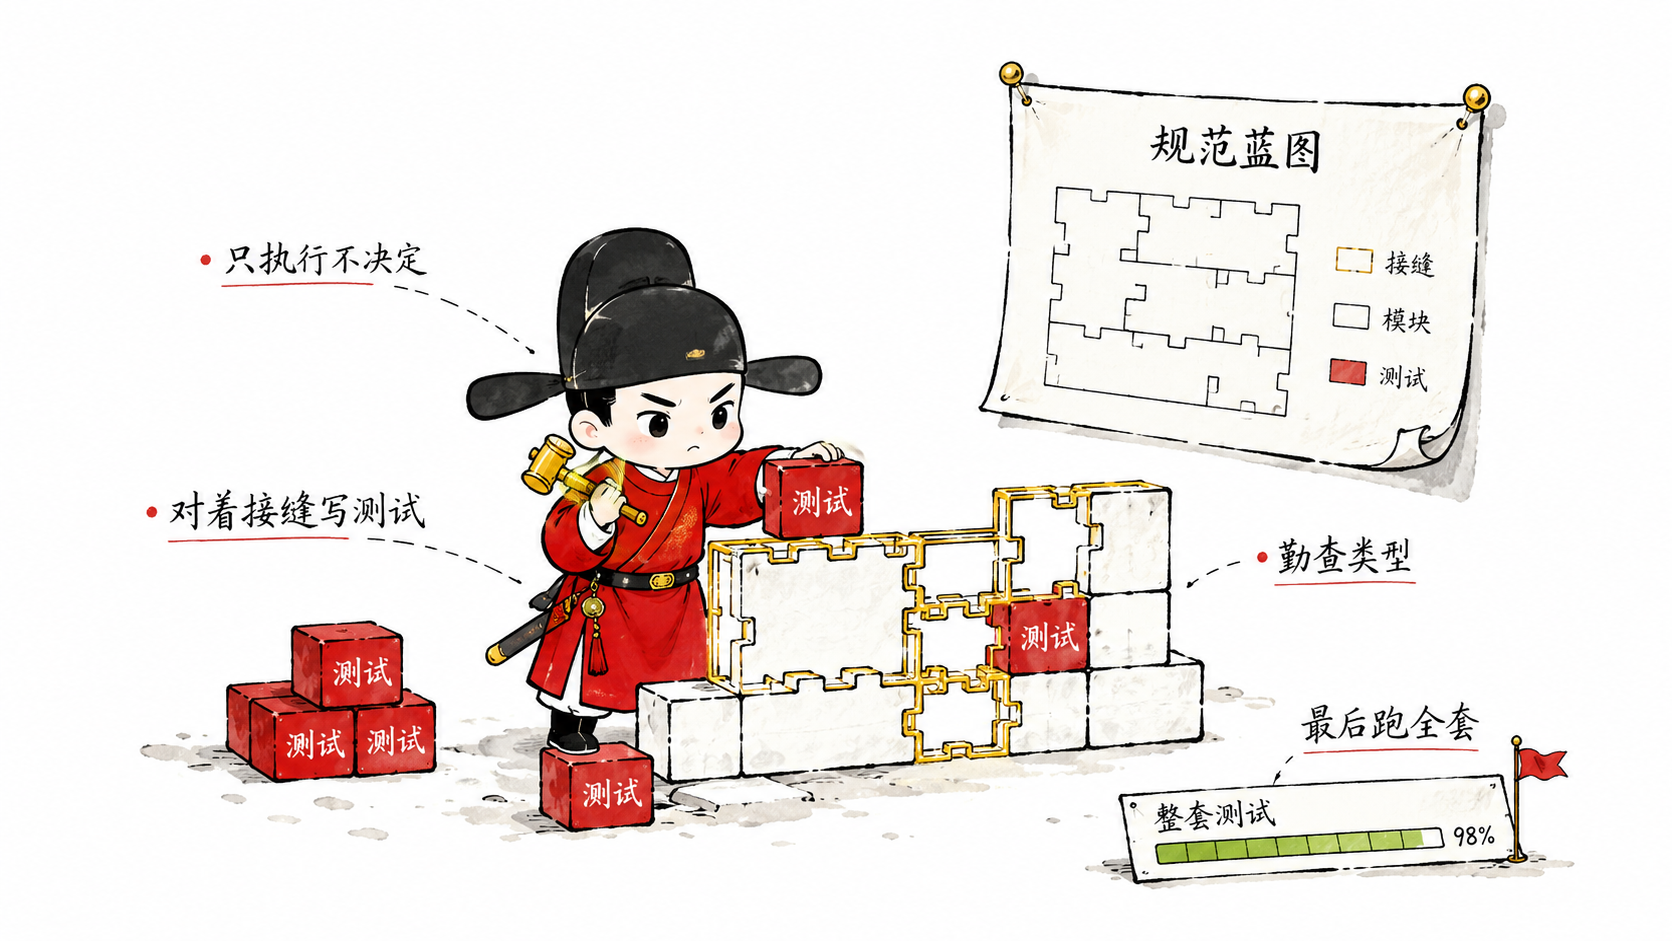
到这一步才真正开始写代码。implement 的定位很清楚:它不决定做什么,只执行已经定好的计划。前面三步已经把「做什么」敲定了,它照着票据和规范施工。SKILL.md 里把节奏也写死了:能用 TDD 的地方就用 /tdd,而且只在事先约好的接缝上写测试;类型检查要频繁跑,单个测试文件时不时跑一遍,整个测试套件留到最后跑一次。写完之后它会自己调 /code-review 过一遍,再把成果提交到当前分支。
第五步 · /code-review —— 双轴并行评审
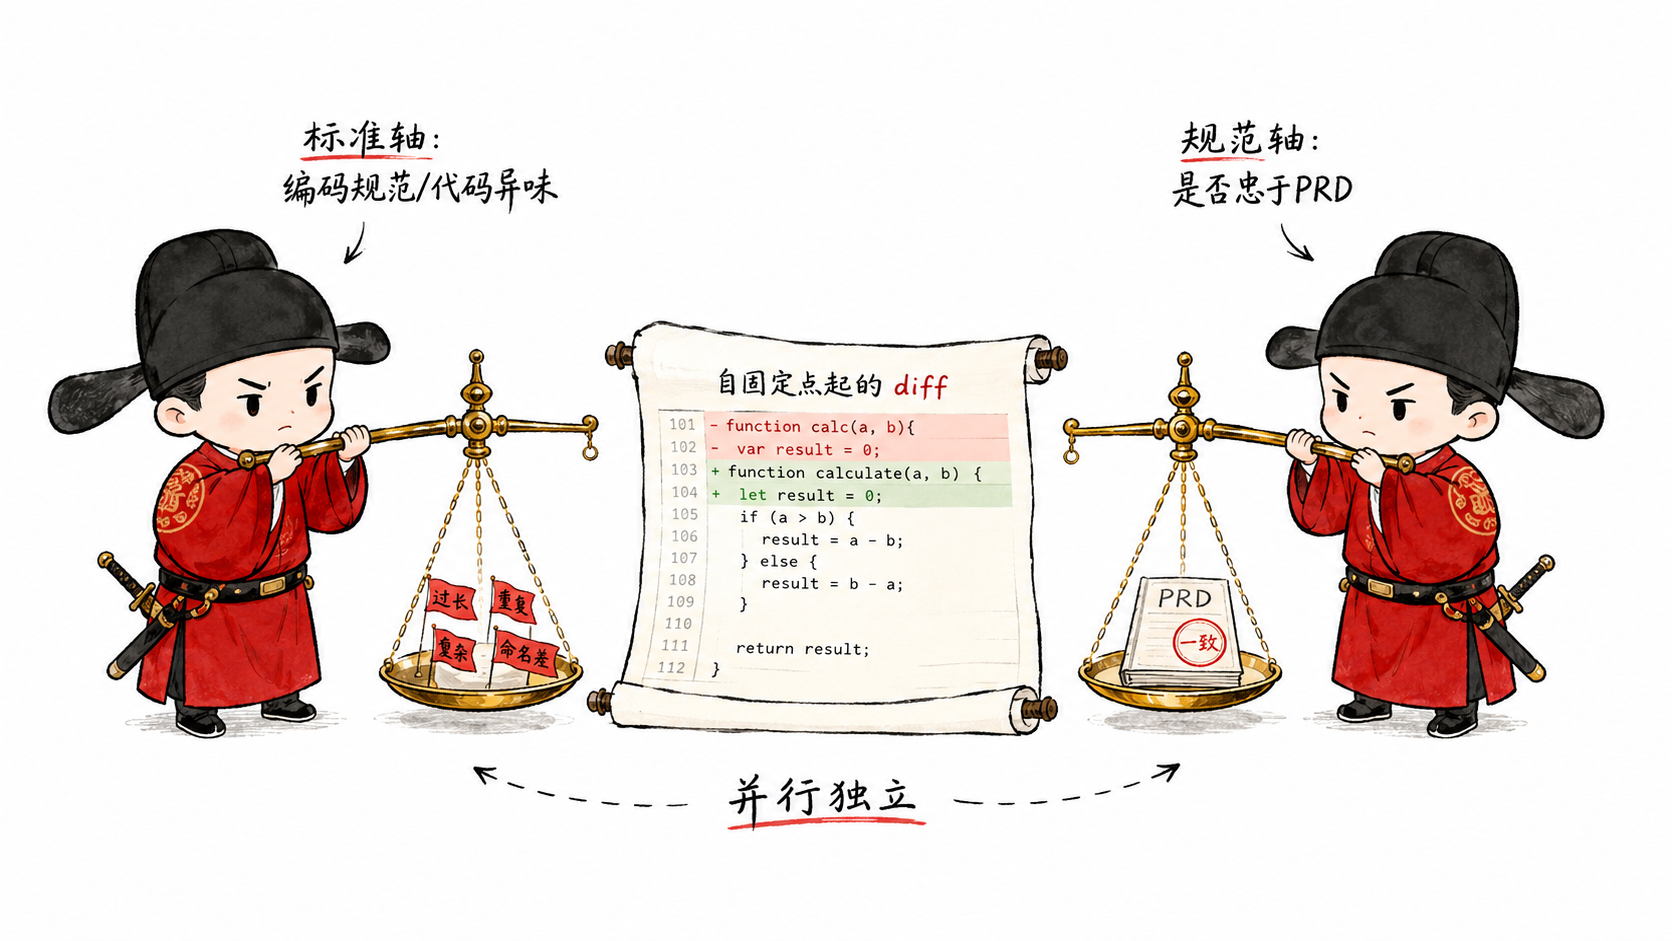
最后一步是审。code-review 拿「自某个固定点以来的 diff」(git diff <固定点>...HEAD)来审,但它审两遍——两条轴分别派一个子 Agent 并行去跑,互不干扰,跑完各自出结果,不合并也不重新排序。
第一条是标准轴(Standards),看代码守不守仓库自己的编码规范,底子上还挂着 Fowler 的十二种代码异味清单:神秘命名、重复代码、特性依恋、数据泥团、基本类型偏执、重复的 switch、霰弹式修改、发散式变化、夸夸其谈通用性、消息链、中间人、被拒绝的遗赠。仓库自己的规范优先级高于这套基线,而每一种异味都是需要判断的,不是机械报错。第二条是规范轴(Spec),只看一件事:代码有没有忠实实现最初那个 issue 或 PRD——是漏了、还是多做了跑偏了、还是做错了,避免实现着实现着就偏离了目标。两条轴各管各的,正因为分开,才不会让「代码写得漂不漂亮」盖过「做的是不是该做的事」。
小结:这条主线的设计逻辑
| 步骤 | 命令 | 一句话 |
|---|---|---|
| ① 拷问 | /grill-with-docs |
一次一个问题逼透想法,实时写 CONTEXT.md / ADR |
| ② 规范 | /to-spec |
不重新访谈,综合已有信息成 PRD,先划接缝找深模块 |
| ③ 票据 | /to-tickets |
拆成示踪弹垂直切片(issues),声明依赖按序发布 |
| ④ 实现 | /implement |
只执行不决定,围绕接缝 TDD,勤查类型跑全套 |
| ⑤ 评审 | /code-review |
双轴并行:标准(异味)× 规范(是否忠于 PRD) |
这条主线的核心是把"想清楚"和"写代码"分成两段。 前三步不写代码,只做认知对齐(拷问→规范→票据);后两步才动手,实现完成后立即用双轴评审校验。想法越模糊,越应从 /grill-with-docs 起步,而非直接开工。 |
番外:productivity 分类——不写代码,但让你想得更清、传得更顺
除 engineering 外,README 里还有一类 productivity。它们不产出代码,面向通用工作流,解决想不清、接不上、教不会这三类问题。
用户主动调用的(User-invoked)
| Skill | 一句话 |
|---|---|
grill-me |
被无情连环追问一个计划/设计,直到决策树每个分支都有答案 |
handoff |
把当前对话压成一份交接文书,让下一个 Agent 无缝接手 |
teach |
跨多次会话教你一个新技能,把当前目录当作有状态的教学工作区 |
writing-great-skills |
写好、改好 skill 的参考:让一个 skill 可预测的词汇与原则 |
| 模型自己会调的(Model-invoked) |
| Skill | 一句话 |
|---|---|
grilling |
无情访谈的可复用底层循环,grill-me 和 grill-with-docs 都建在它之上 |
这里有一处呼应:主线第一步的 grill-with-docs,本质是 grilling 这套"拷问循环"原语加上领域建模的组合。拷问是这套方法论的地基——先把需求问透,再进入编码。 |
handoff 与主线首尾相接:当一条流程在单个会话内跑不完、需要换 Agent 接力时,handoff 把上下文压成交接文书(并附一段"下一步建议调用哪个 skill"),下一个 Agent 读完即可从断点续上。其他工程类 skill 也会复用它。
仓库地址:https://github.com/mattpocock/skills
另外仓库里还有个ask-matt路由技能,会根据你当前处境帮你挑该用哪条工作流。
