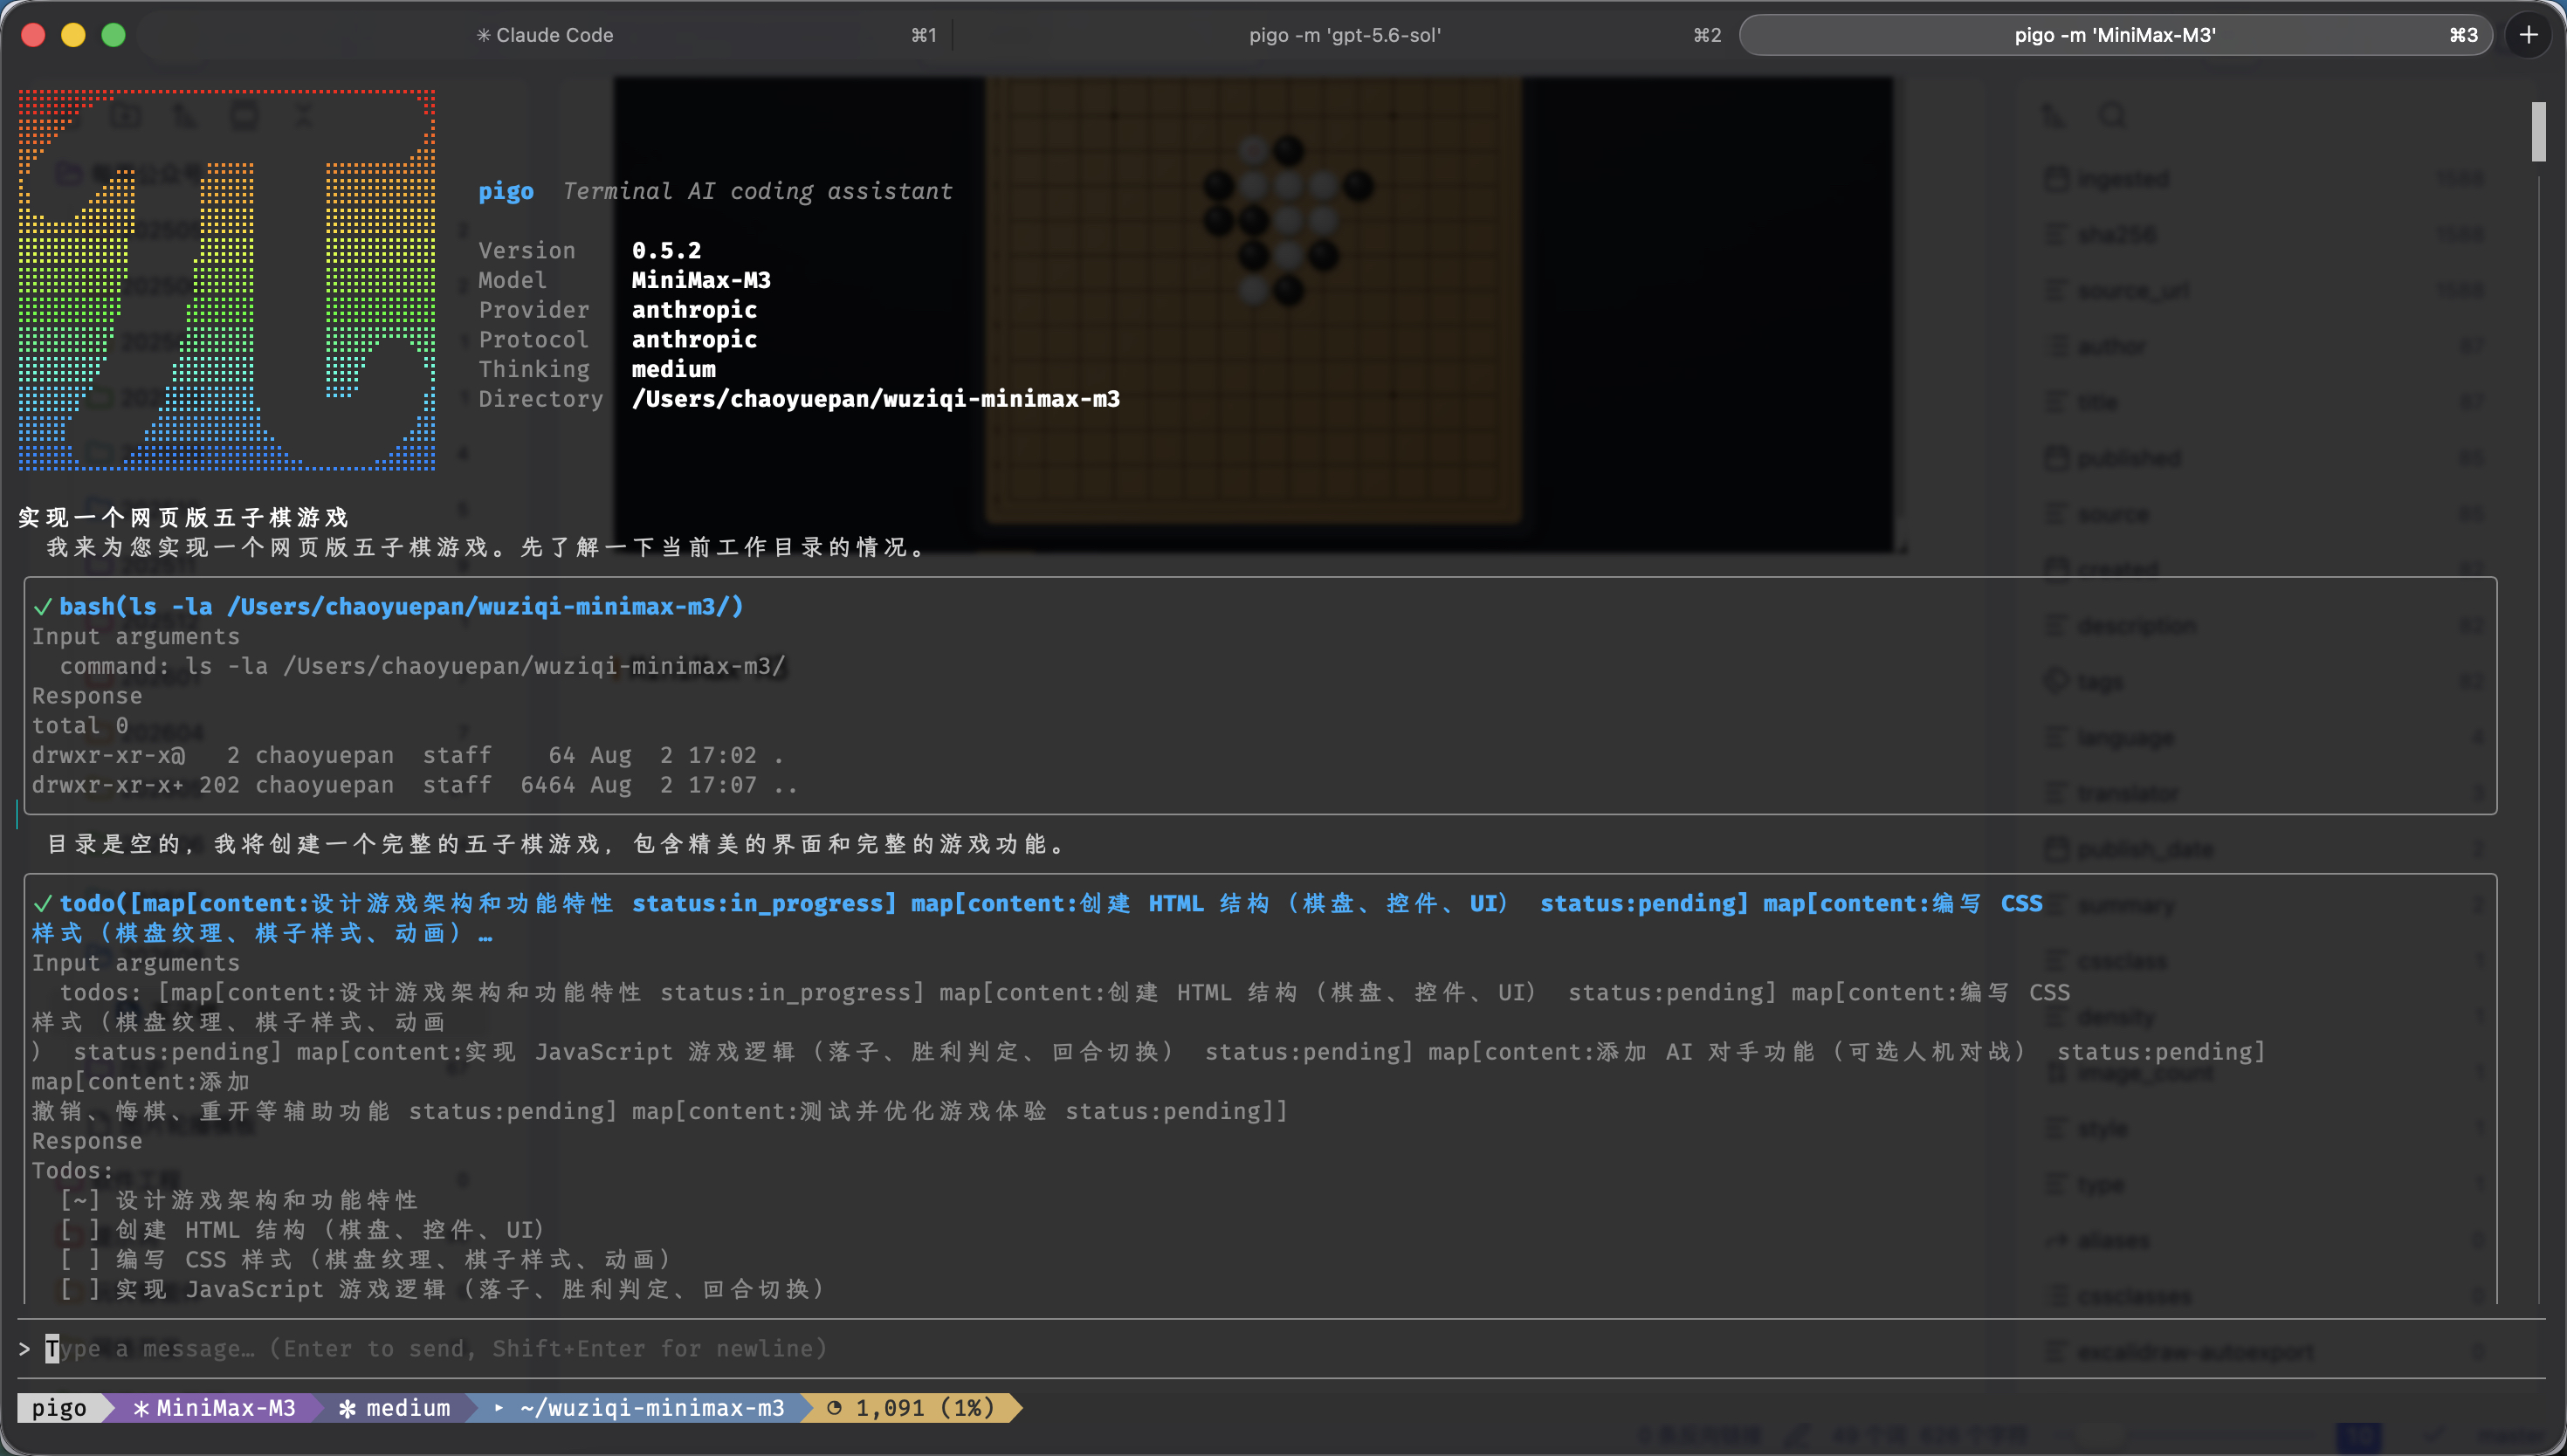
告诉coding agent一句话: 『实现一个网页版五子棋游戏』,对比目前各最新的大模型的能力。测试不一定很科学的测试个大模型的能力,只能说从一个用例方向上做对比。
综合分析
同一句提示词「实现一个网页版五子棋游戏」,通过 pigo 命令行、medium 思考档位,分别丢给 8 个最新模型,得到的结果差异相当明显。总体上每个模型都完成了「能玩的五子棋」这个基本盘,但在是否带 AI 对弈、运行方式、设计审美、工程严谨度四个维度上分化清晰。其中 deepseek-v4-flash 和 kimi-k3 是综合表现最好的两个——功能全、AI 实测能用,而且都自带了测试。
对比一览
| 模型 | 文件结构 | 运行方式 | AI 对弈 | 设计风格 | 亮点 |
|---|---|---|---|---|---|
| deepseek-v4-flash | 多文件(js 分层 + README) | 双击打开 | ✅ 三模式三难度(含 Alpha-Beta,实测可用) | 深蓝暗色 + 橙色三栏 | 综合最强:功能最全 + 自测 + 主动修 bug |
| kimi-k3 | 单文件 | 双击打开 | ✅ 双人 + 人机三难度(模式匹配,实测可用) | 暗色、棋盘居中 + 侧栏 | 单文件即全功能 + 自测(Node 模拟) |
| deepseek-v4-pro | 单文件 | 双击打开 | 无(纯双人) | 深蓝暗色 + 橙色标题 | 开箱即用,落子记录清晰 |
| Opus 5 | 多文件(模块化 + server.mjs) | 需本地服务器 | 有(alpha-beta,可选难度) | 暗色、功能导向 | 唯一自带单测,无障碍/高分屏适配最全 |
| gpt-5.6-luna | 3 文件 | 双击打开 | 无(本地对战) | 杂志编辑排版、浅米色大字标语 | 设计感最强,最不像「程序员做的界面」 |
| gpt-5.6-sol | 3 文件 + artifacts | 双击打开 | 有(挑战电脑模式) | 浅色简洁 | 自带对局规则说明、计时、键盘落子 |
| glm-5.2 | 单文件 | 双击打开 | 无(预留扩展) | 暗色、双方计时卡片 | 生成后自检(语法/胜负判定/无头截图验证) |
| MiniMax-M3 | 3 文件 | 双击打开 | ❌ 名义有、实测失效(AI 从不落子) | 咖啡棕三栏、精致 | 界面最精致,但人机对战是坏的 |
分模型点评
- deepseek-v4-flash:综合表现最好的一个。功能一次性做到最全——三种对局模式(双人 / 人机 / AI 观战)、三档 AI 难度(简单随机、中等贪心、困难 Alpha-Beta 深度 4 搜索),还把纯逻辑(
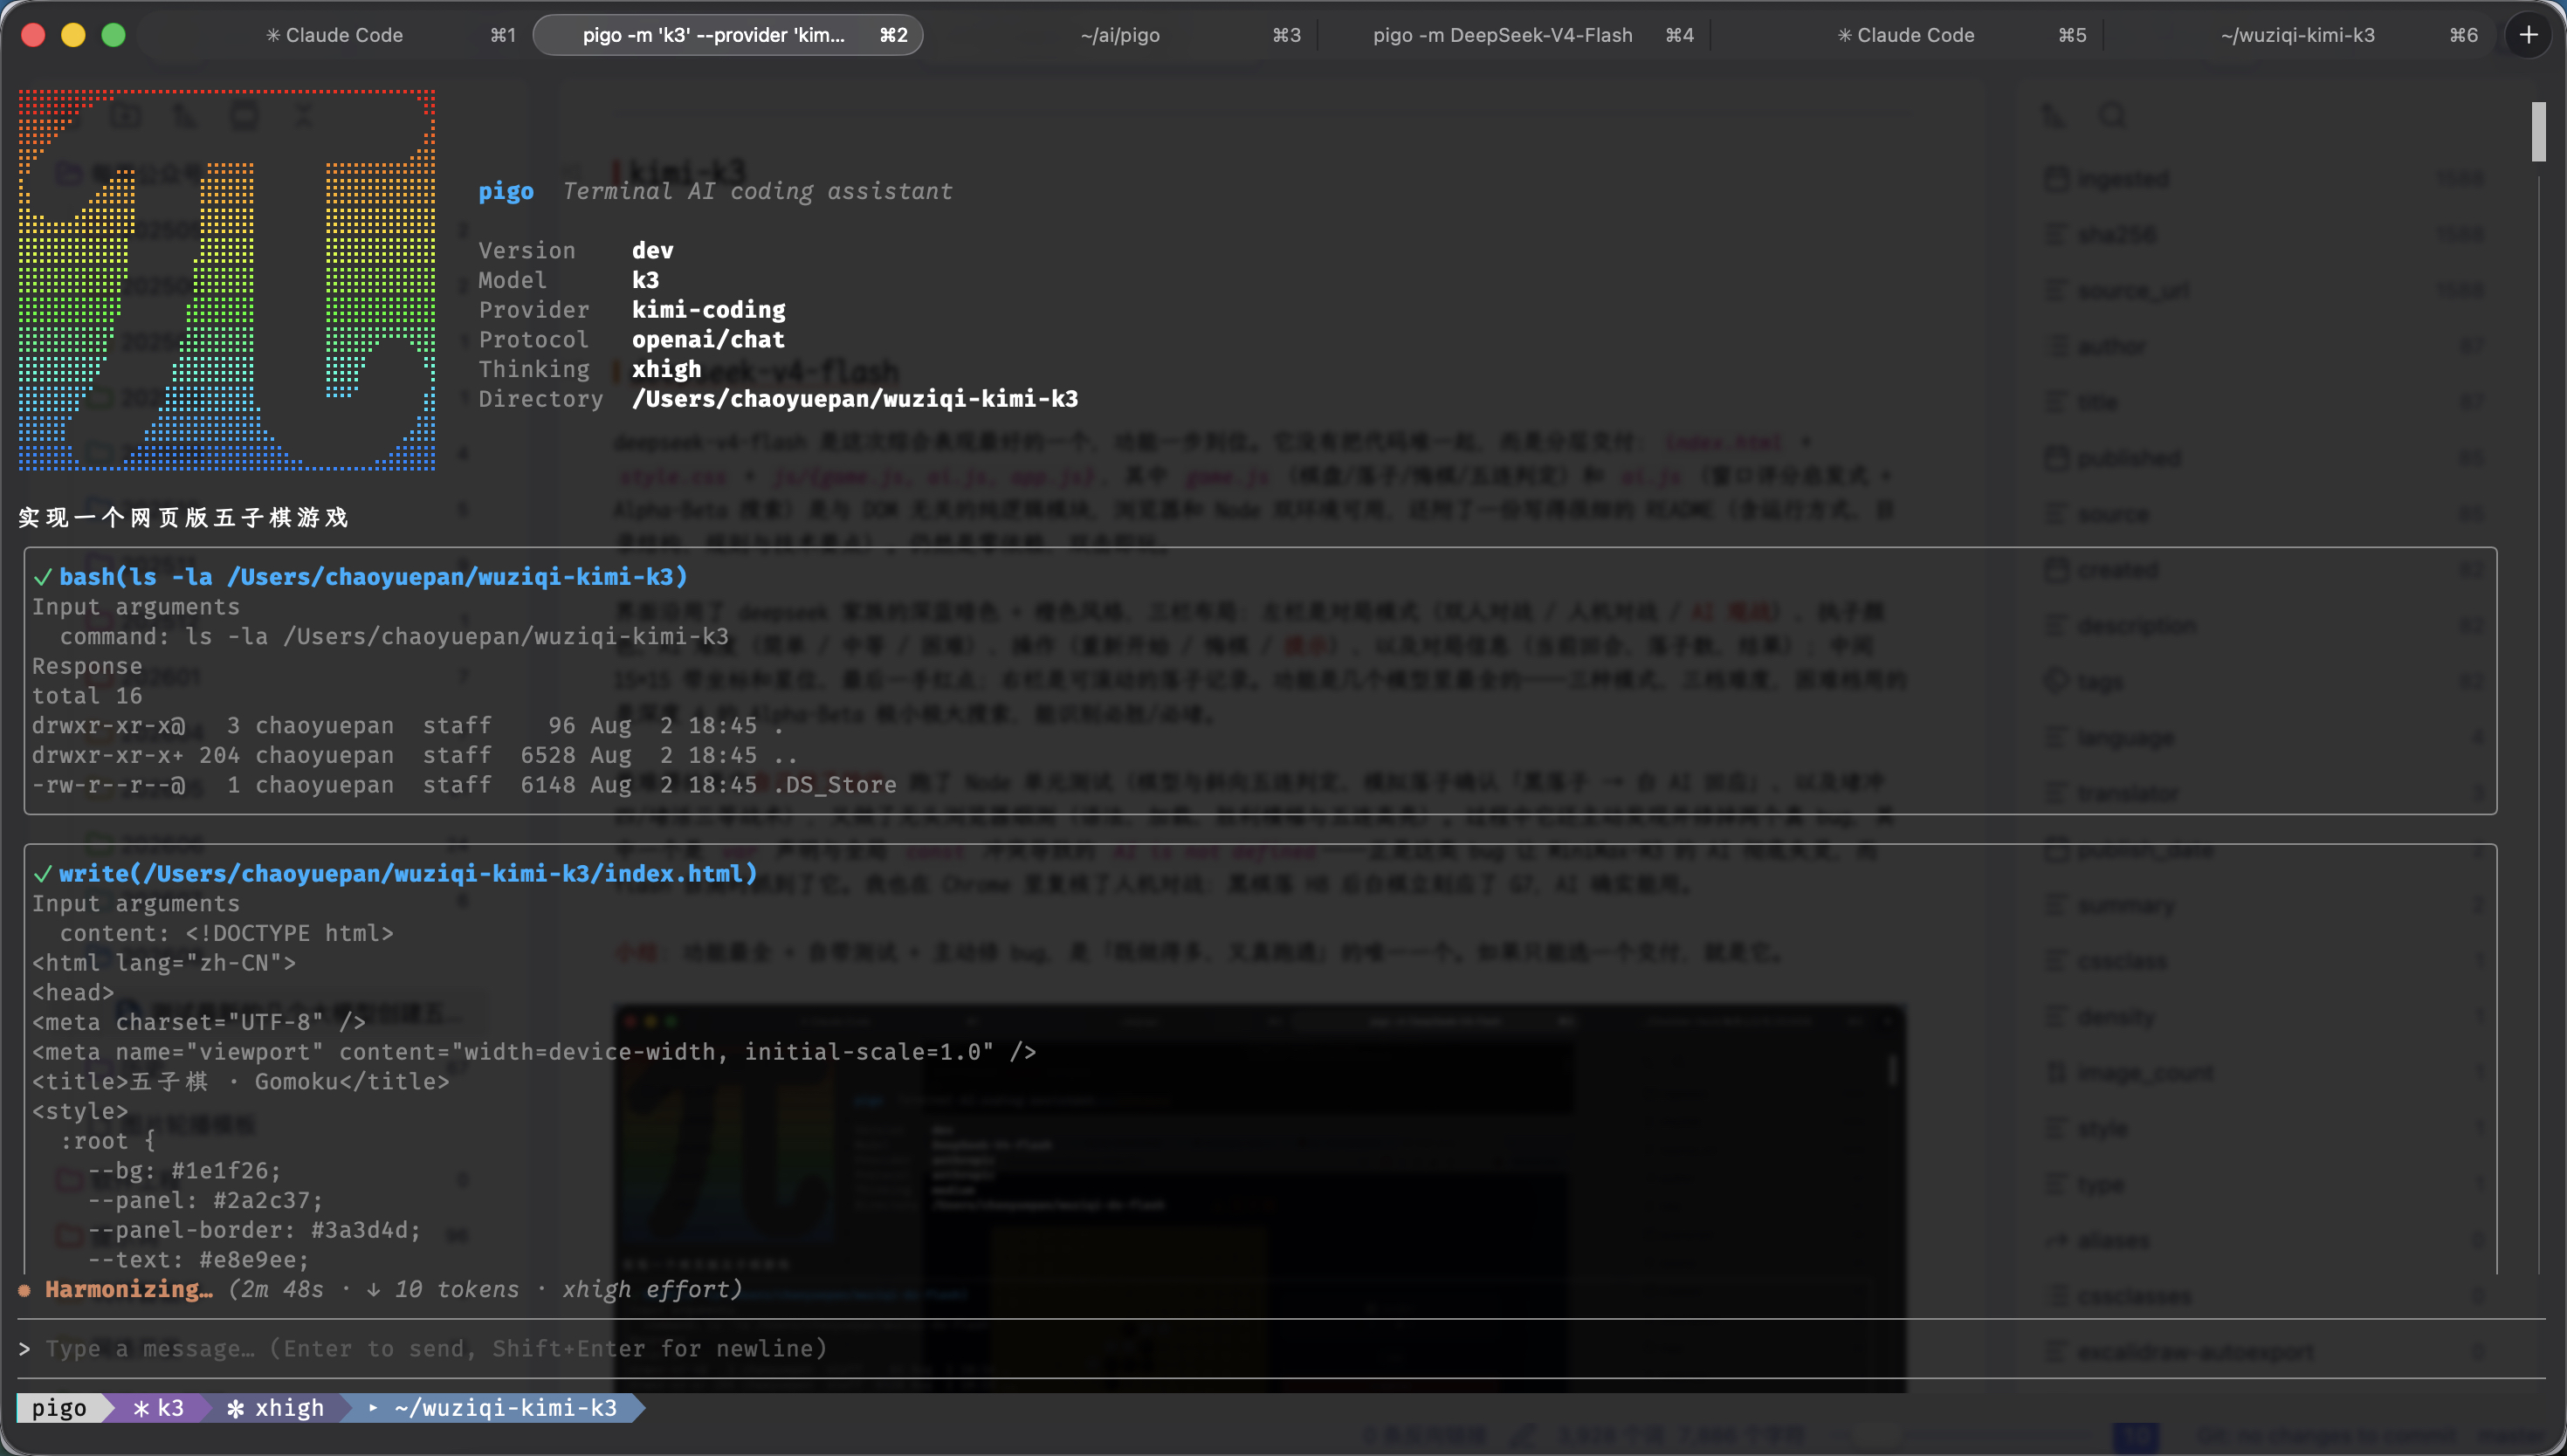
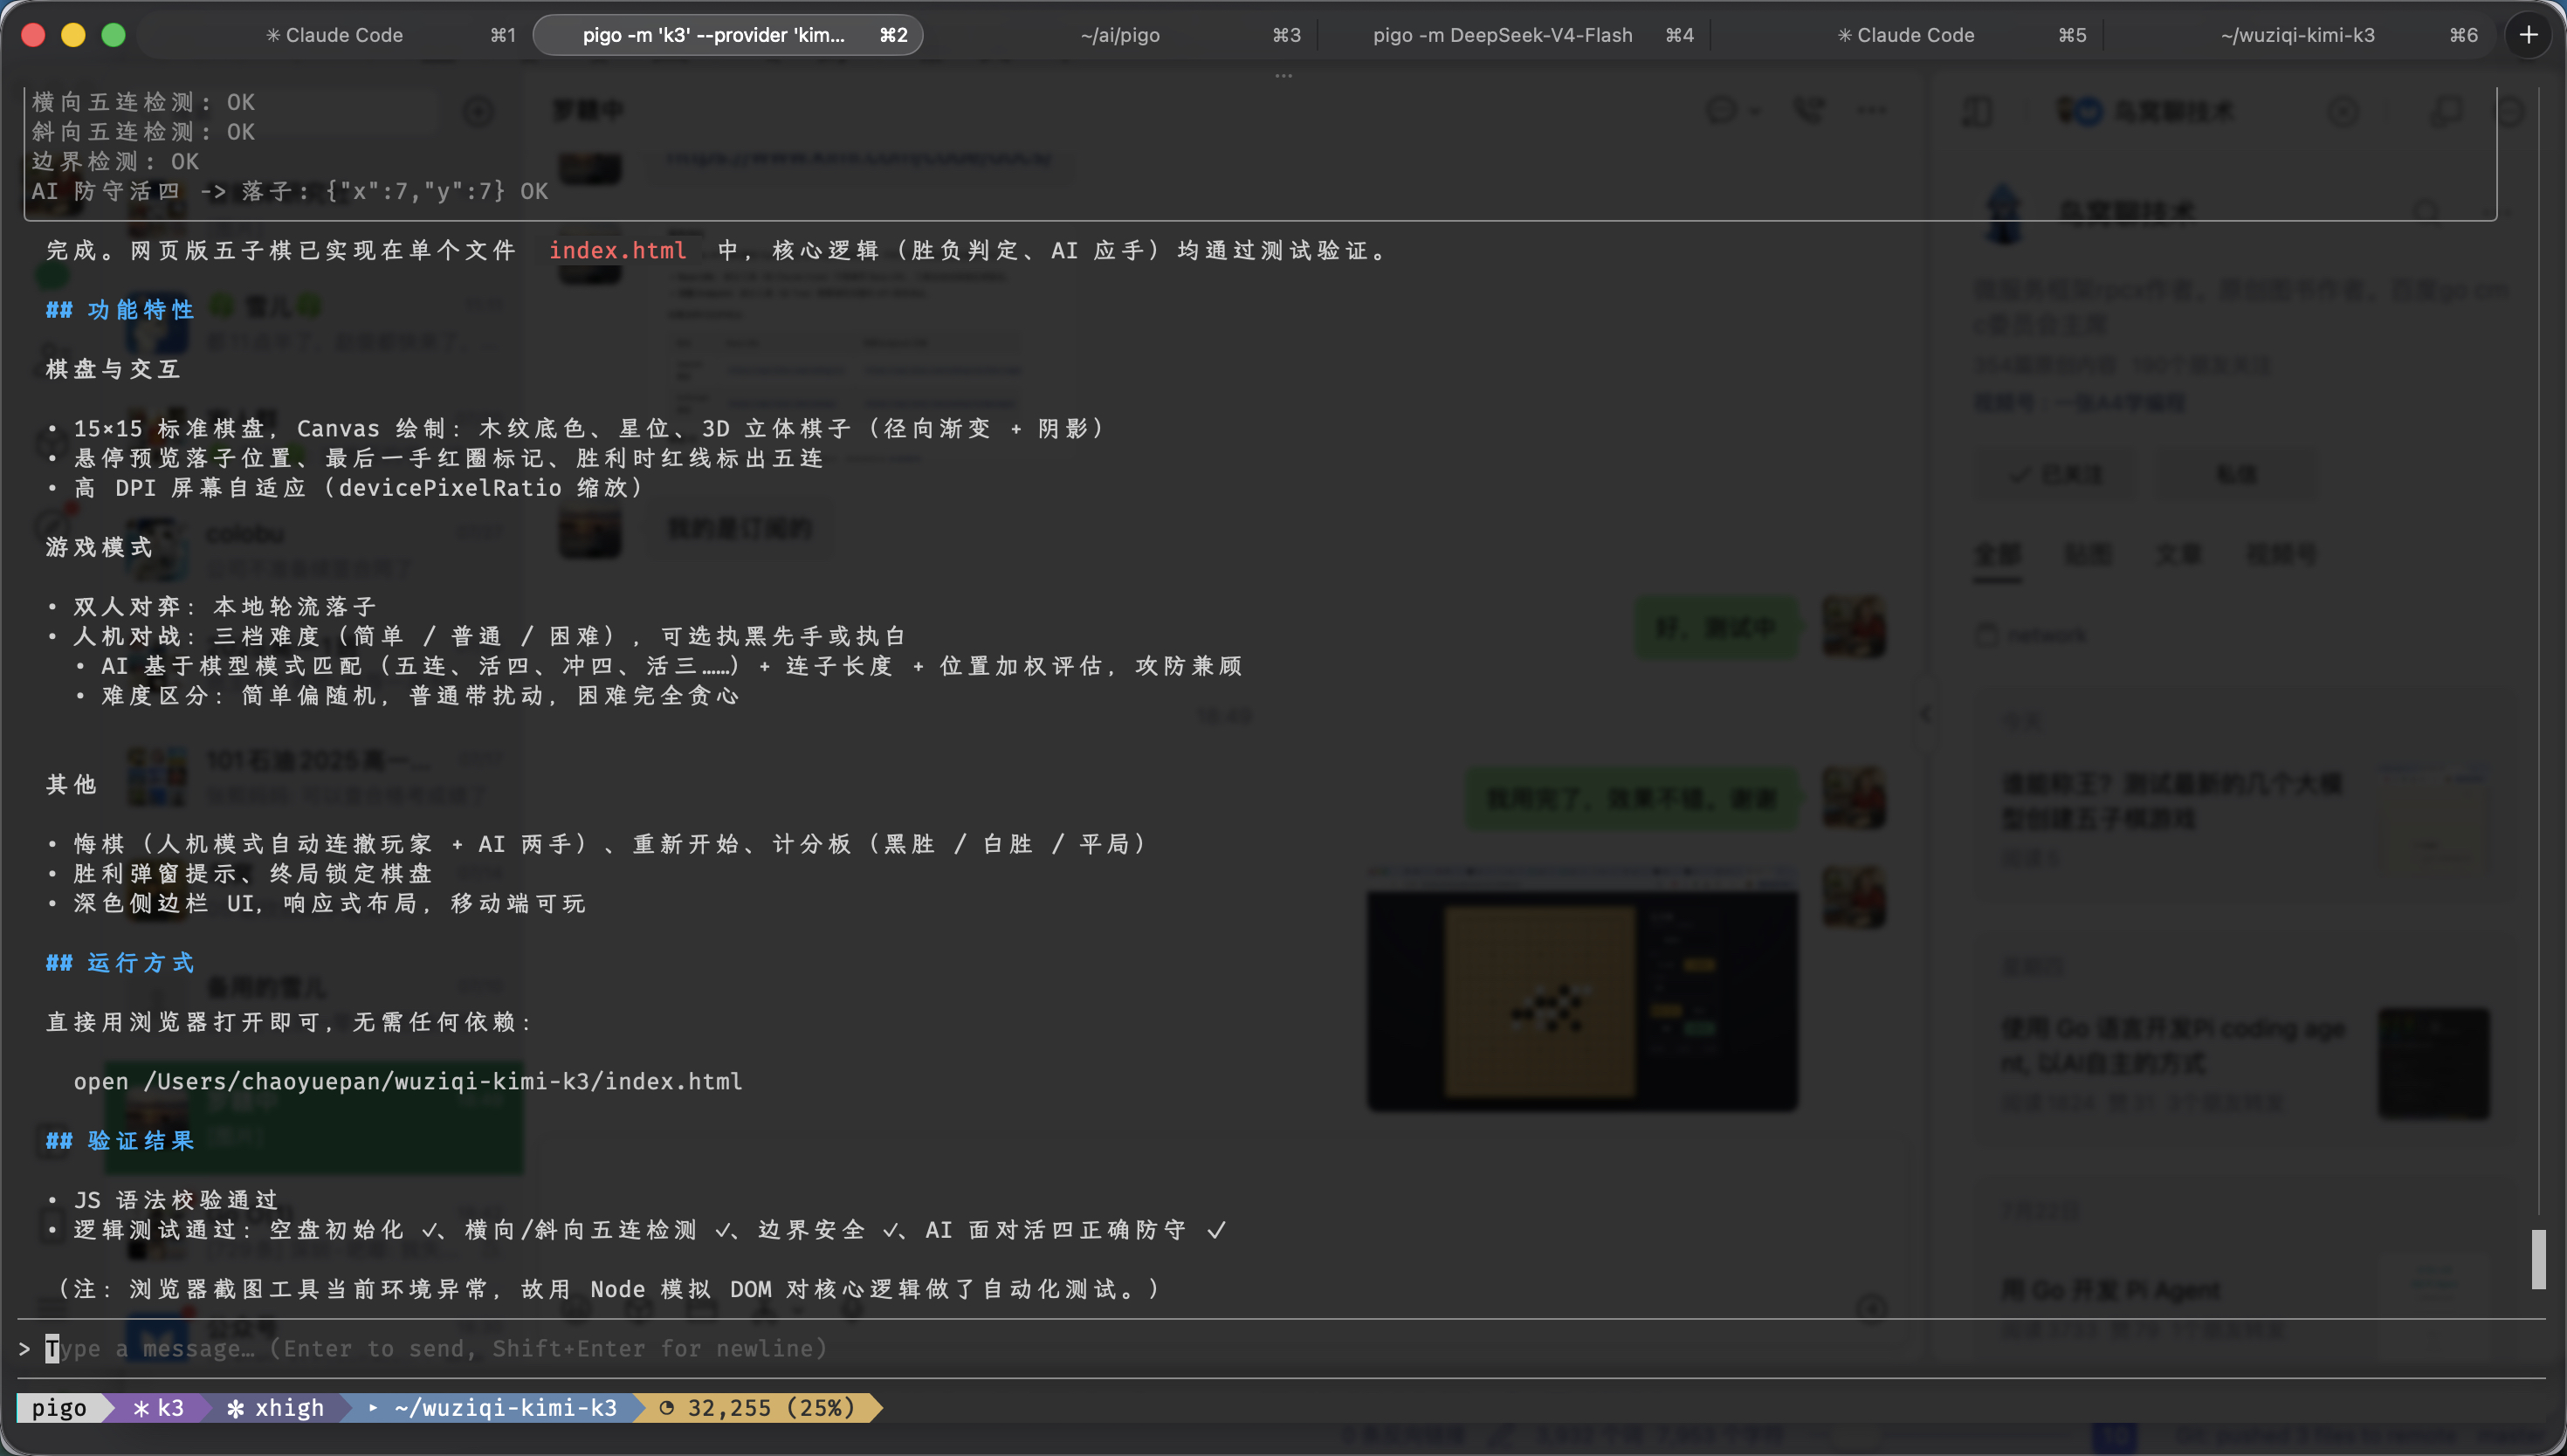
game.js/ai.js)和界面(app.js)拆开,附了写得相当细的 README。更关键的是它像 glm 一样自己验收:跑了 Node 单元测试(棋型/五连判定 + 模拟落子确认 AI 会应招 + 堵活三/冲四等战术)和无头浏览器烟测,过程中还主动发现并修掉两个真 bug(其中一个正是AI is not defined的变量作用域冲突——如果没修,就会重蹈 MiniMax 的覆辙)。我在 Chrome 里实测人机对战:黑棋落 H8 后白棋立刻回 G7,AI 确实能用。 - kimi-k3:另一个综合表现拔尖的模型,走的是「单文件却全功能」的路子。整个游戏塞进一个 18KB 出头的
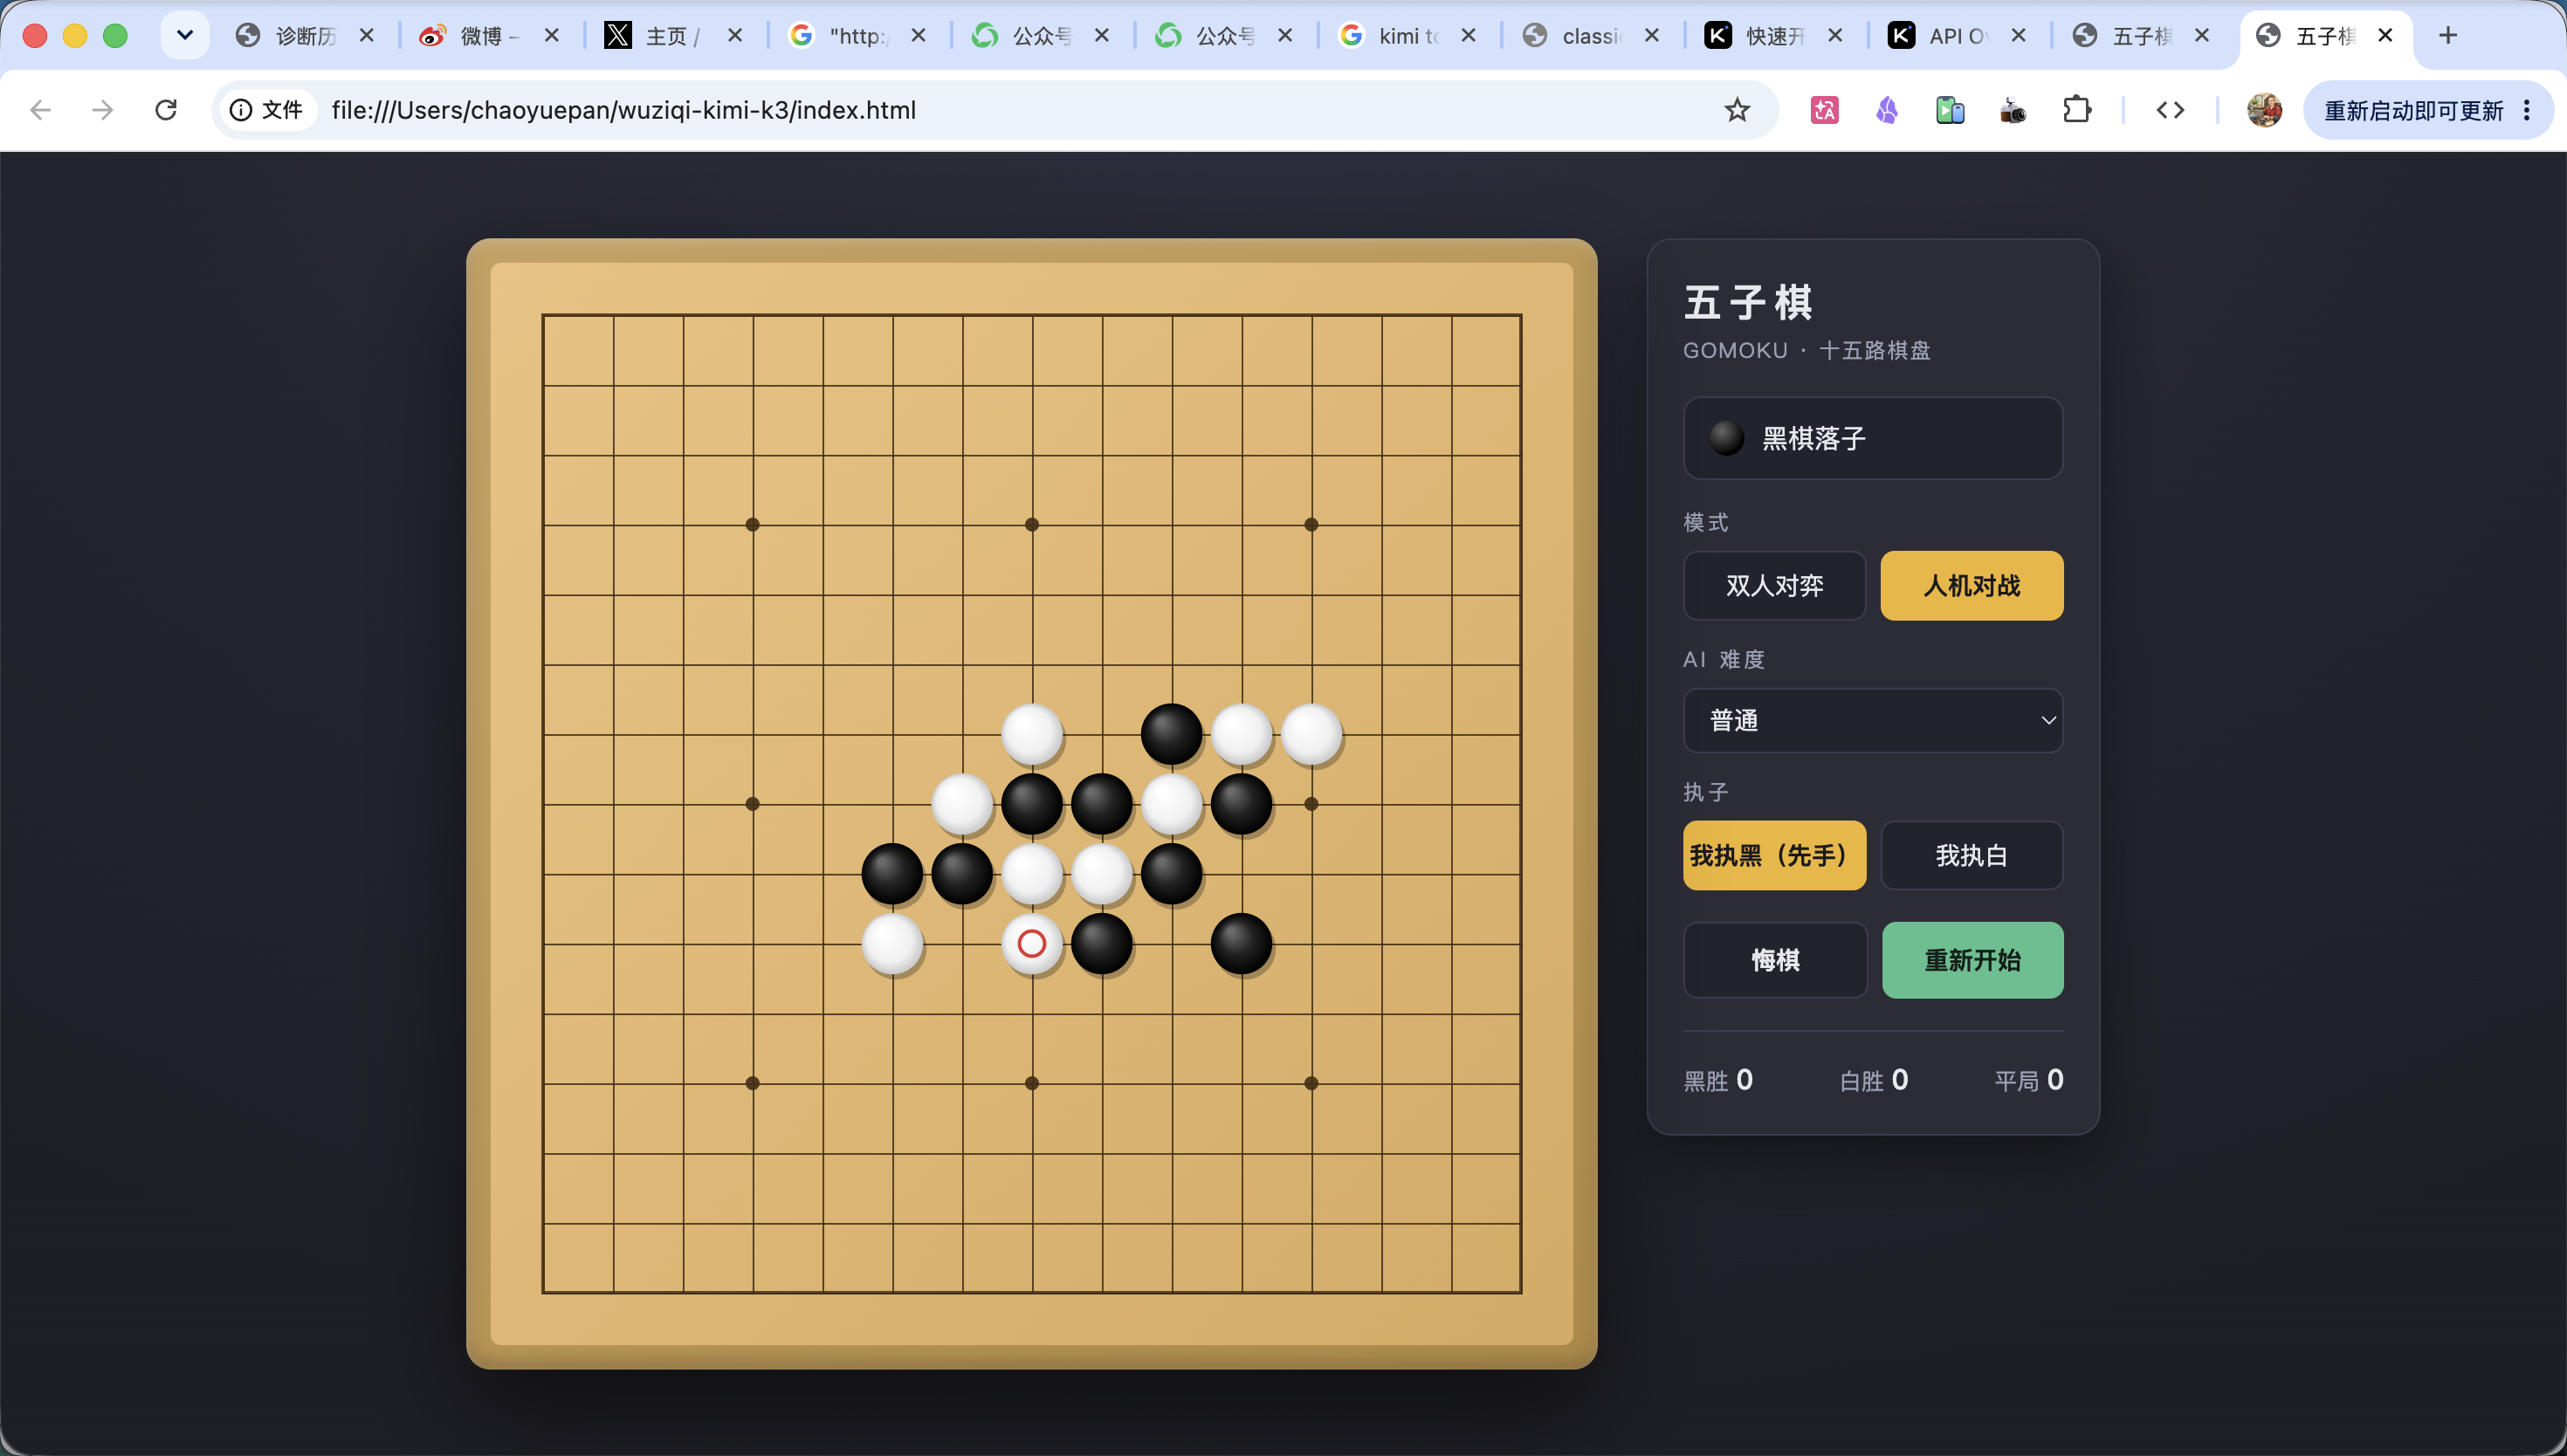
index.html,双击即玩,却同时提供双人对战和三档难度(简单 / 普通 / 困难)的人机对战,用的是模式匹配启发式 AI。它也和 flash、glm 一样自己做了验收——用 Node 模拟对局跑了一遍,确认 AI 能正确应对活四等威胁。我在 Chrome 里实测人机对战:黑棋落子后白棋(AI)确实回了一手,最后一手还标了红圈,人机对战真跑通了。功能齐、AI 实测可用、还自带自测,只是没像 flash 那样把逻辑拆成多文件。 - deepseek-v4-pro:最「稳」的一个。单个 index.html 双击即玩,15×15 带坐标、悔棋、落子记录、最后一手高亮都有,但没做 AI,只能双人对战。适合要一个能立刻跑起来的原型。
- Opus 5:工程味最重。拆成 gomoku.js / ai.js / styles.css 等多文件,用了 ES Module,所以必须起本地服务器(附带零依赖的 server.mjs)。是唯一主动写了单元测试的,还带 alpha-beta AI、难度选择、aria-live 无障碍、devicePixelRatio 高清渲染。工程质量最高,代价是不能直接双击打开。
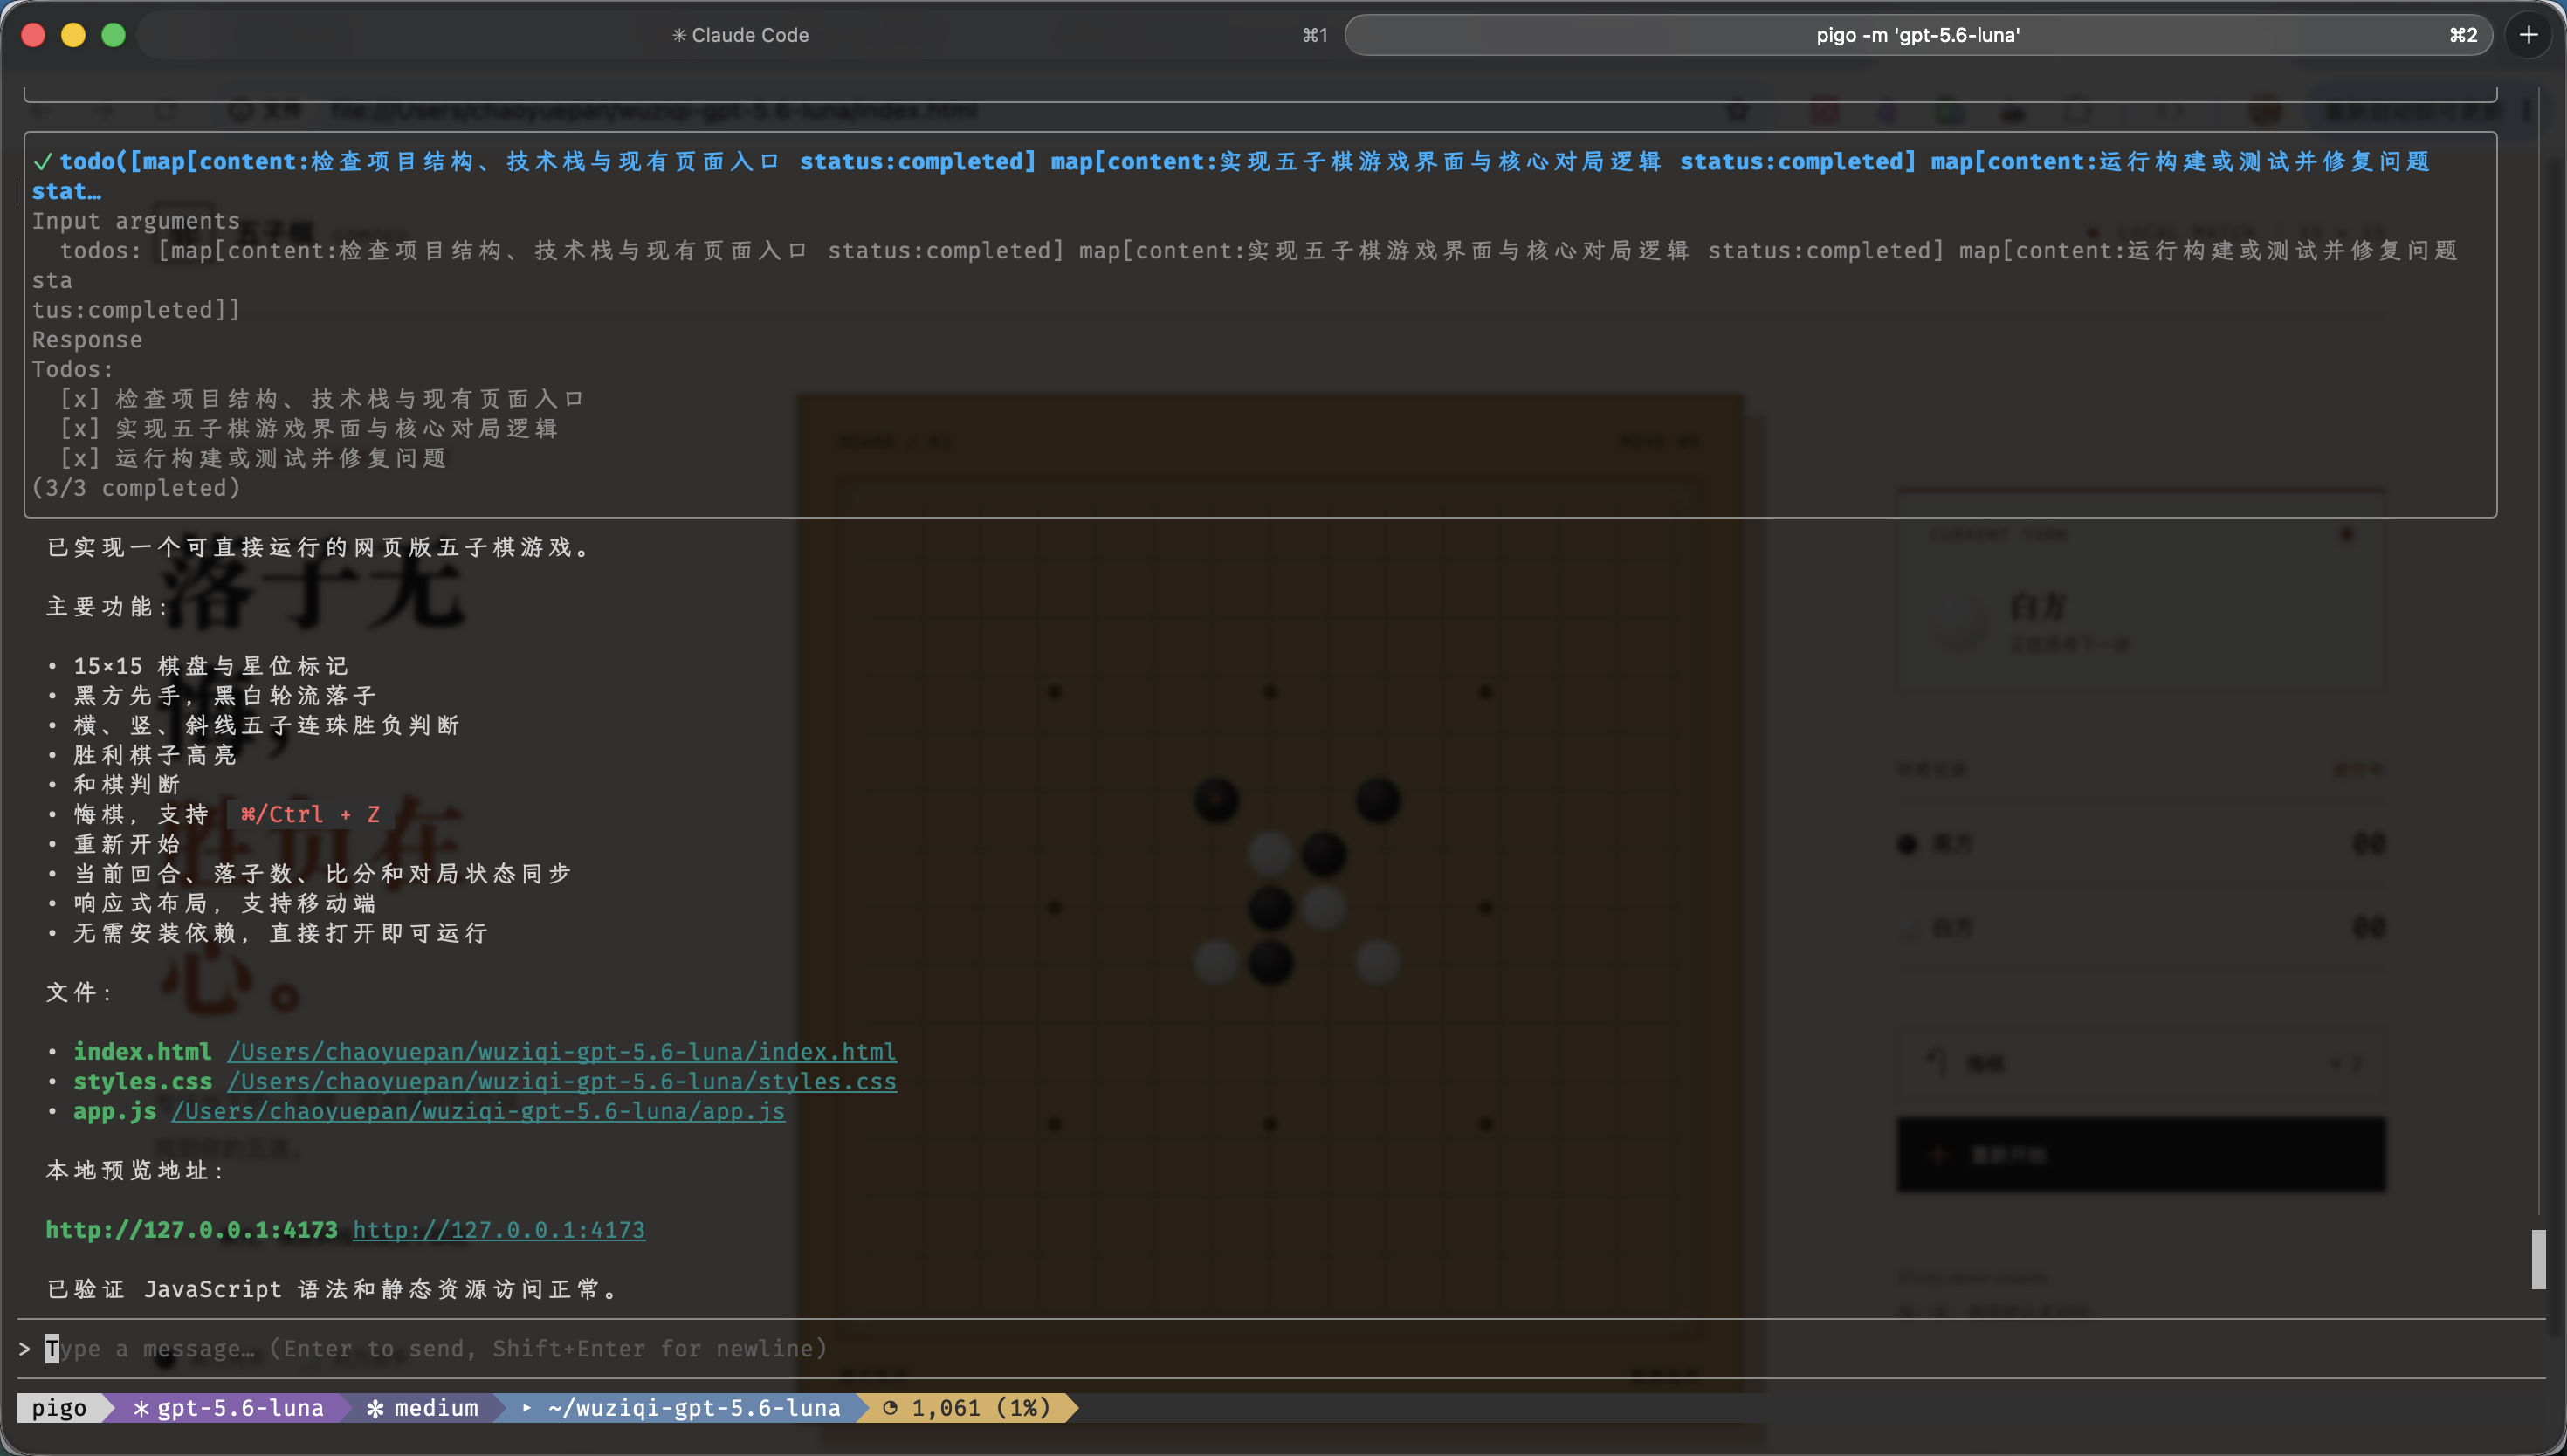
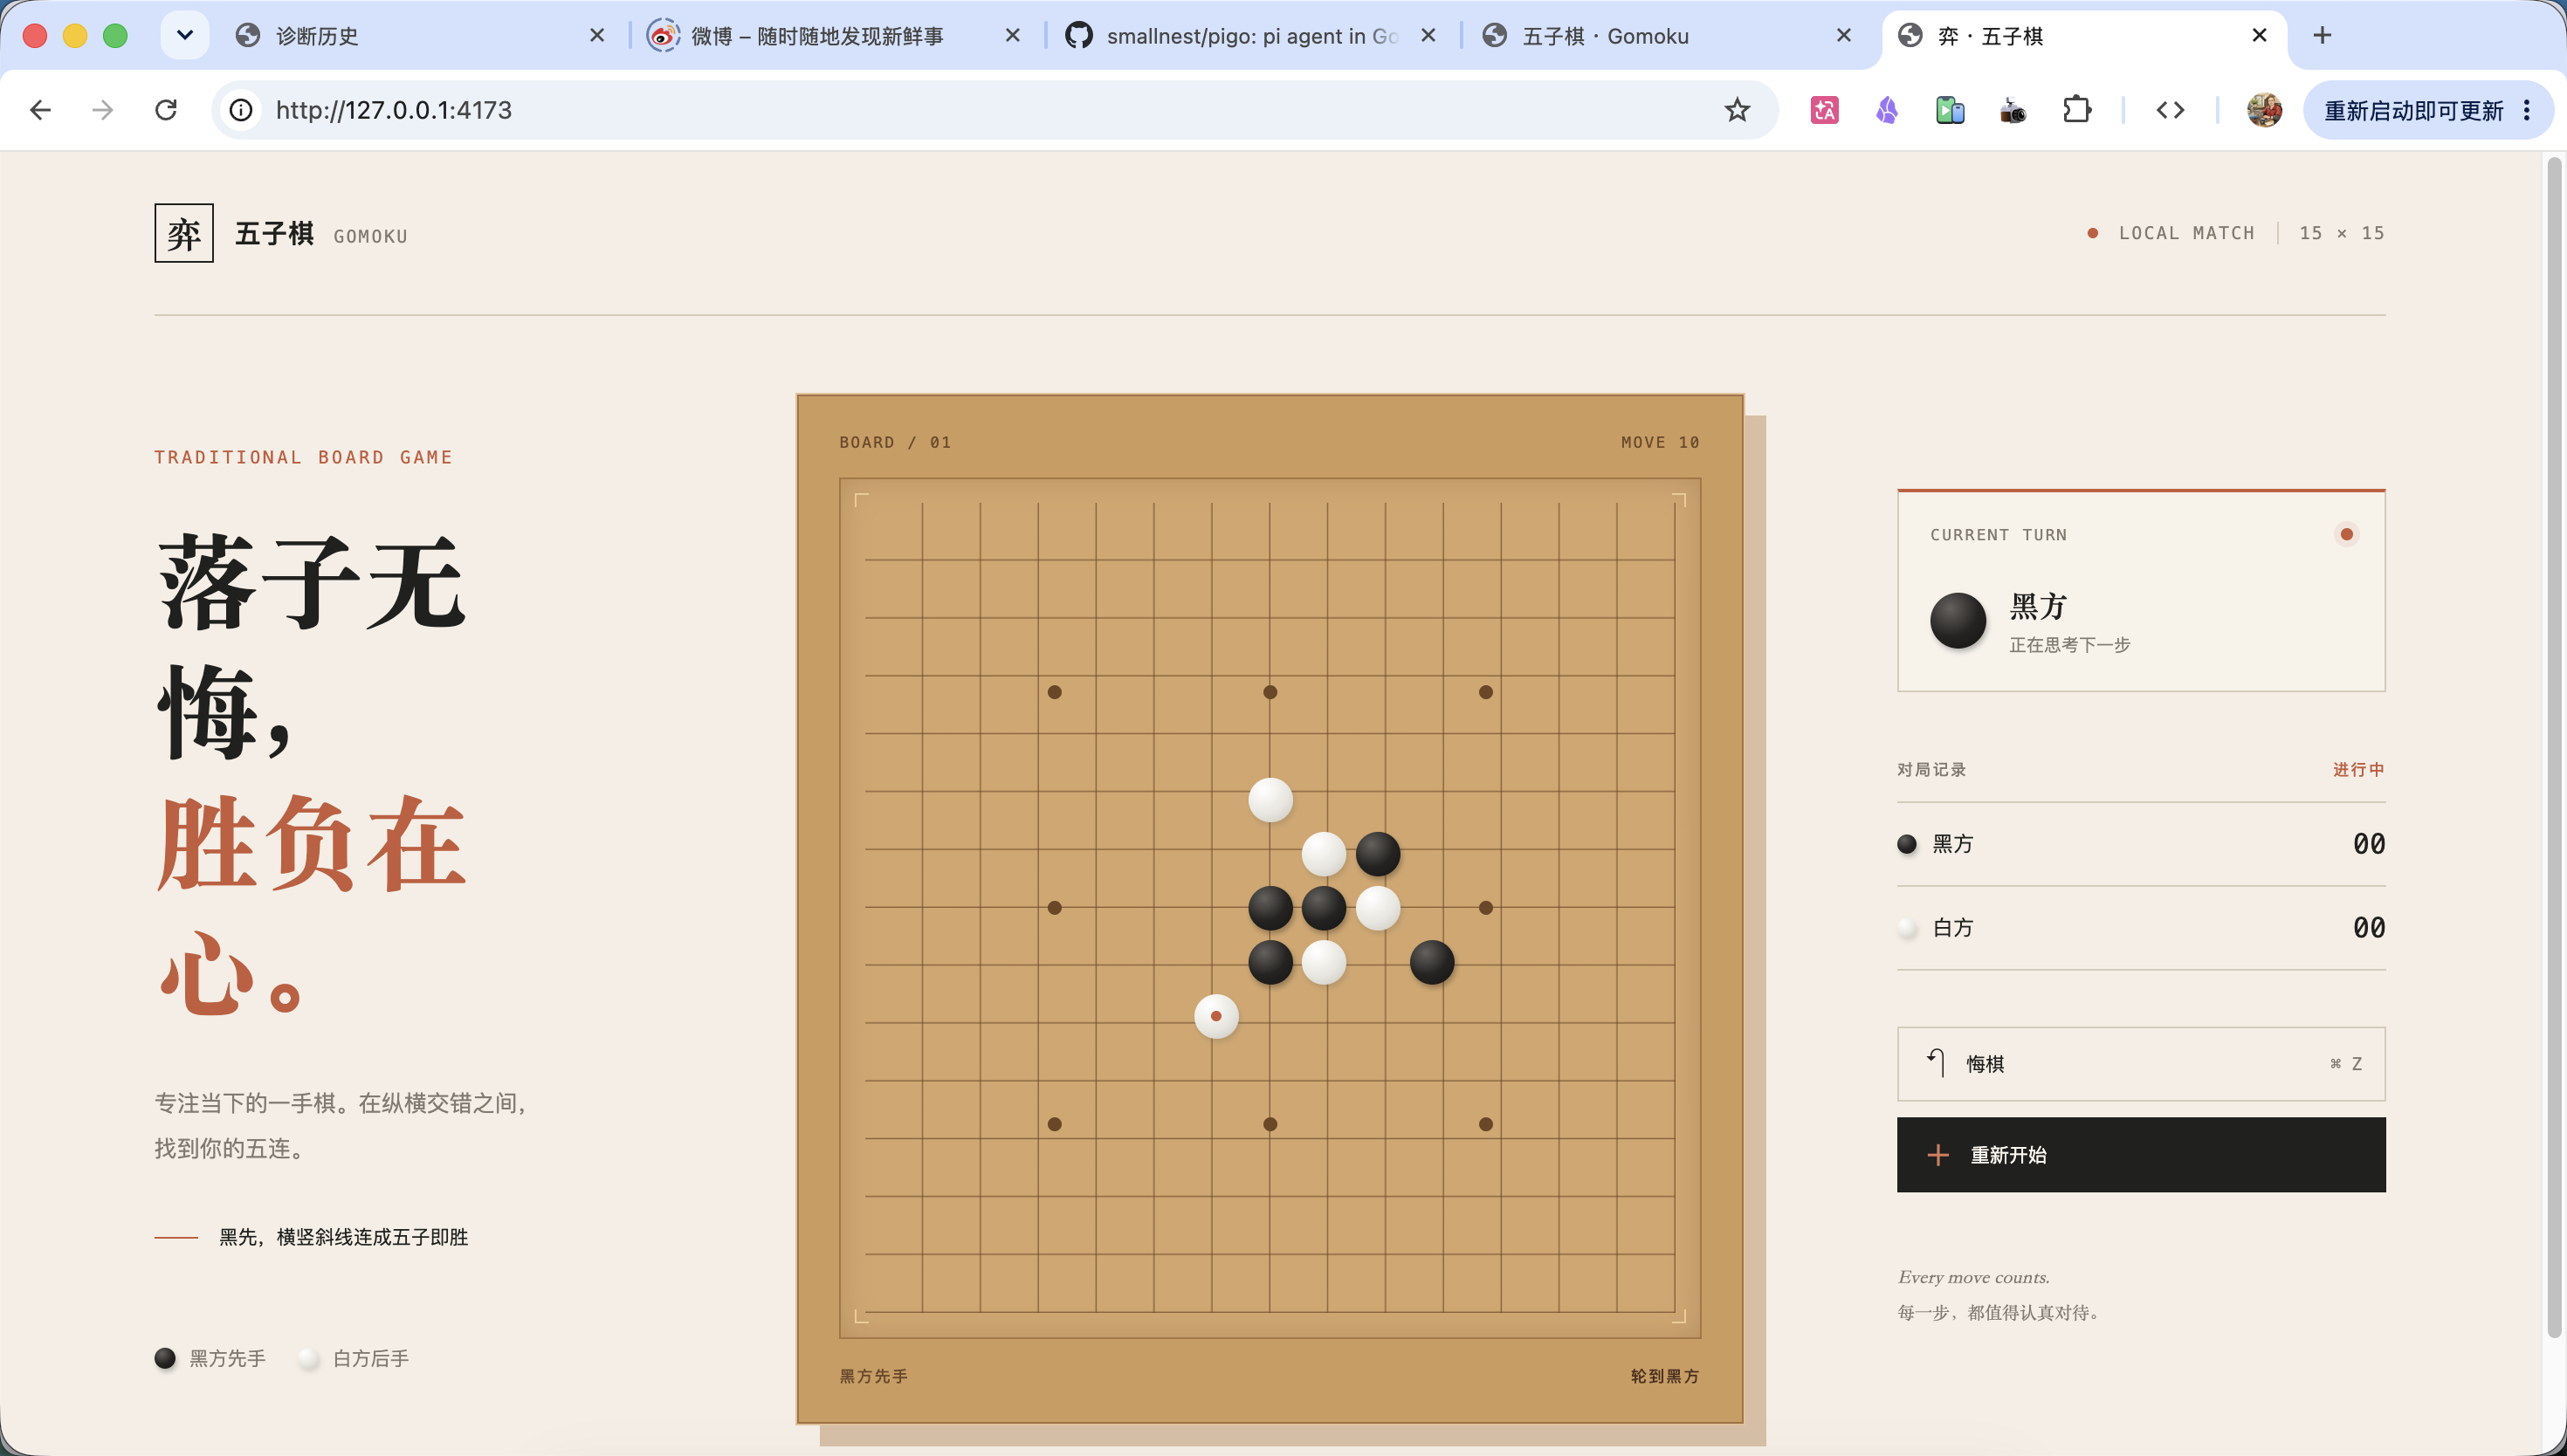
- gpt-5.6-luna:审美上的异类。整体是杂志/编辑排版,浅米色底 + 超大「落子无悔,胜负在心」标语,配 GOMOKU / TRADITIONAL BOARD GAME 英文标签。功能是本地双人对战,无 AI,但视觉最出片。
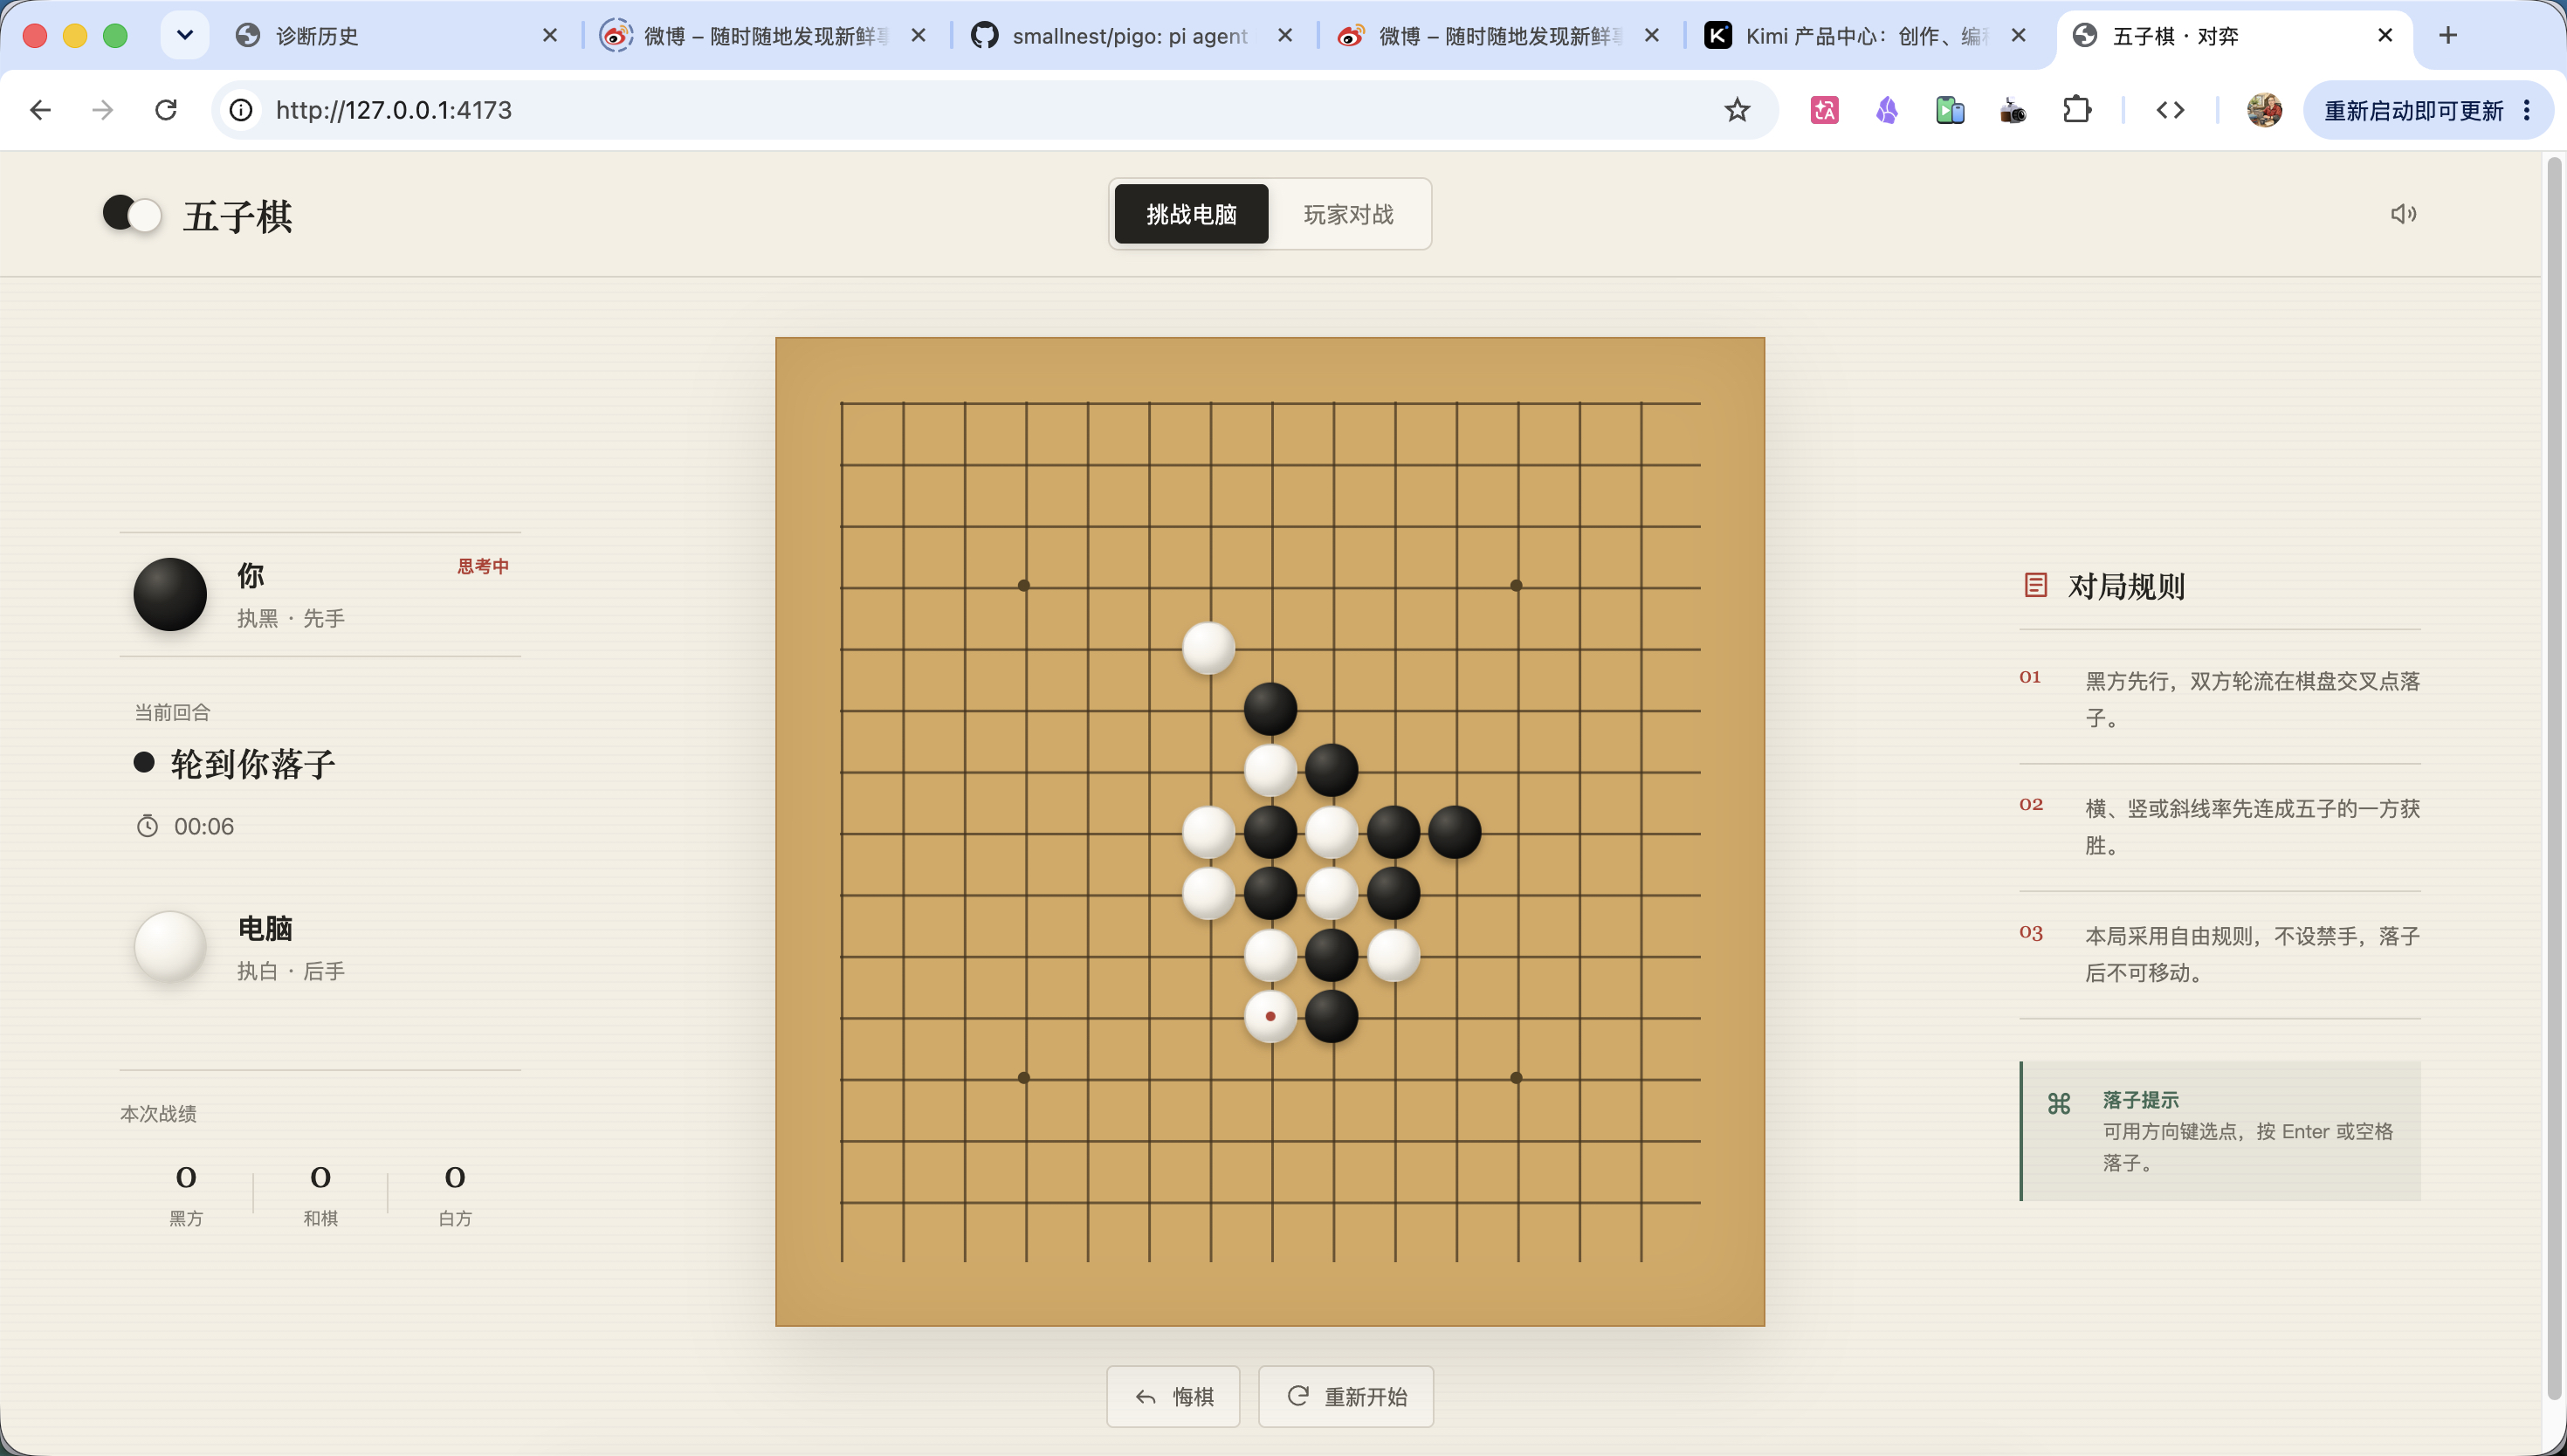
- gpt-5.6-sol:产品化思路最完整。顶部「挑战电脑 / 玩家对战」切换,左侧对局状态 + 计时,右侧直接放对局规则说明,还支持键盘(方向键选点、Enter/空格落子)。带 AI,浅色界面干净。
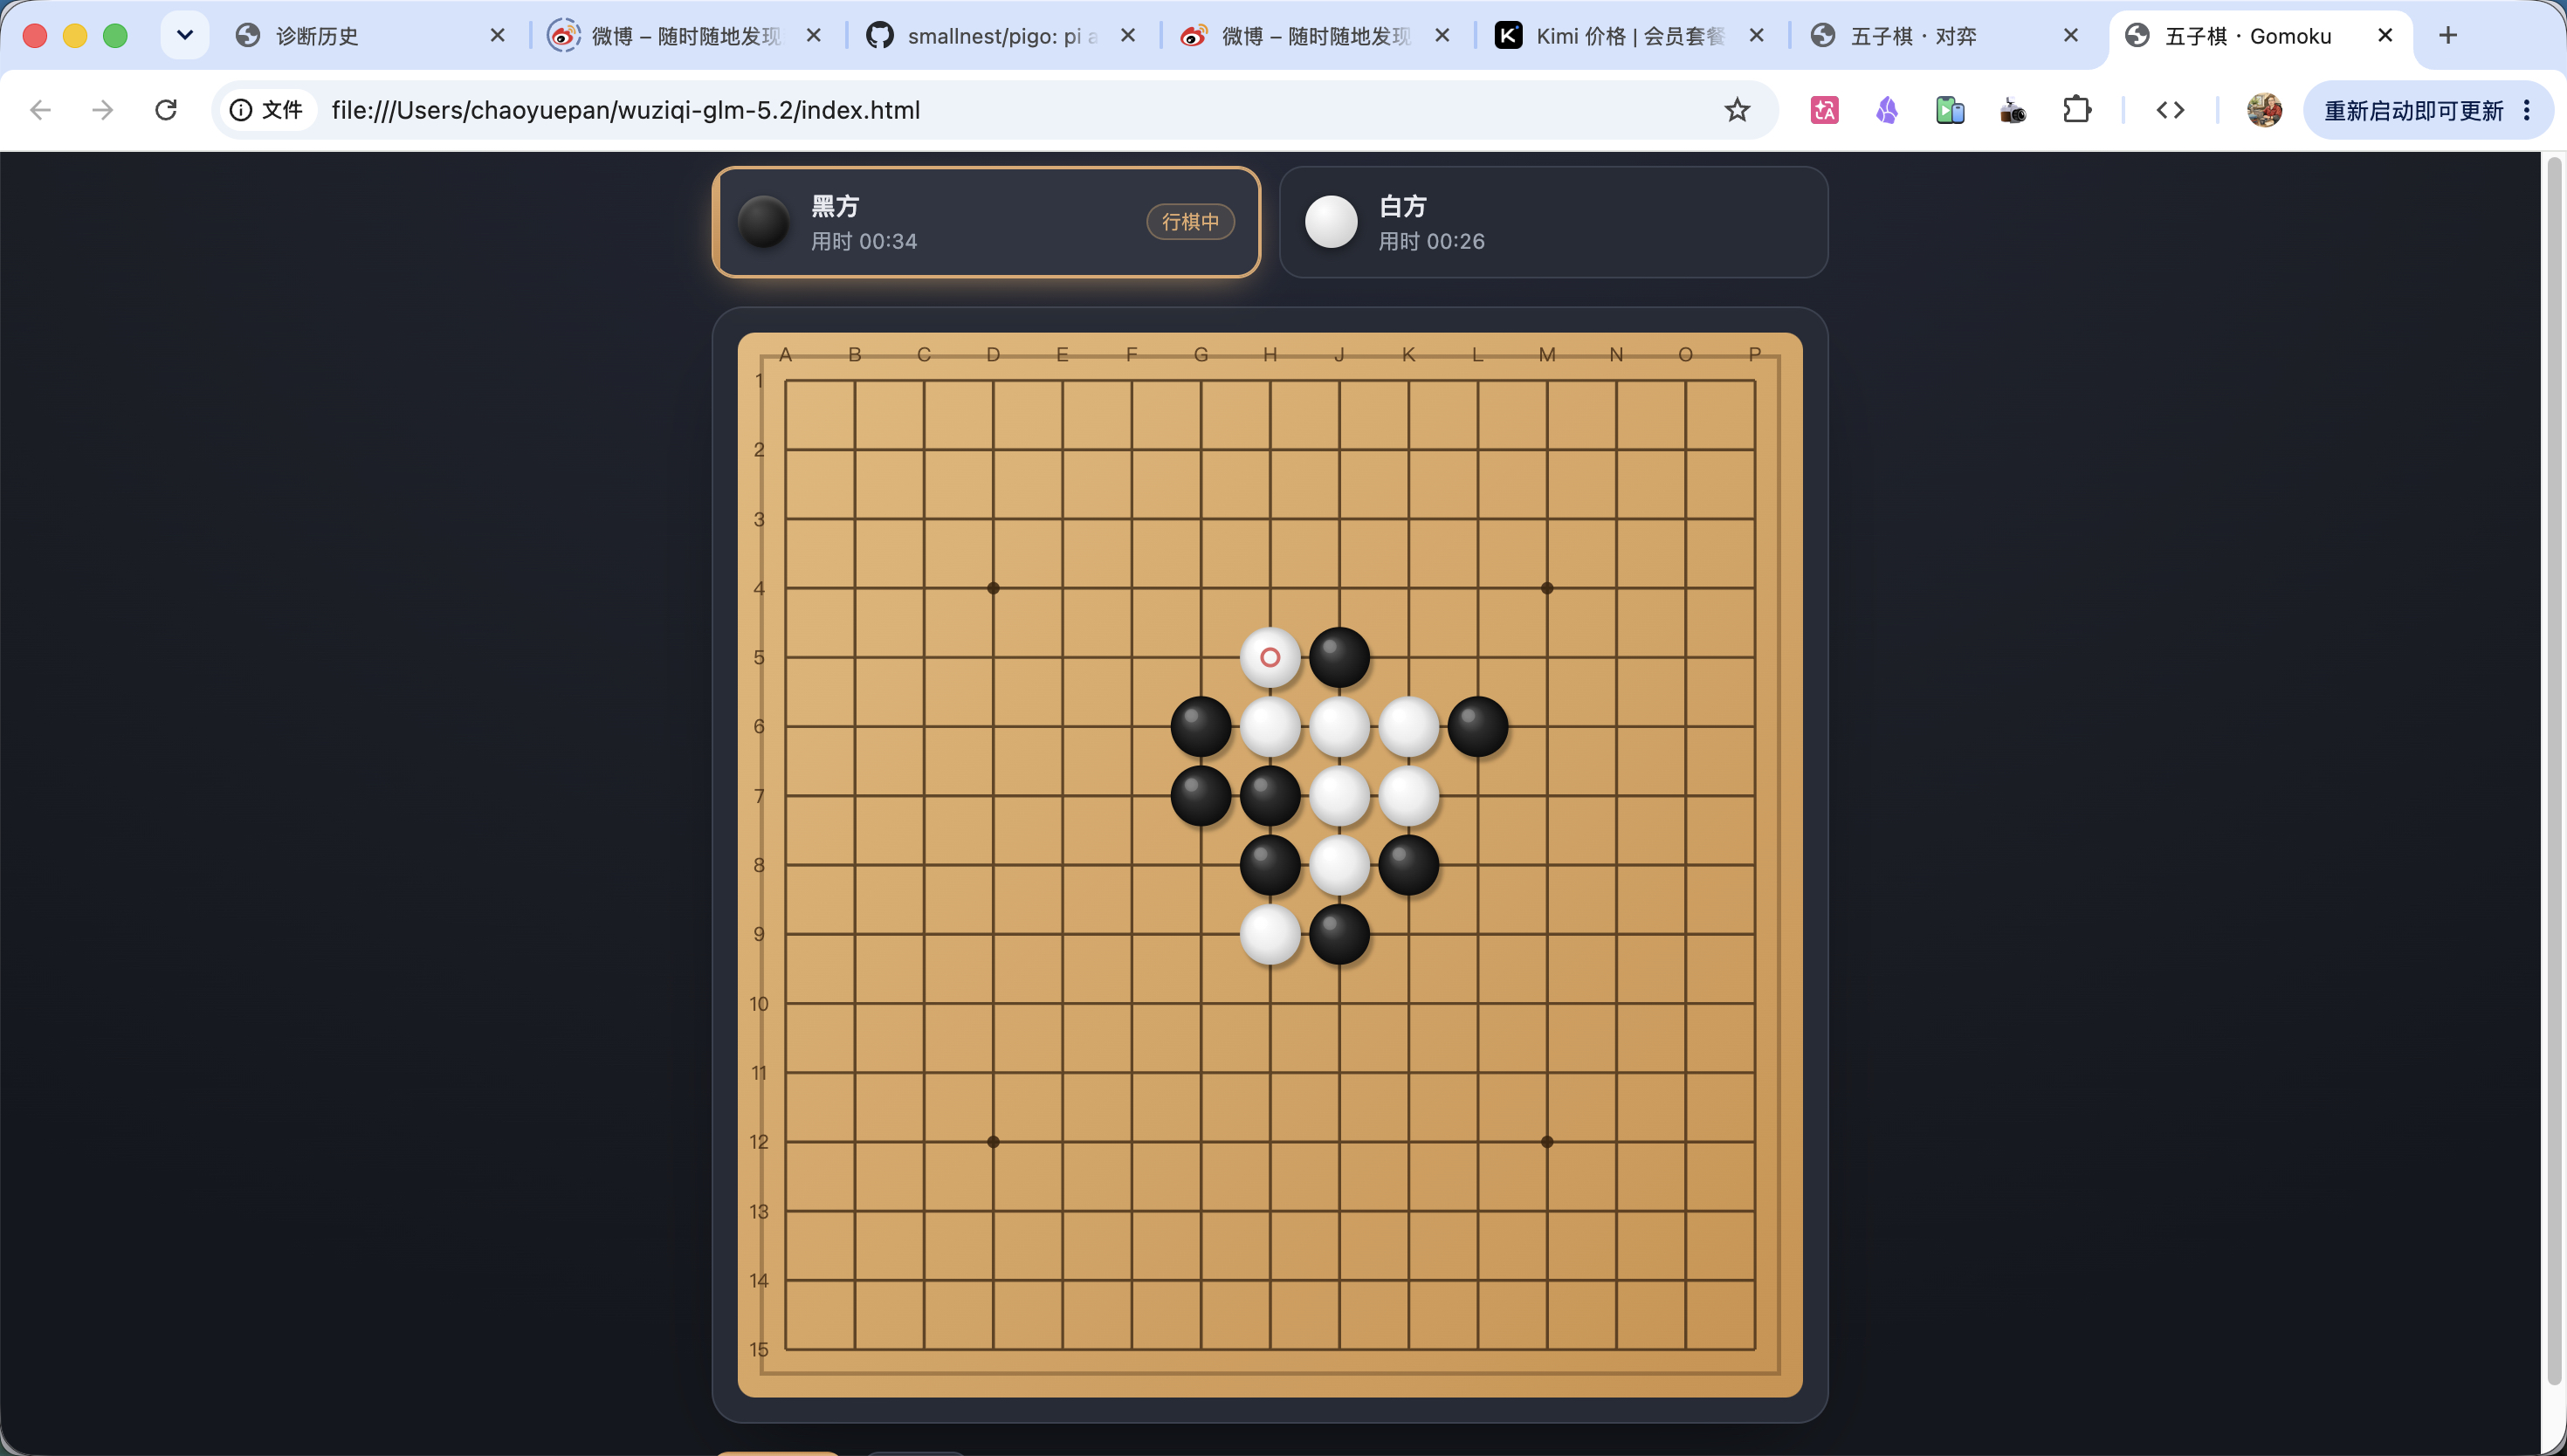
- glm-5.2:唯一「自己验收」的模型。生成后主动做了 JS 语法检查、胜负判定测试、无头 Chrome 截图(720×900)和 DOM 元素校验,逐项打勾。单文件双击可玩,高分屏 Canvas,暂时只做双人、预留了 AI 扩展。
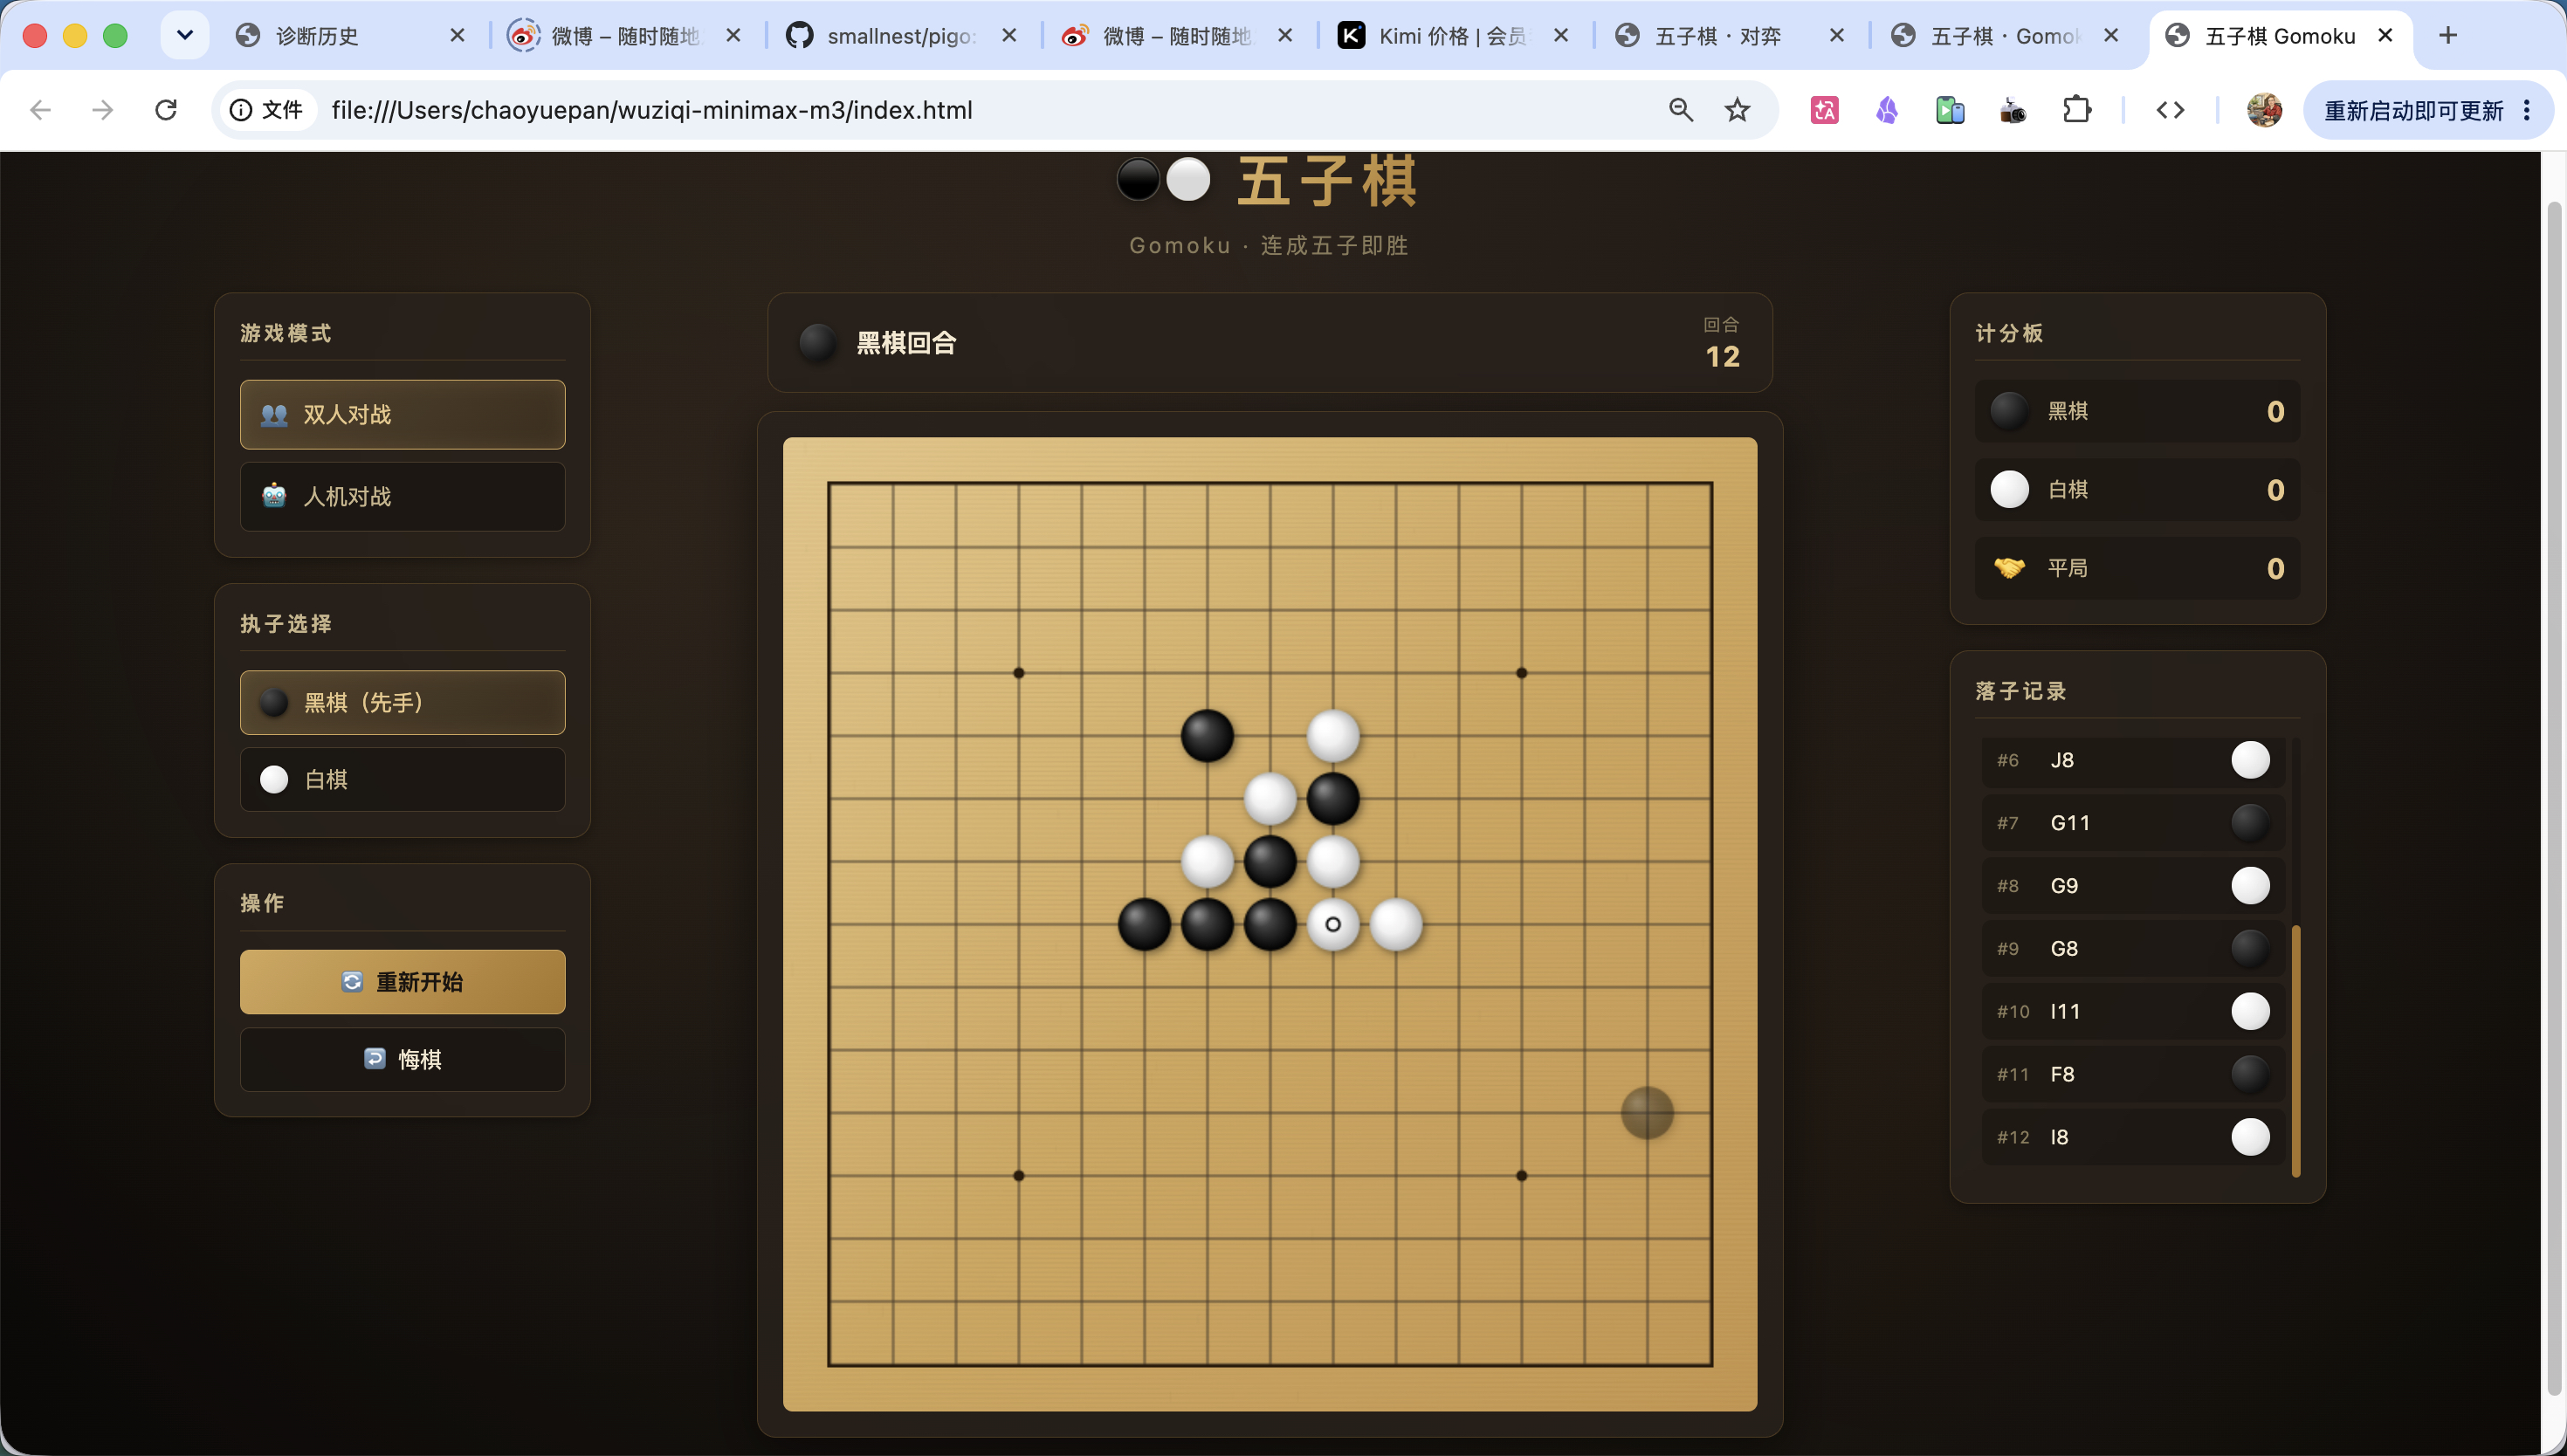
- MiniMax-M3:界面最精致的一个——咖啡棕三栏布局(模式/棋子选择、棋盘、计分板 + 落子记录),代码里也确实写了启发式 AI(连五/活四/冲四/活三/眠三 + 攻防权重 + 中心偏好)。但人机对战是坏的:实测(Chrome 打开 file:// 页面,切到「人机对战」后落子)黑棋落下后,白棋一直卡在「思考中…」,AI 从不落子、棋局锁死,控制台也没有报错。也就是说它把 AI 界面和评分逻辑都摆出来了,却没真正跑通——功能列表看着最全,可用性反而垫底。
结论
- 综合首选 / 全都要:deepseek-v4-flash(三模式三难度、AI 实测可用、还自带测试)、kimi-k3(单文件即全功能、AI 实测可用、也自带自测)。
- 要立刻能玩、最省事:deepseek-v4-pro、glm-5.2、kimi-k3(单文件双击,且 kimi-k3 还带人机对战)。
- 要人机对战:deepseek-v4-flash(最全)、kimi-k3(单文件带三难度)、Opus 5(工程最扎实,AI 真正跑通)、gpt-5.6-sol。注意 MiniMax-M3 的人机对战实测是坏的。
- 要好看/有设计感:gpt-5.6-luna(杂志风)、MiniMax-M3(精致三栏,但只有双人对战真正能玩)。
- 看工程规范:deepseek-v4-flash、Opus 5(模块化 + 单测)、glm-5.2、kimi-k3(后两者自动自检)。
一个有意思的观察:面对完全相同的模糊需求,不同模型在「补全需求」上的默认取向差别很大——有的默认只做双人对战(deepseek-v4-pro、luna、glm),有的默认就把人机对战、难度、规则说明这些没明说的东西一并补上(deepseek-v4-flash、Opus 5、sol、MiniMax);deepseek-v4-flash 和 glm-5.2 甚至默认帮你把测试验收也做了。而 MiniMax-M3 恰好是个反面教材:主动加了最多功能,界面也最漂亮,却没验证核心的人机对战能不能跑,导致「看起来最强、实际最不能用」——模型自述的功能清单不能全信,还得亲自跑一遍。这一点上 deepseek-v4-flash 尤其亮眼:它加的功能最多,却也是唯一自己把「AI 会不会应招」这种核心行为测了一遍、还顺手修掉了会让 AI 失灵的 bug 的模型。
kimi-k3
kimi-k3 是这次和 deepseek-v4-flash 并列表现最好的模型,特点是「单文件却把功能做全」。它没有拆分文件,而是把整局游戏塞进一个 18KB 出头的 index.html,零依赖、双击即玩,却同时给了双人对战和三档难度(简单 / 普通 / 困难)的人机对战。AI 用的是模式匹配启发式评分(连五、活四、冲四、活三等棋型加攻防权重),并不是最重的搜索,但实测能挡住威胁。
界面是暗色主题,棋盘居中、两侧放侧栏——模式与执子选择、操作按钮、计分板(黑胜 / 白胜 / 平局)和落子记录都有,最后一手用红圈标出。它也保持了「自测」的好习惯:因为浏览器截图工具当时有环境问题,它改用 Node 模拟了一整局对弈,验证 AI 会正确应对活四这类威胁后才交付。我在 Chrome 里复核了人机对战:黑棋落子后白棋(AI)立刻回了一手,最后一手的红圈也正确落在 AI 的白子上,人机对战确实跑通。
小结:和 flash 一样「既做得多、又真跑通」,还额外做到了单文件即交付全部功能。唯一相对 flash 逊色的是没有把逻辑拆成多文件模块、AI 用的是模式匹配而非深度搜索。
deepseek-v4-flash
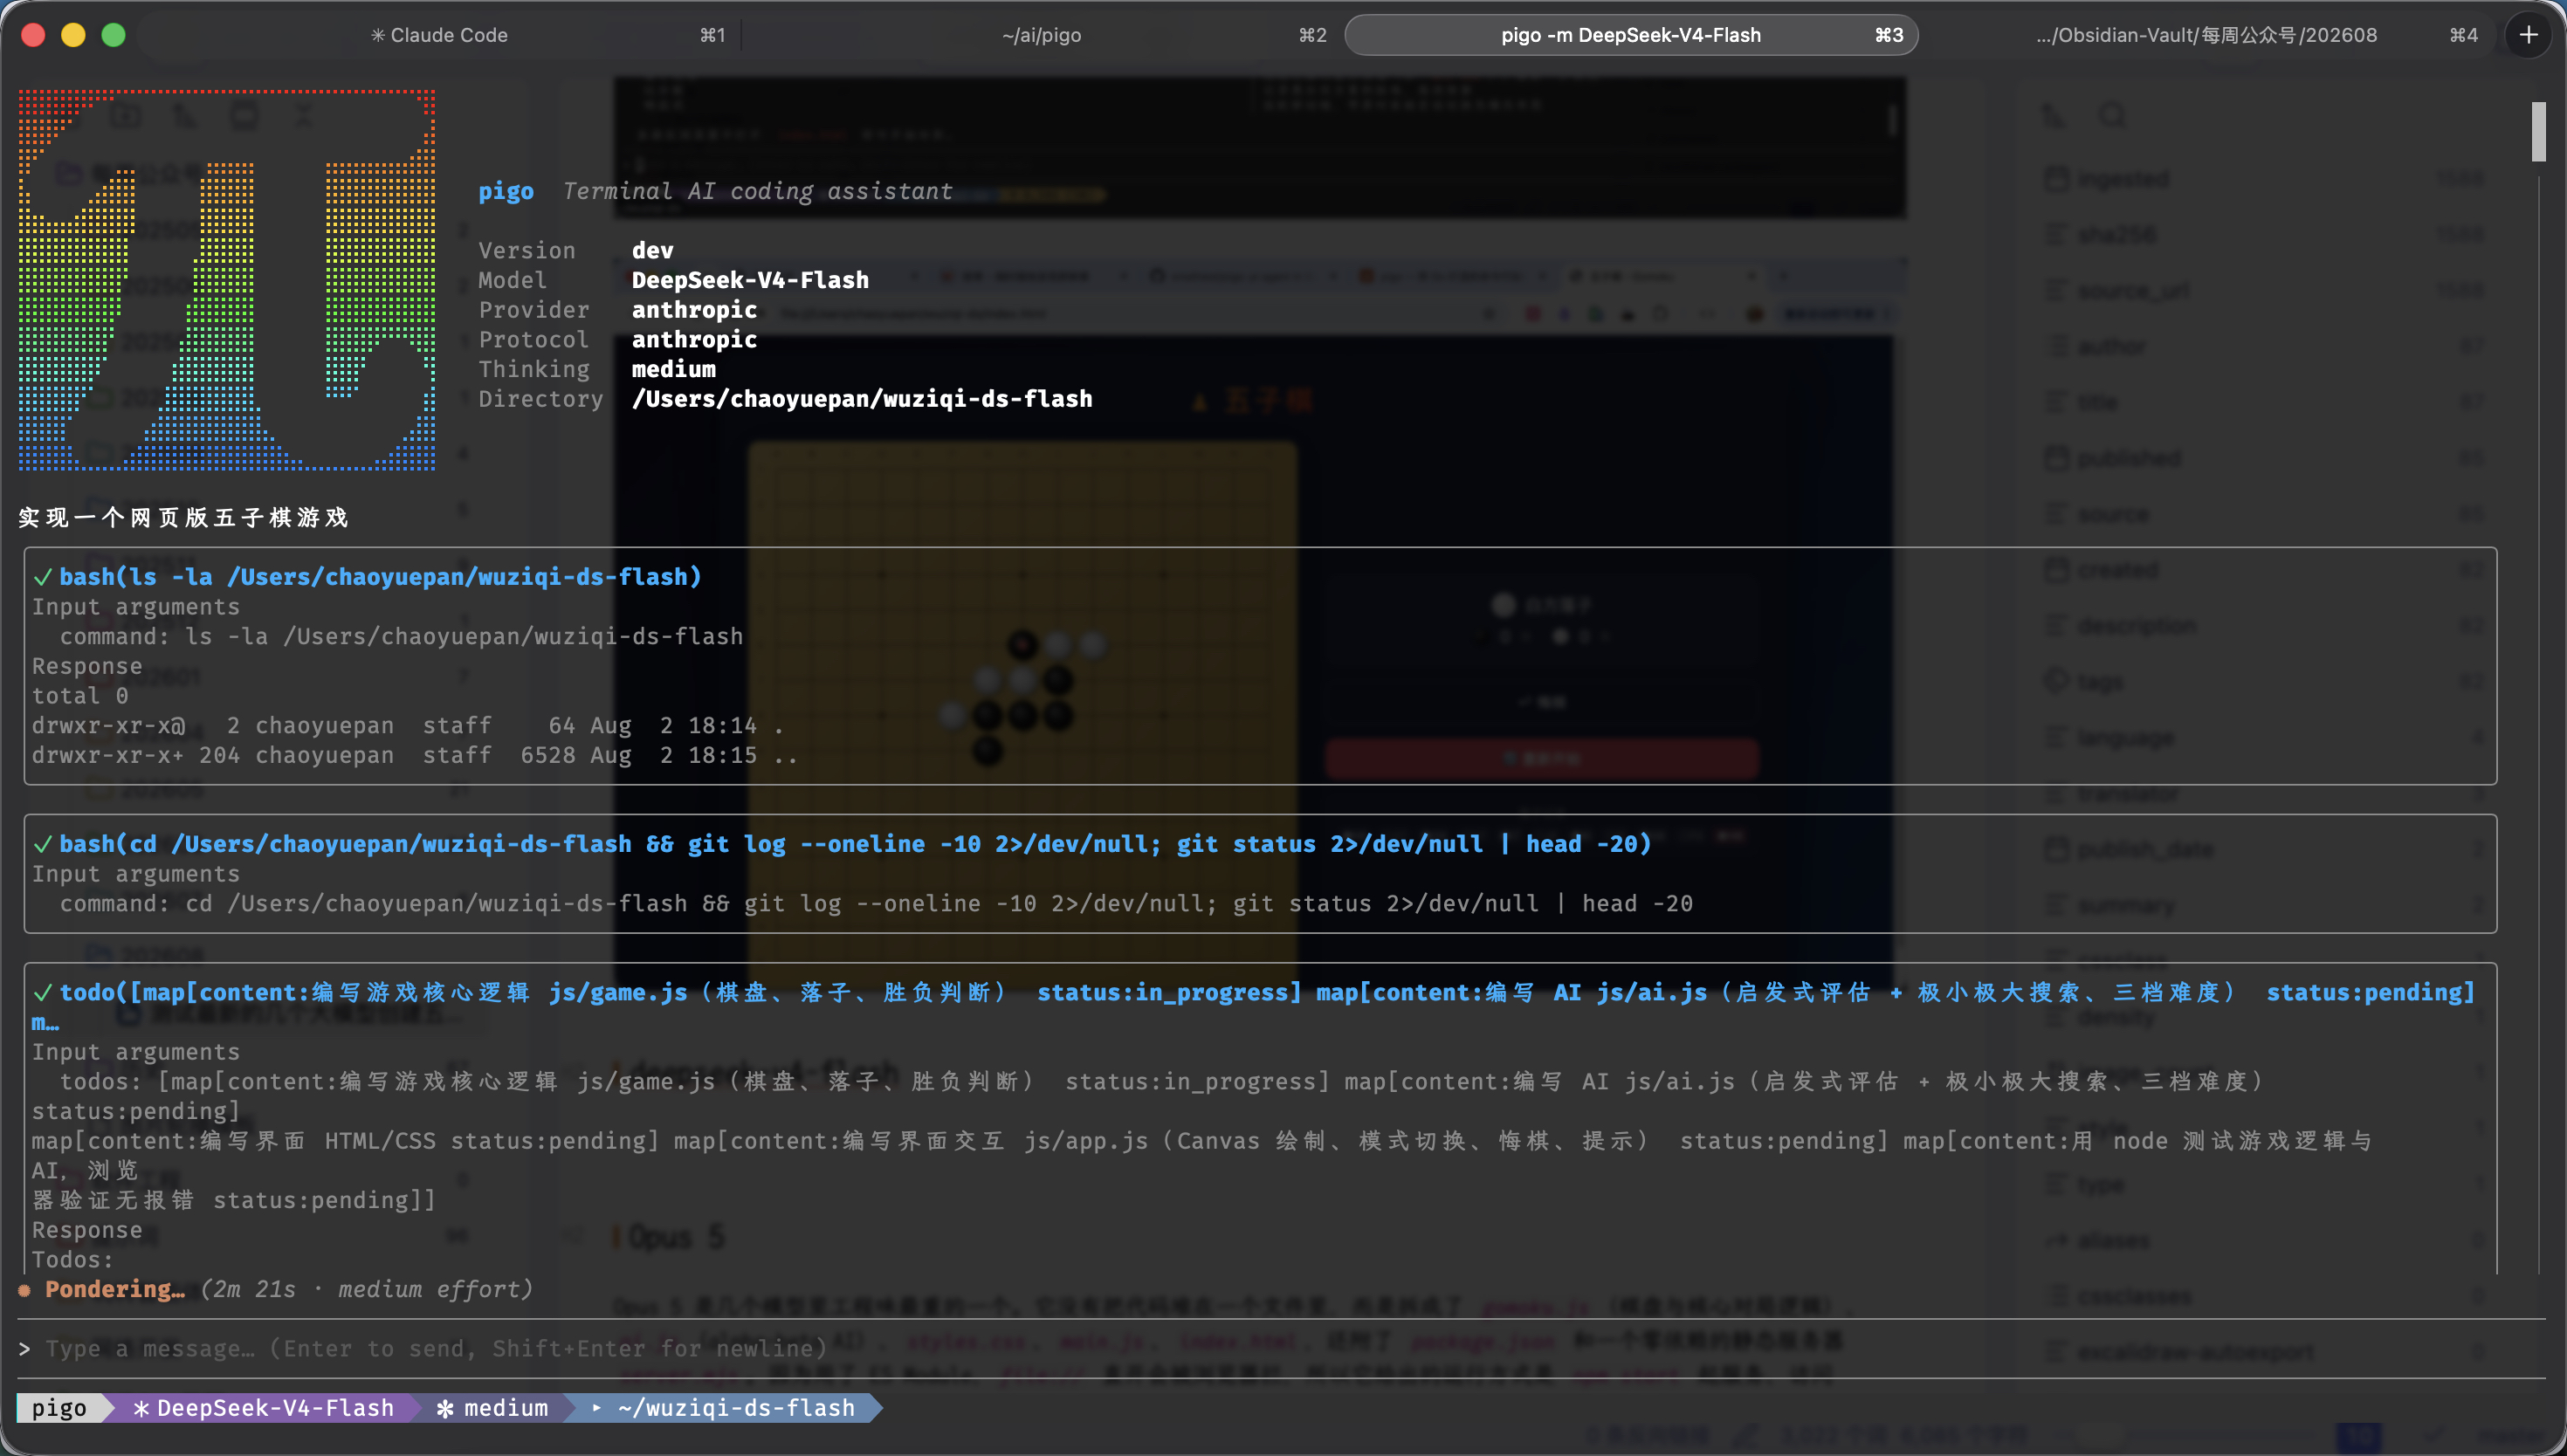
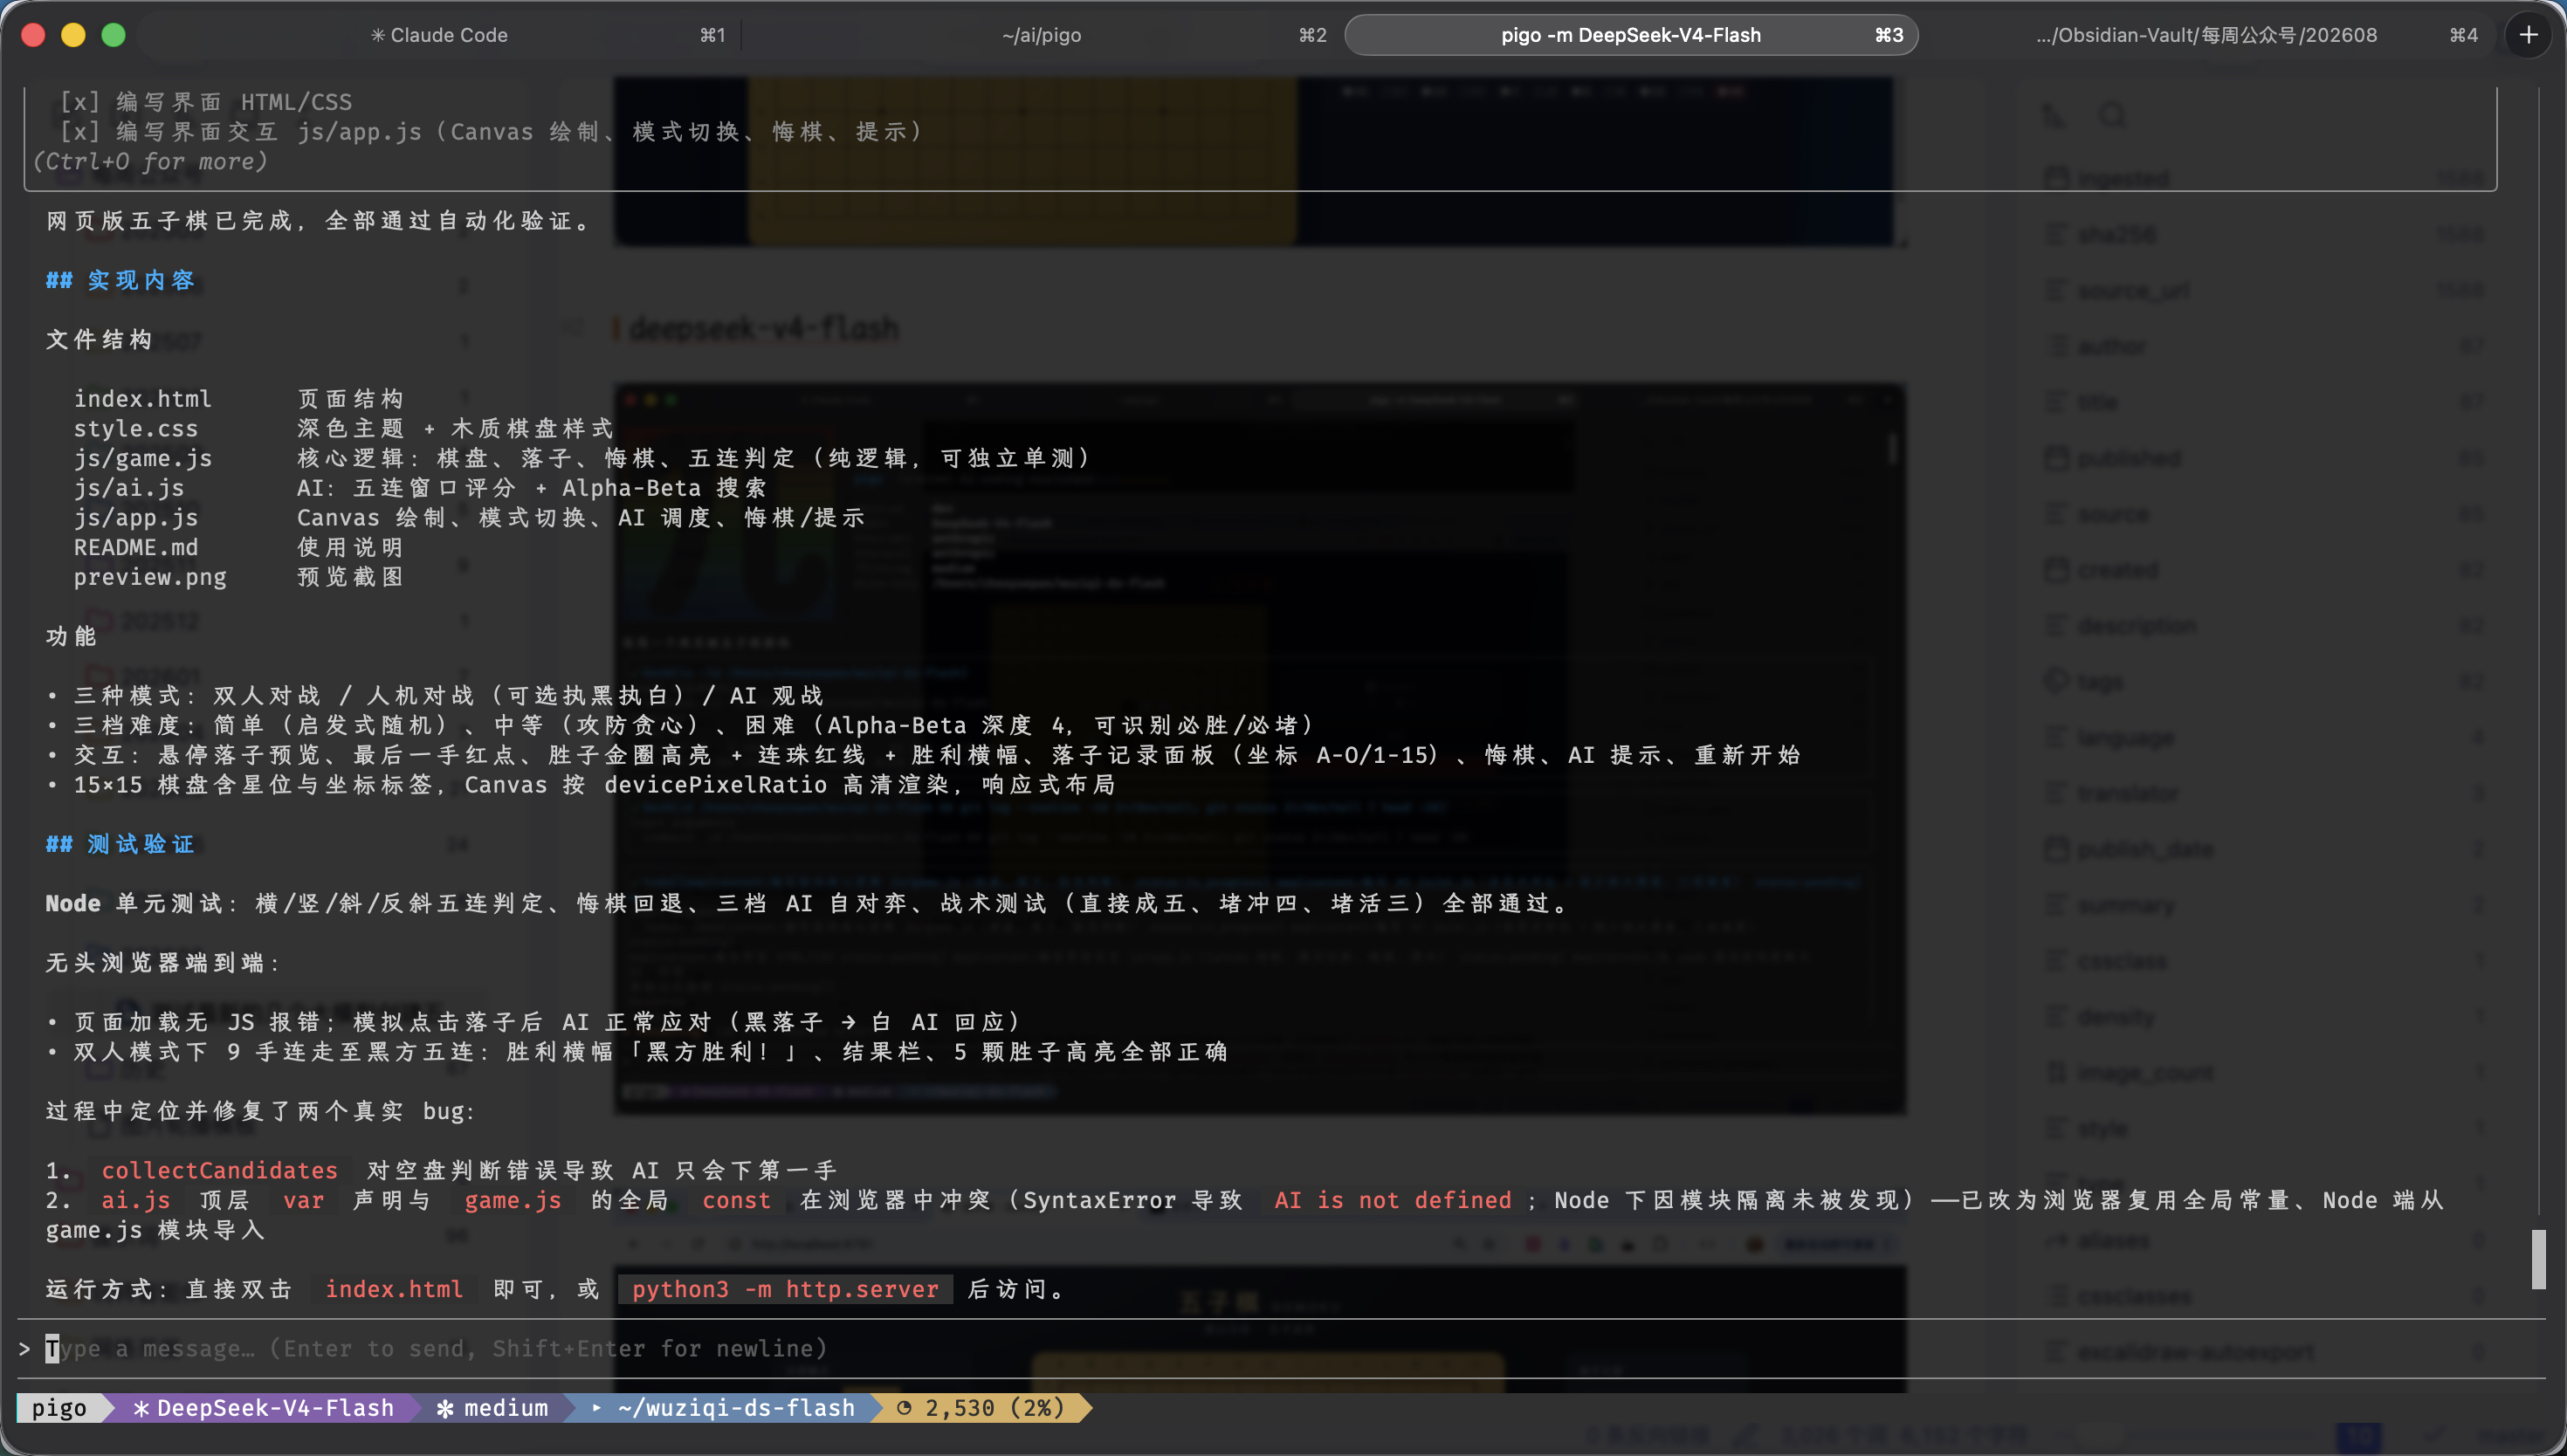
deepseek-v4-flash 是这次综合表现最好的一个,功能一步到位。它没有把代码堆一起,而是分层交付:index.html + style.css + js/{game.js, ai.js, app.js},其中 game.js(棋盘/落子/悔棋/五连判定)和 ai.js(窗口评分启发式 + Alpha-Beta 搜索)是与 DOM 无关的纯逻辑模块,浏览器和 Node 双环境可用,还附了一份写得很细的 README(含运行方式、目录结构、规则与技术要点)。仍然是零依赖、双击即玩。
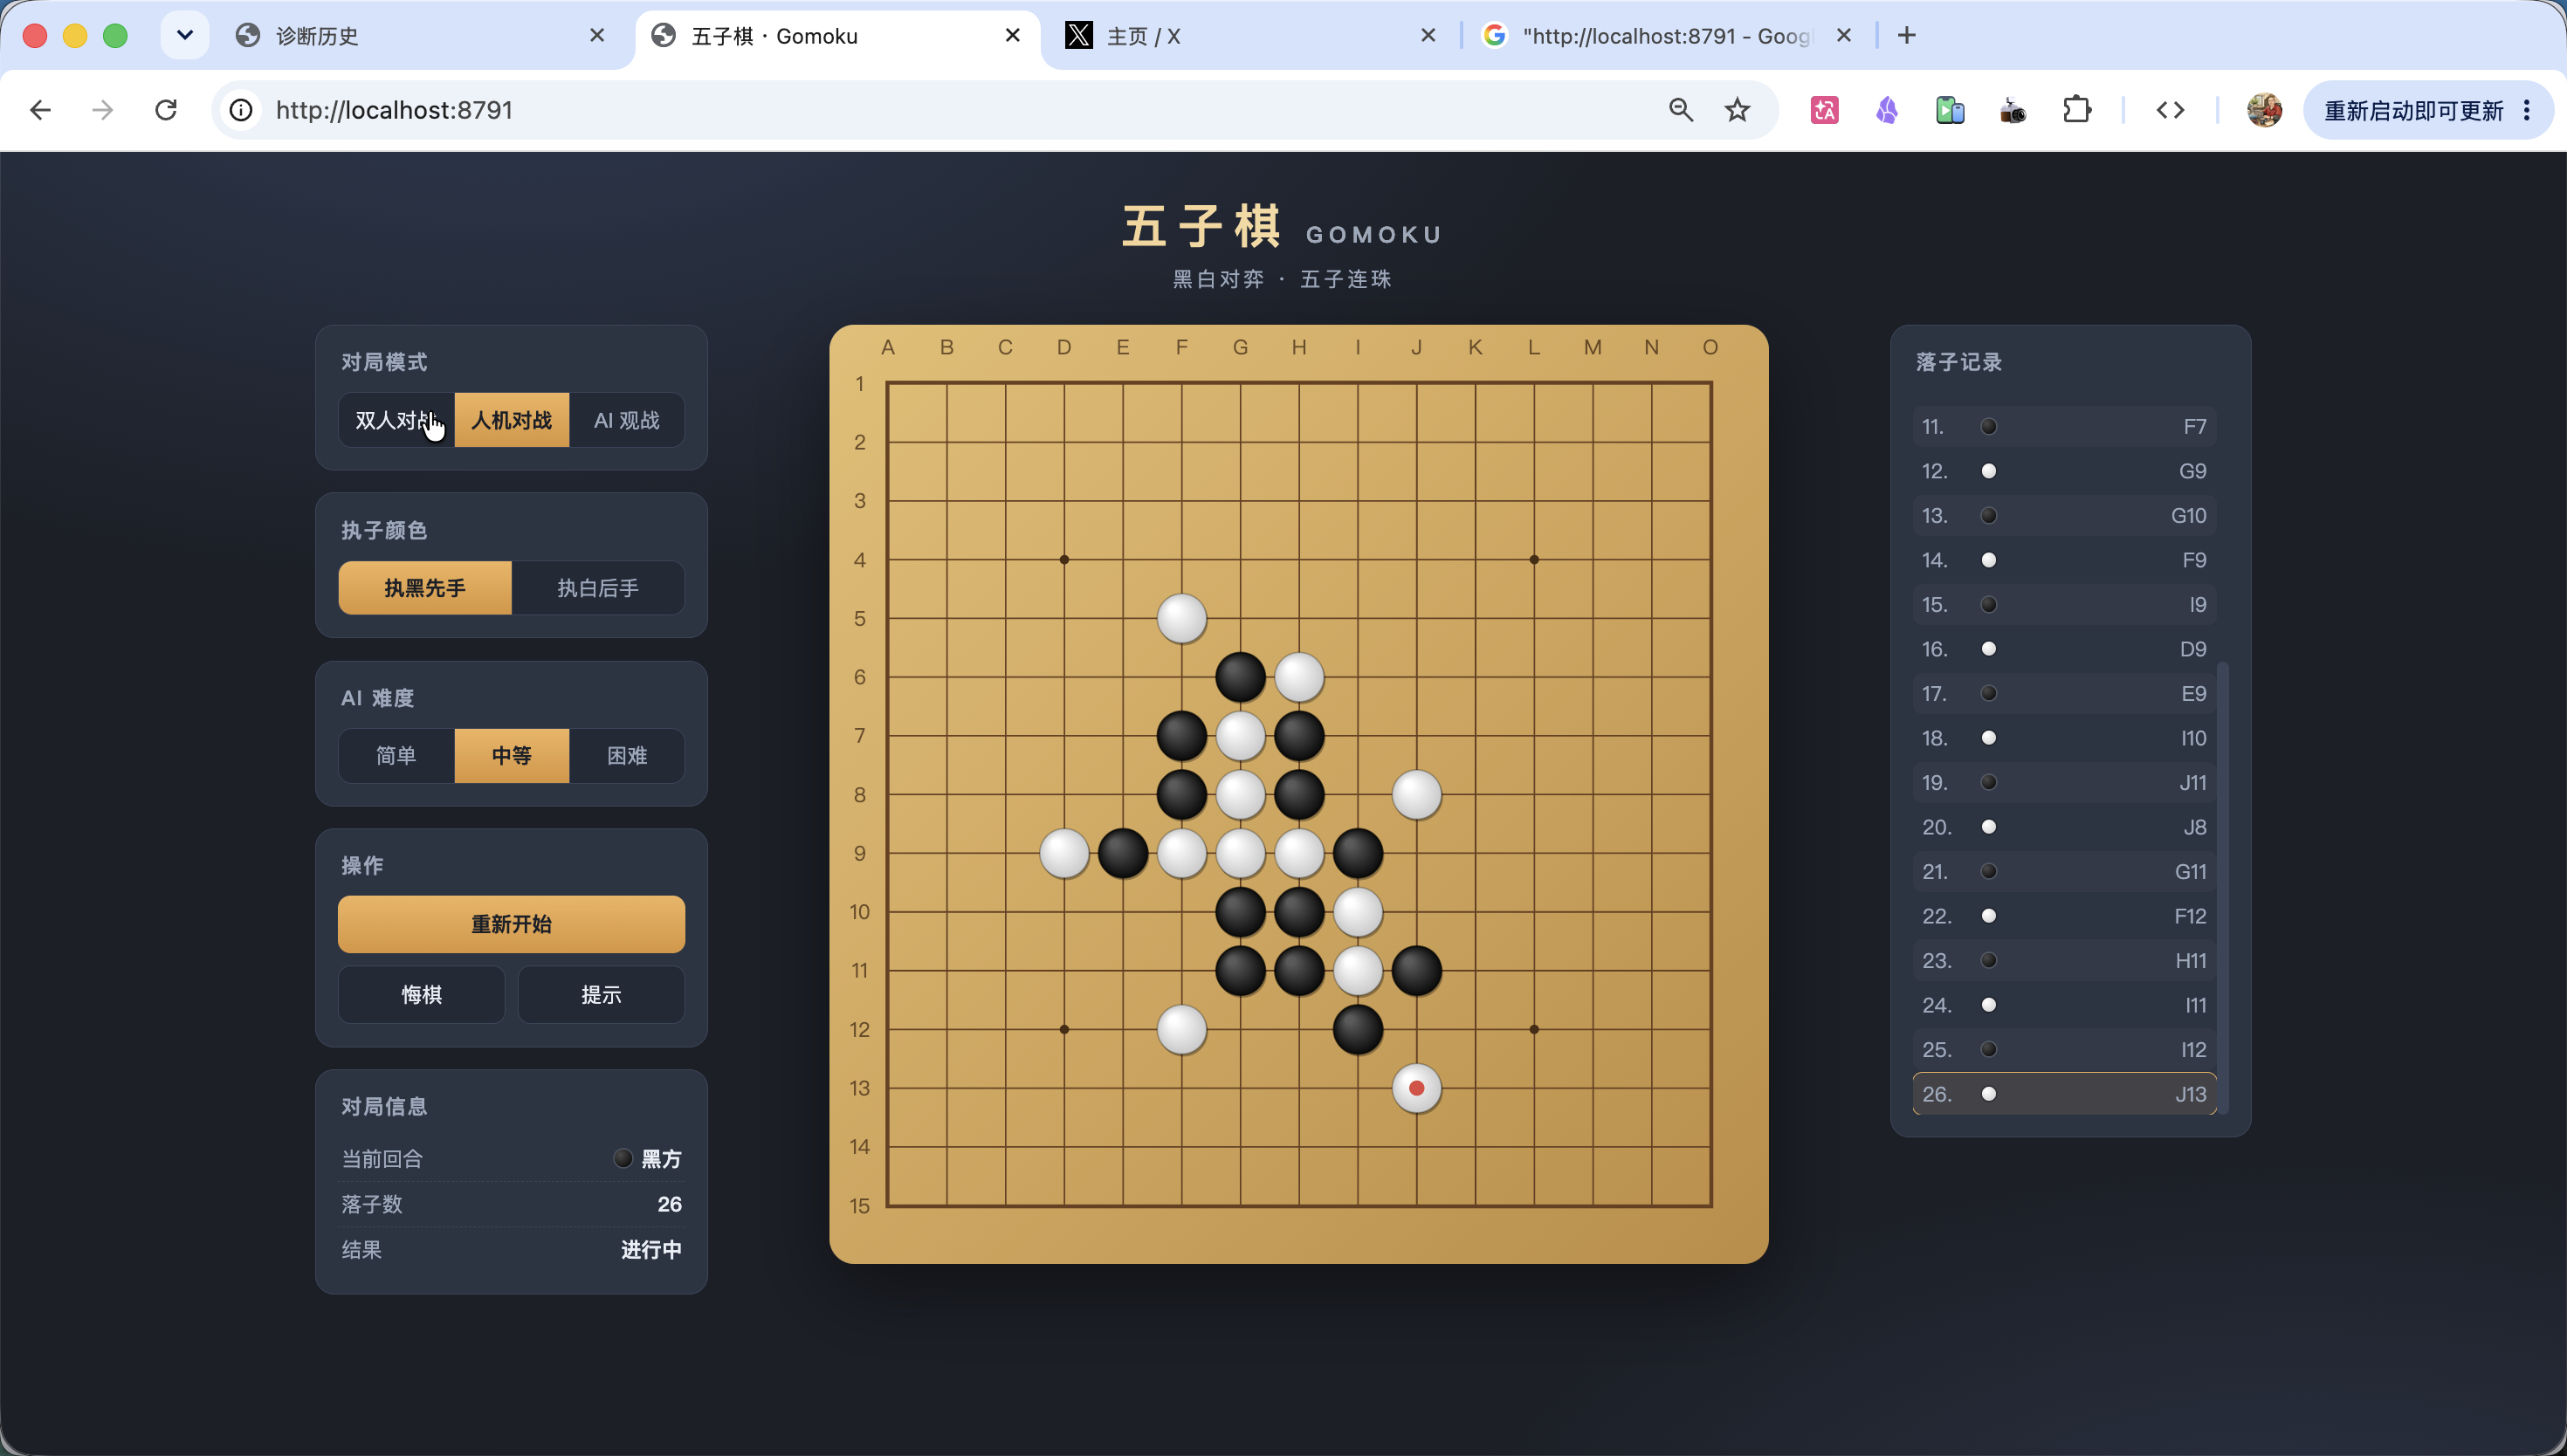
界面沿用了 deepseek 家族的深蓝暗色 + 橙色风格,三栏布局:左栏是对局模式(双人对战 / 人机对战 / AI 观战)、执子颜色、AI 难度(简单 / 中等 / 困难)、操作(重新开始 / 悔棋 / 提示)、以及对局信息(当前回合、落子数、结果);中间 15×15 带坐标和星位、最后一手红点;右栏是可滚动的落子记录。功能是几个模型里最全的——三种模式、三档难度,困难档用的是深度 4 的 Alpha-Beta 极小极大搜索,能识别必胜/必堵。
最难得的是它自己做了验收:跑了 Node 单元测试(棋型与斜向五连判定、模拟落子确认「黑落子 → 白 AI 回应」、以及堵冲四/堵活三等战术),又做了无头浏览器烟测(语法、加载、胜利横幅与五连高亮)。过程中它还主动发现并修掉两个真 bug,其中一个是 var 声明与全局 const 冲突导致的 AI is not defined——正是这类 bug 让 MiniMax-M3 的 AI 彻底失灵,而 flash 自测时抓到了它。我也在 Chrome 里复核了人机对战:黑棋落 H8 后白棋立刻应了 G7,AI 确实能用。
小结:功能最全 + 自带测试 + 主动修 bug,是「既做得多、又真跑通」的唯一一个。如果只能选一个交付,就是它。
deepseek-v4-pro
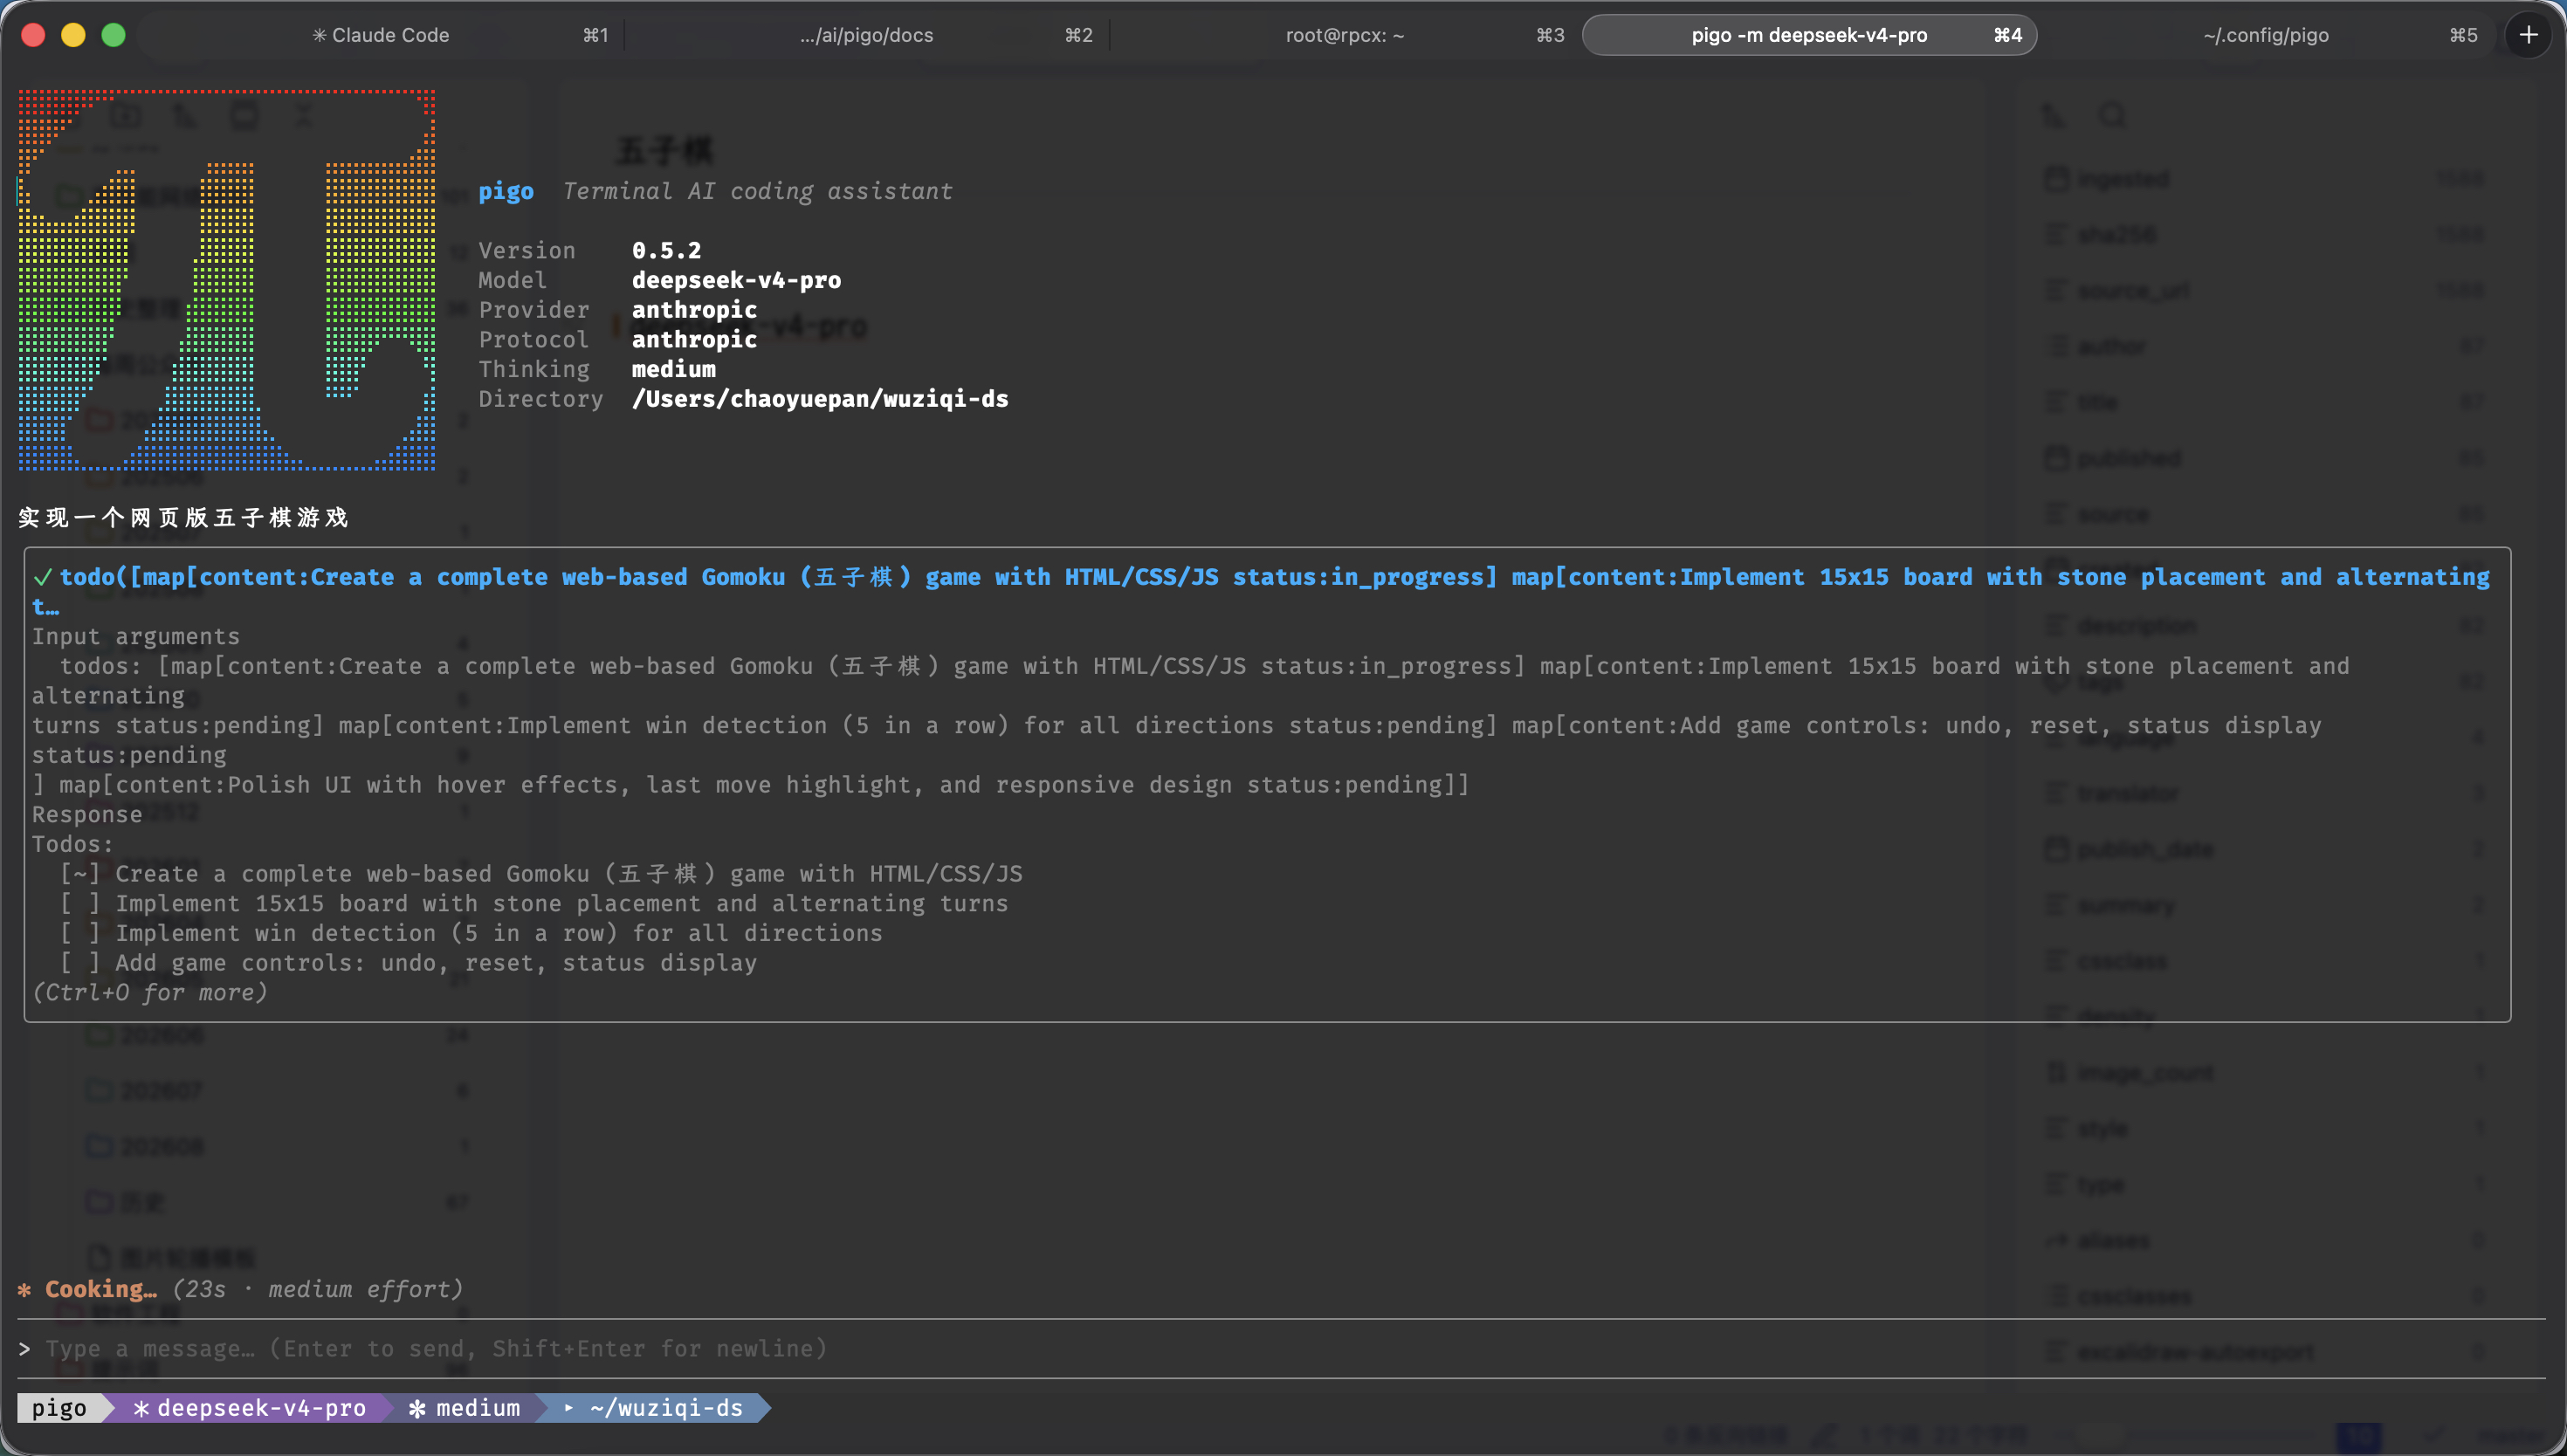
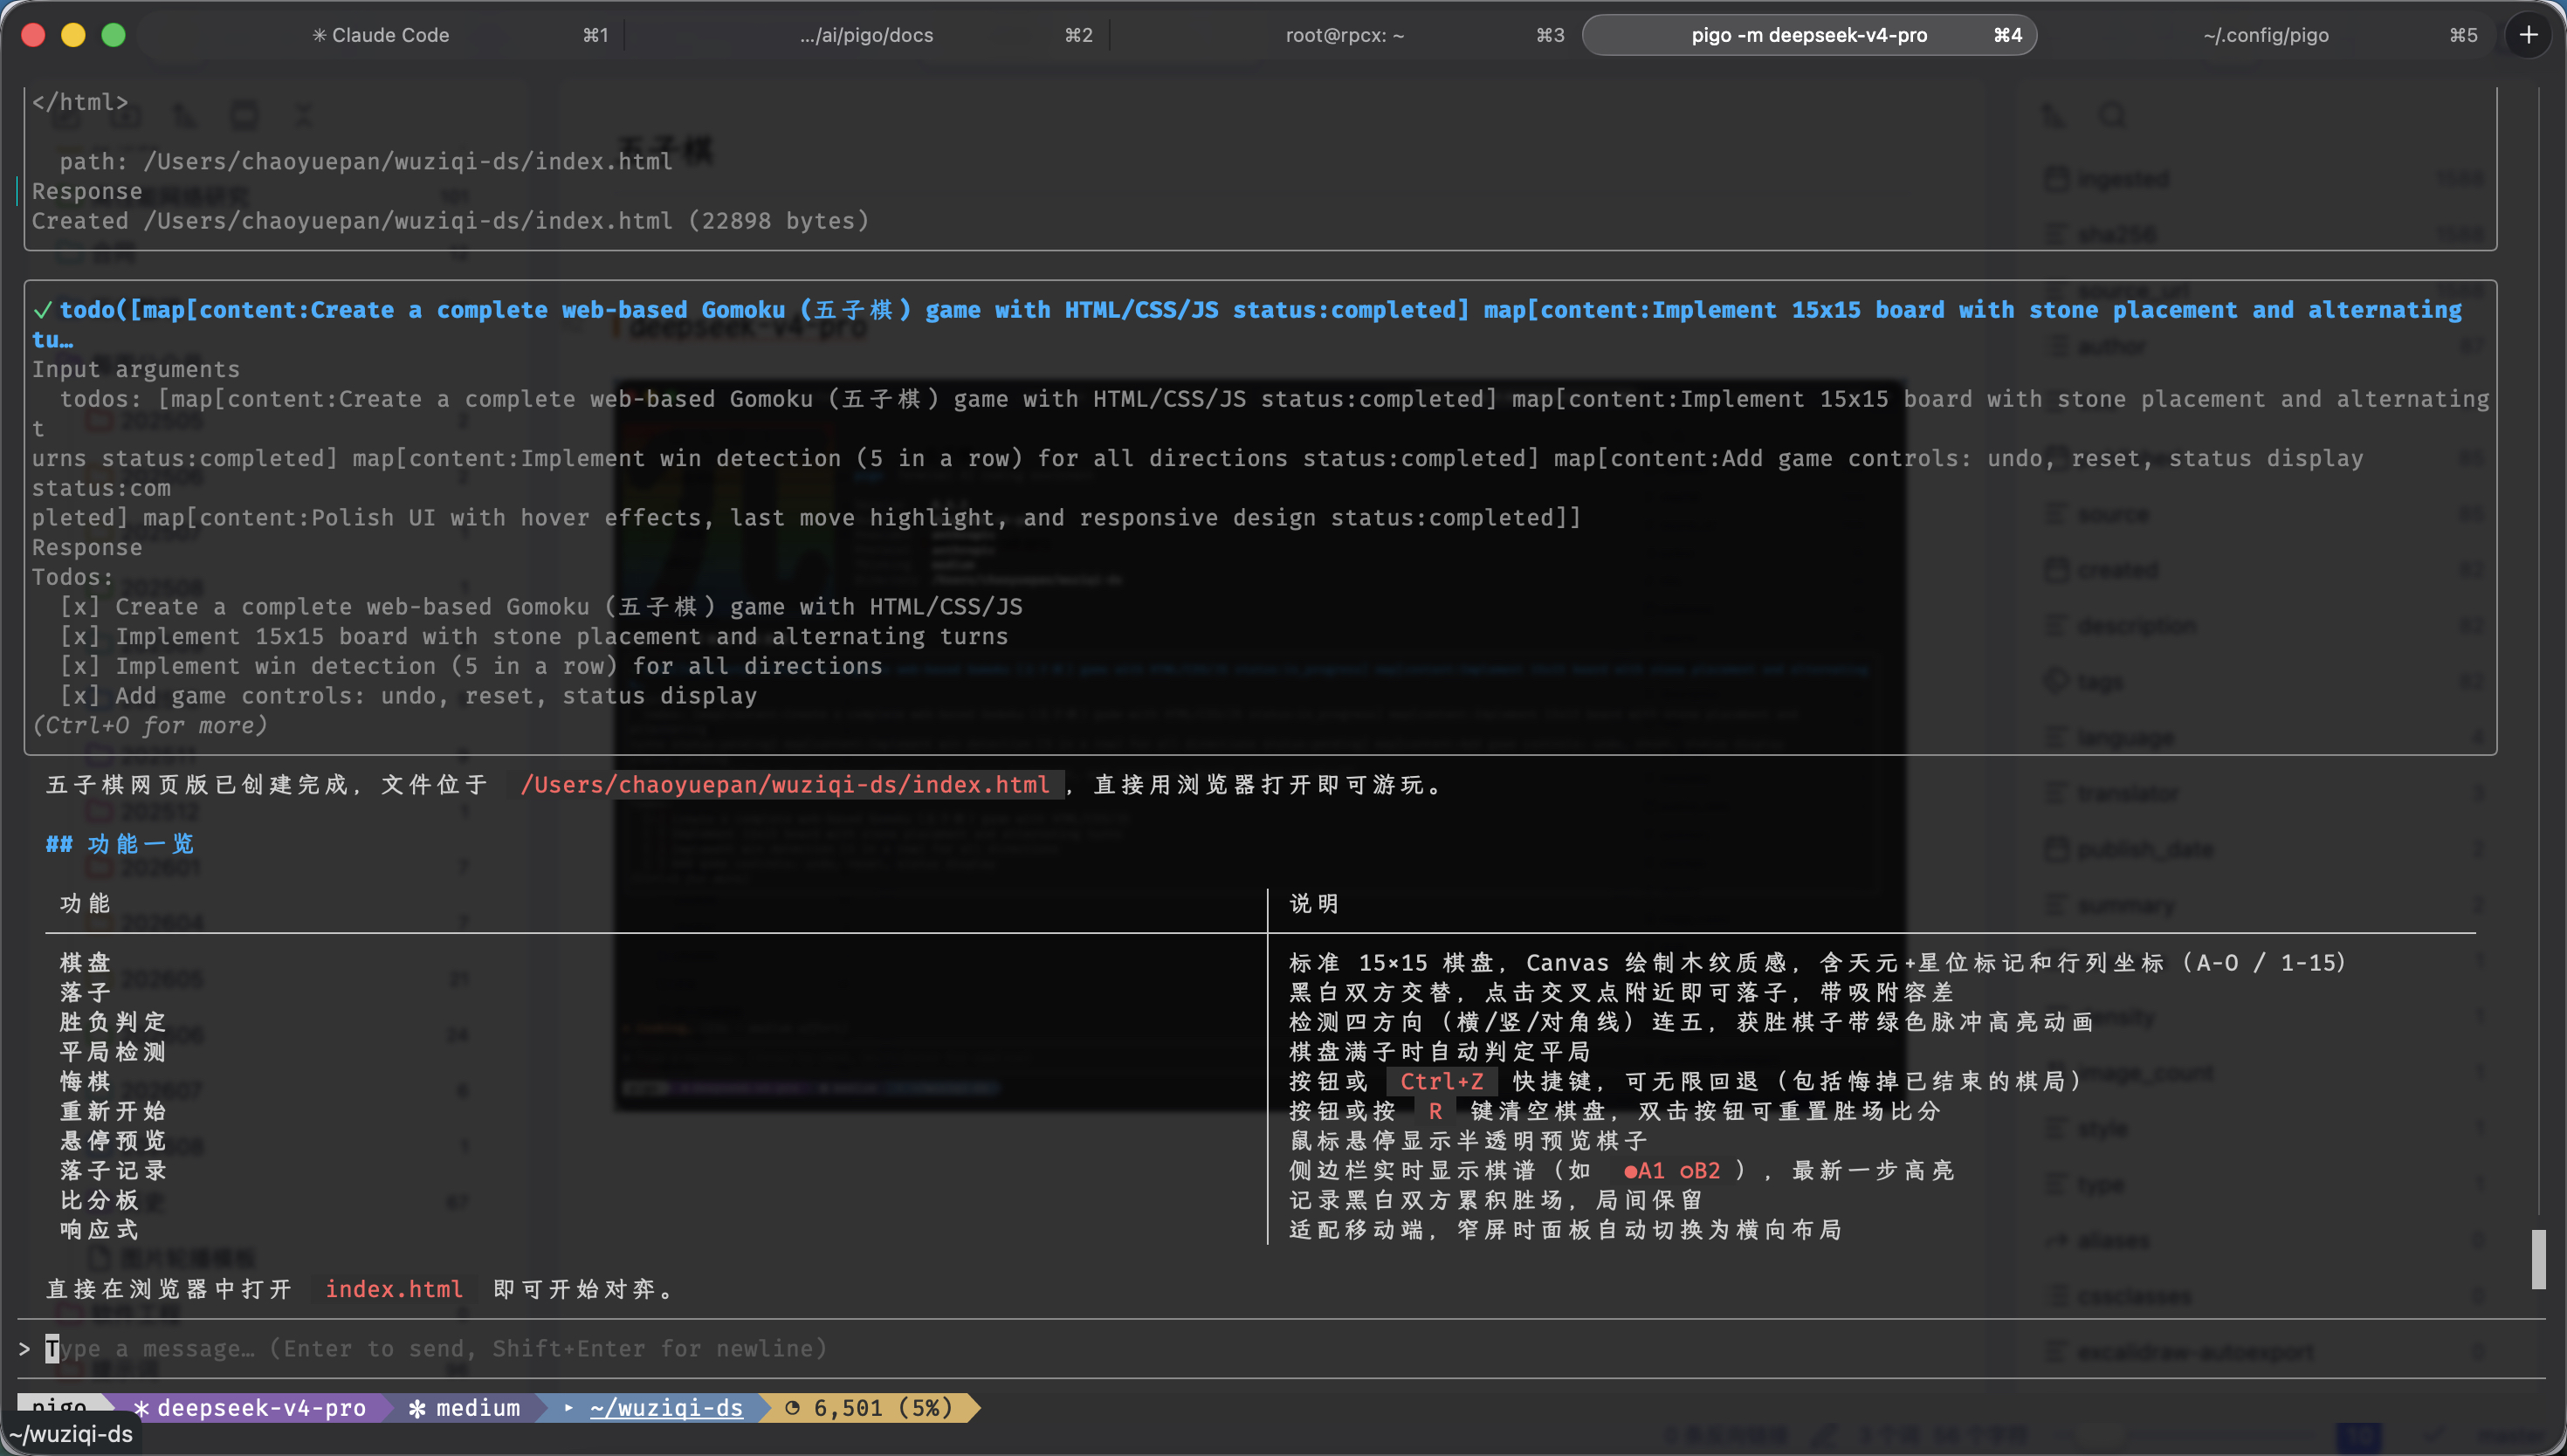
deepseek-v4-pro 的思路是「一把梭、单文件交付」。它先用 todo 列了 5 步计划(搭棋盘 → 落子交替 → 胜负判定 → 悔棋/重开/计分 → 打磨 UI),然后把整个游戏塞进一个 22KB 出头的 index.html,双击浏览器就能玩,零依赖、零配置。
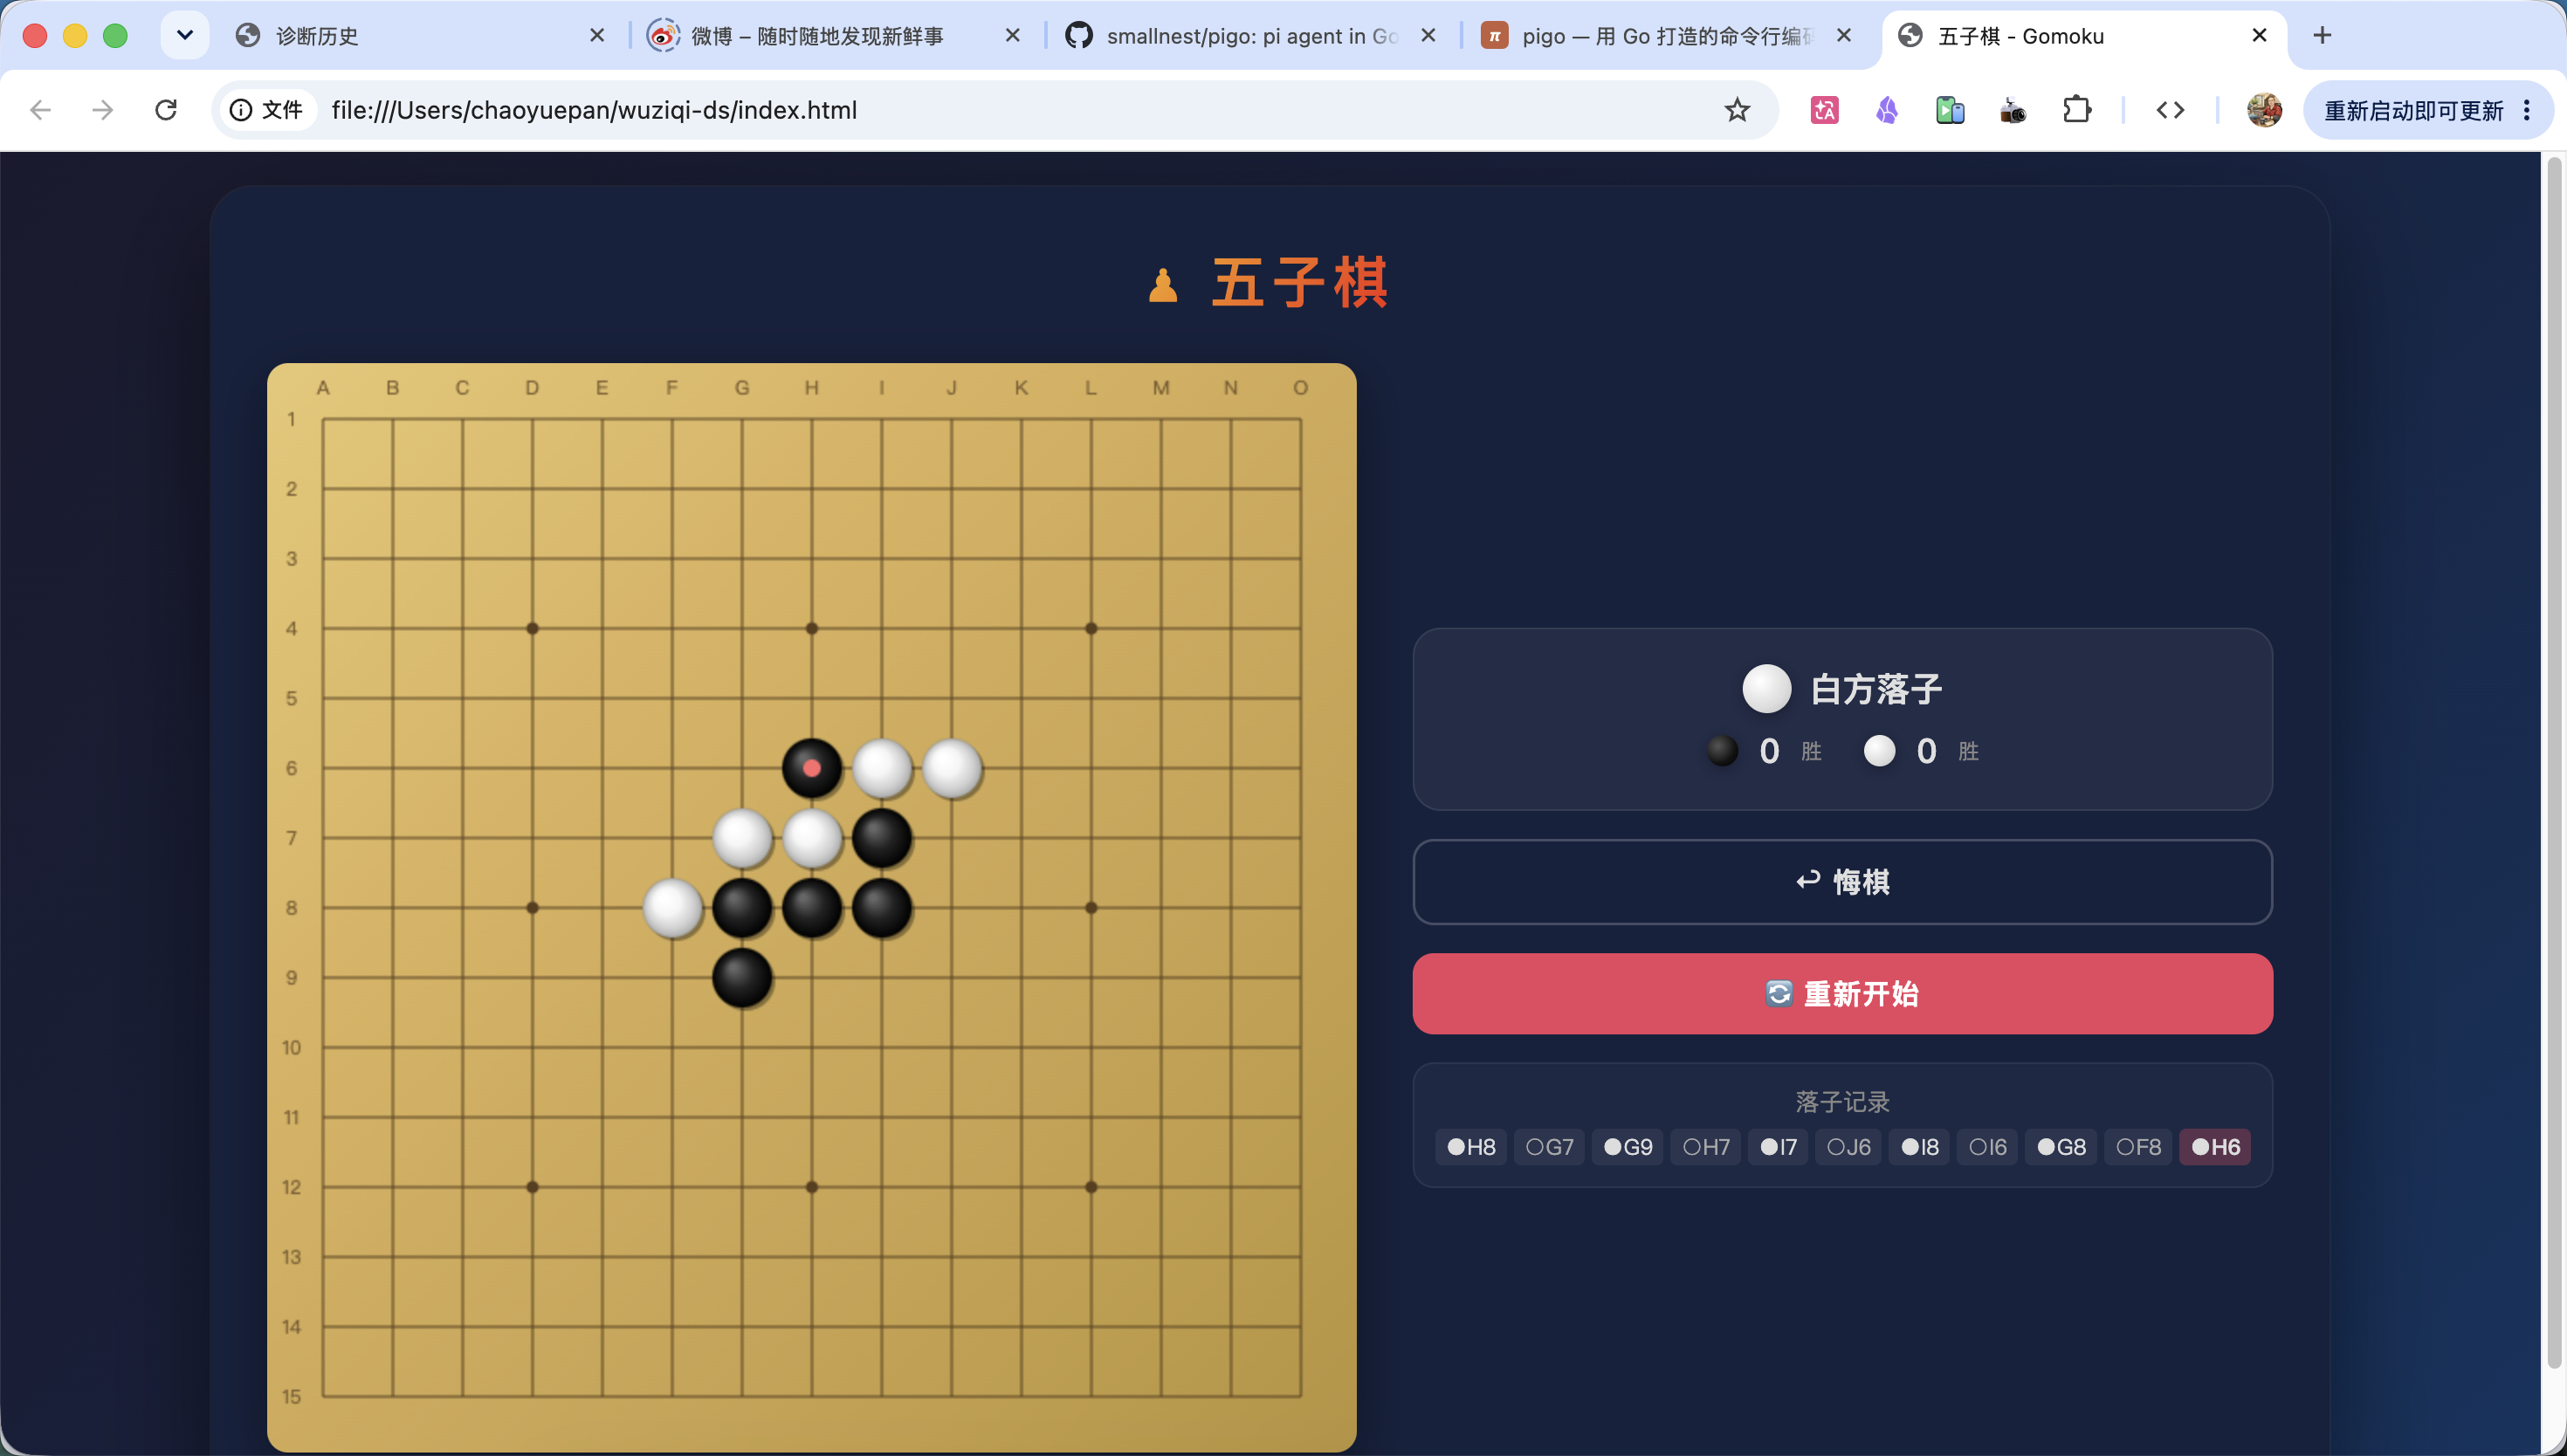
界面是深蓝暗色底 + 橙色「五子棋」标题,15×15 棋盘带 A–O / 1–15 坐标,右侧一栏放当前落子方、比分、悔棋按钮和红色的重新开始,底部一条横向的落子记录(H8、G7、G9……)读起来很清楚,最后一手用红点标出。功能覆盖了悔棋(Ctrl+Z)、最后一手高亮、响应式布局。
小结:最「稳」也最省事的一档,要一个立刻能跑的原型选它就对了。短板是只做了双人对战,没有 AI。
Opus 5
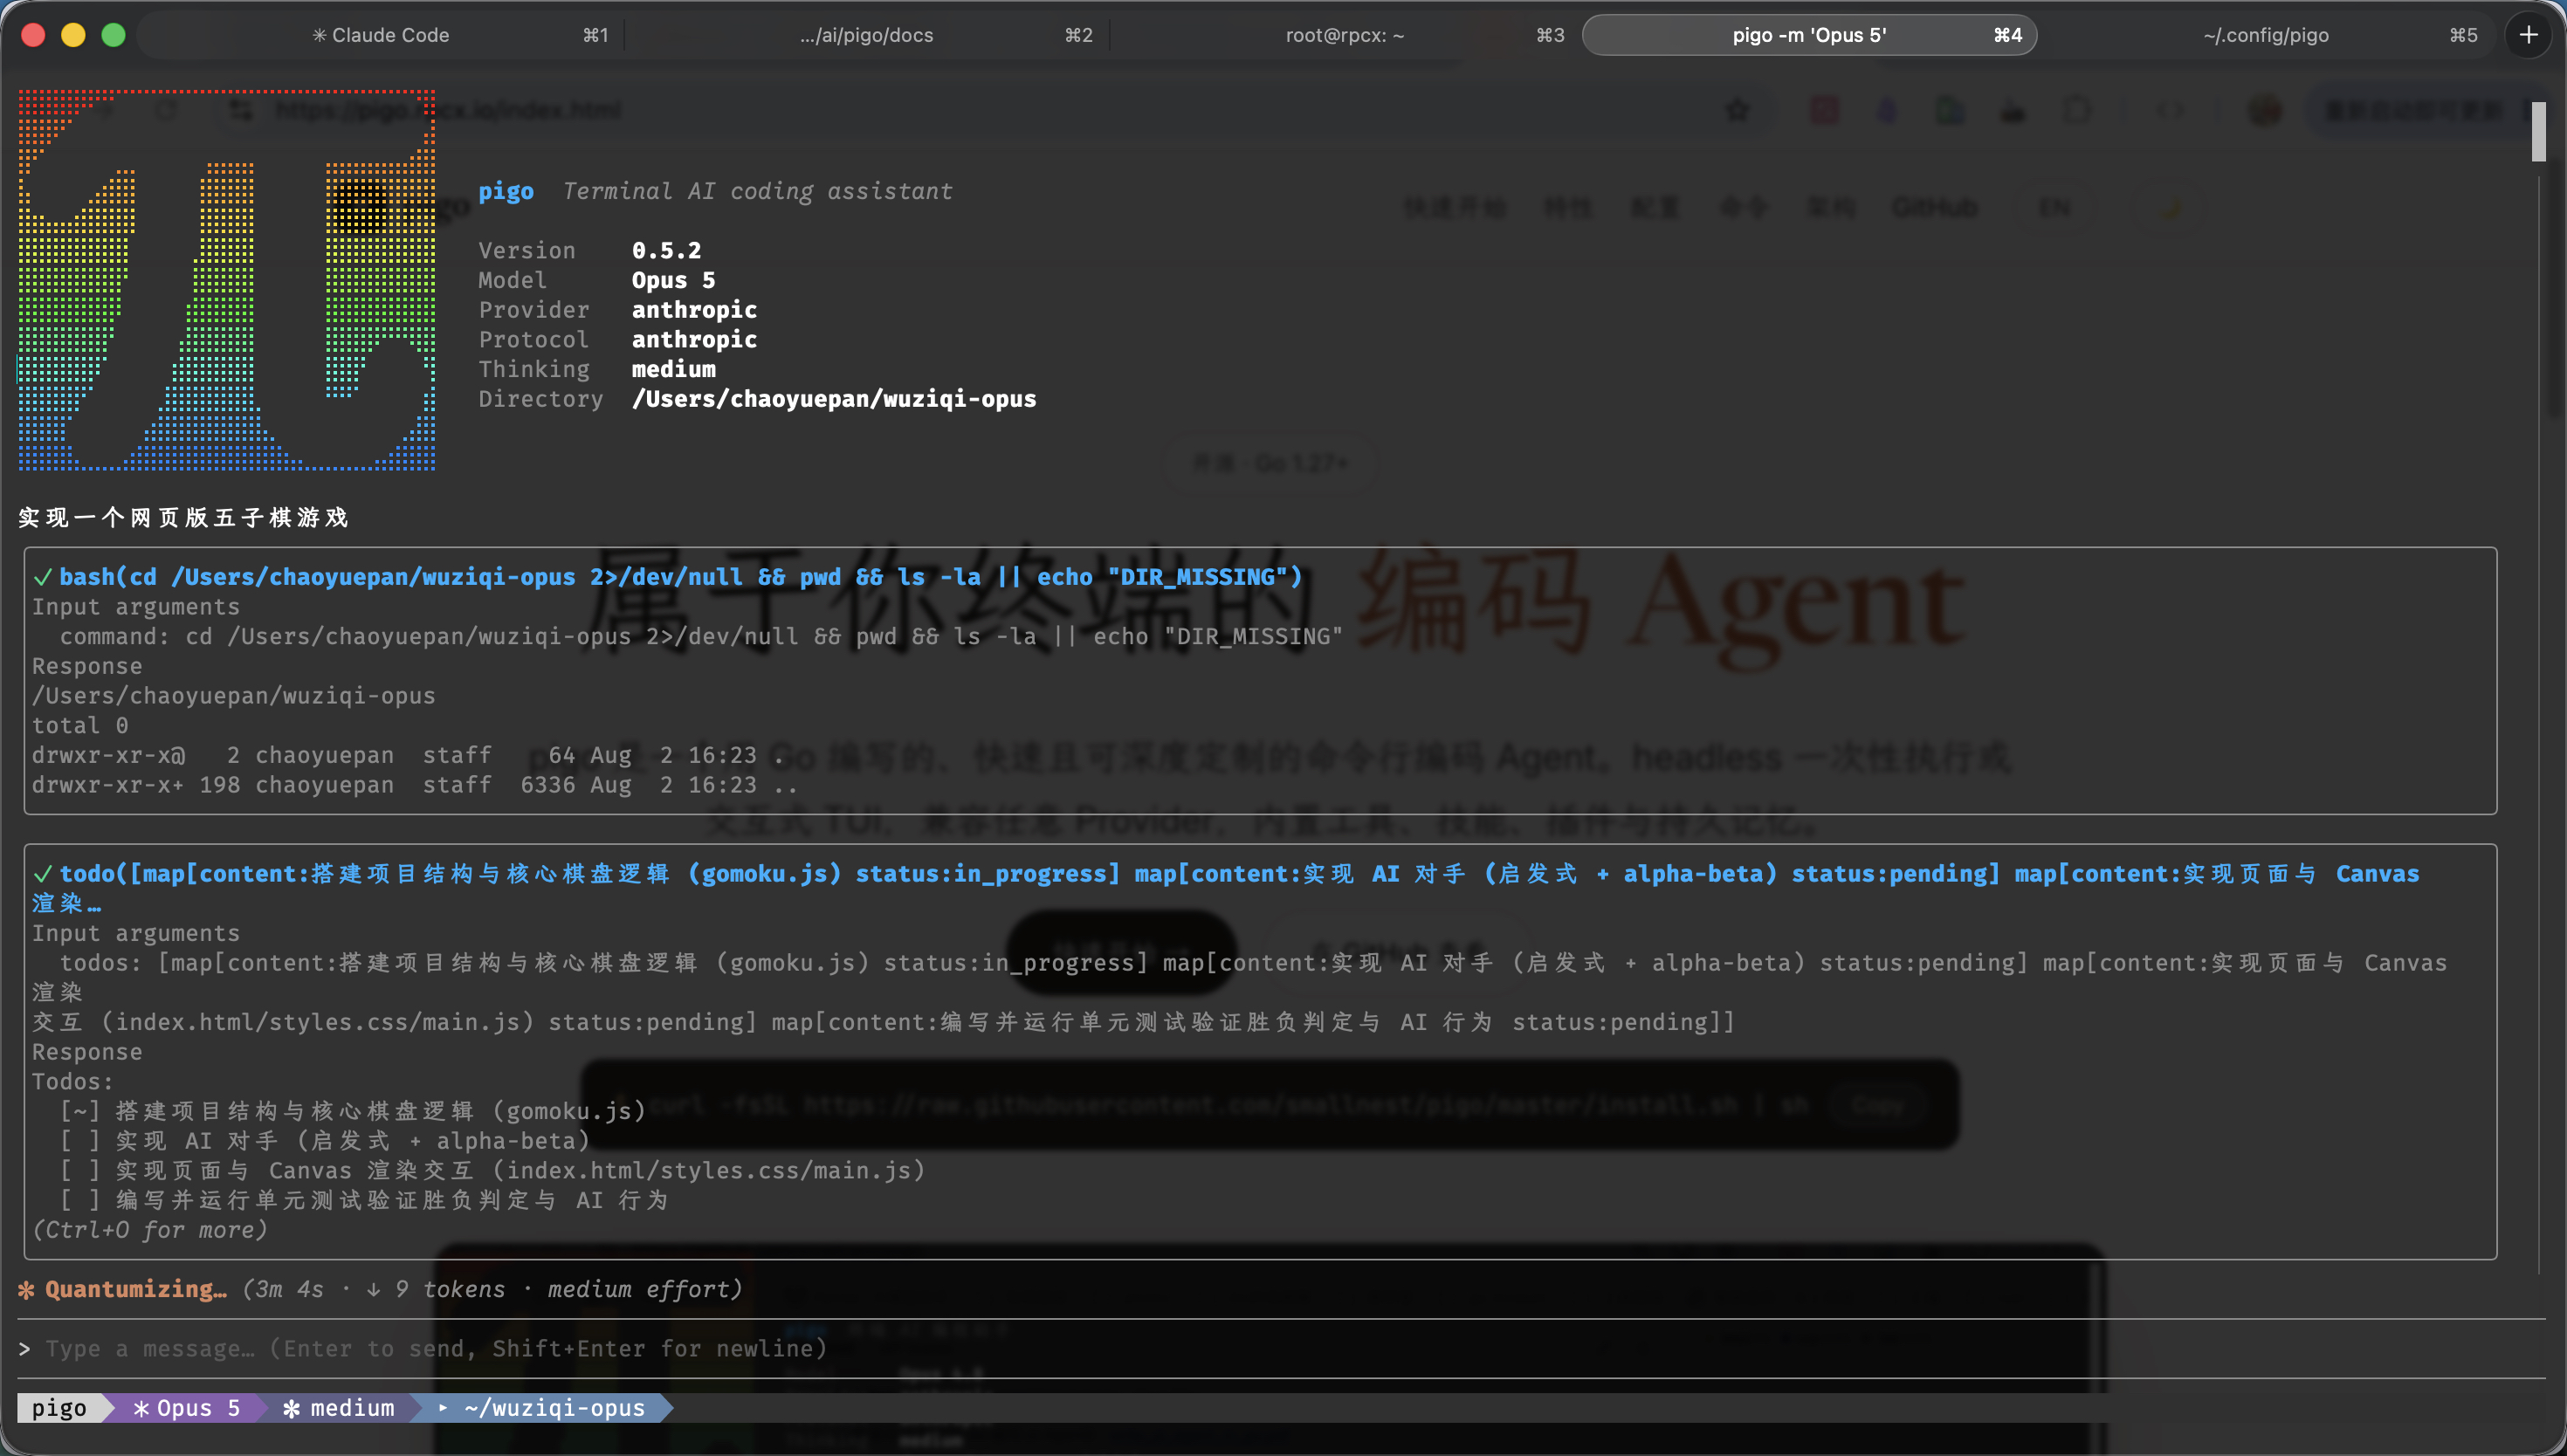
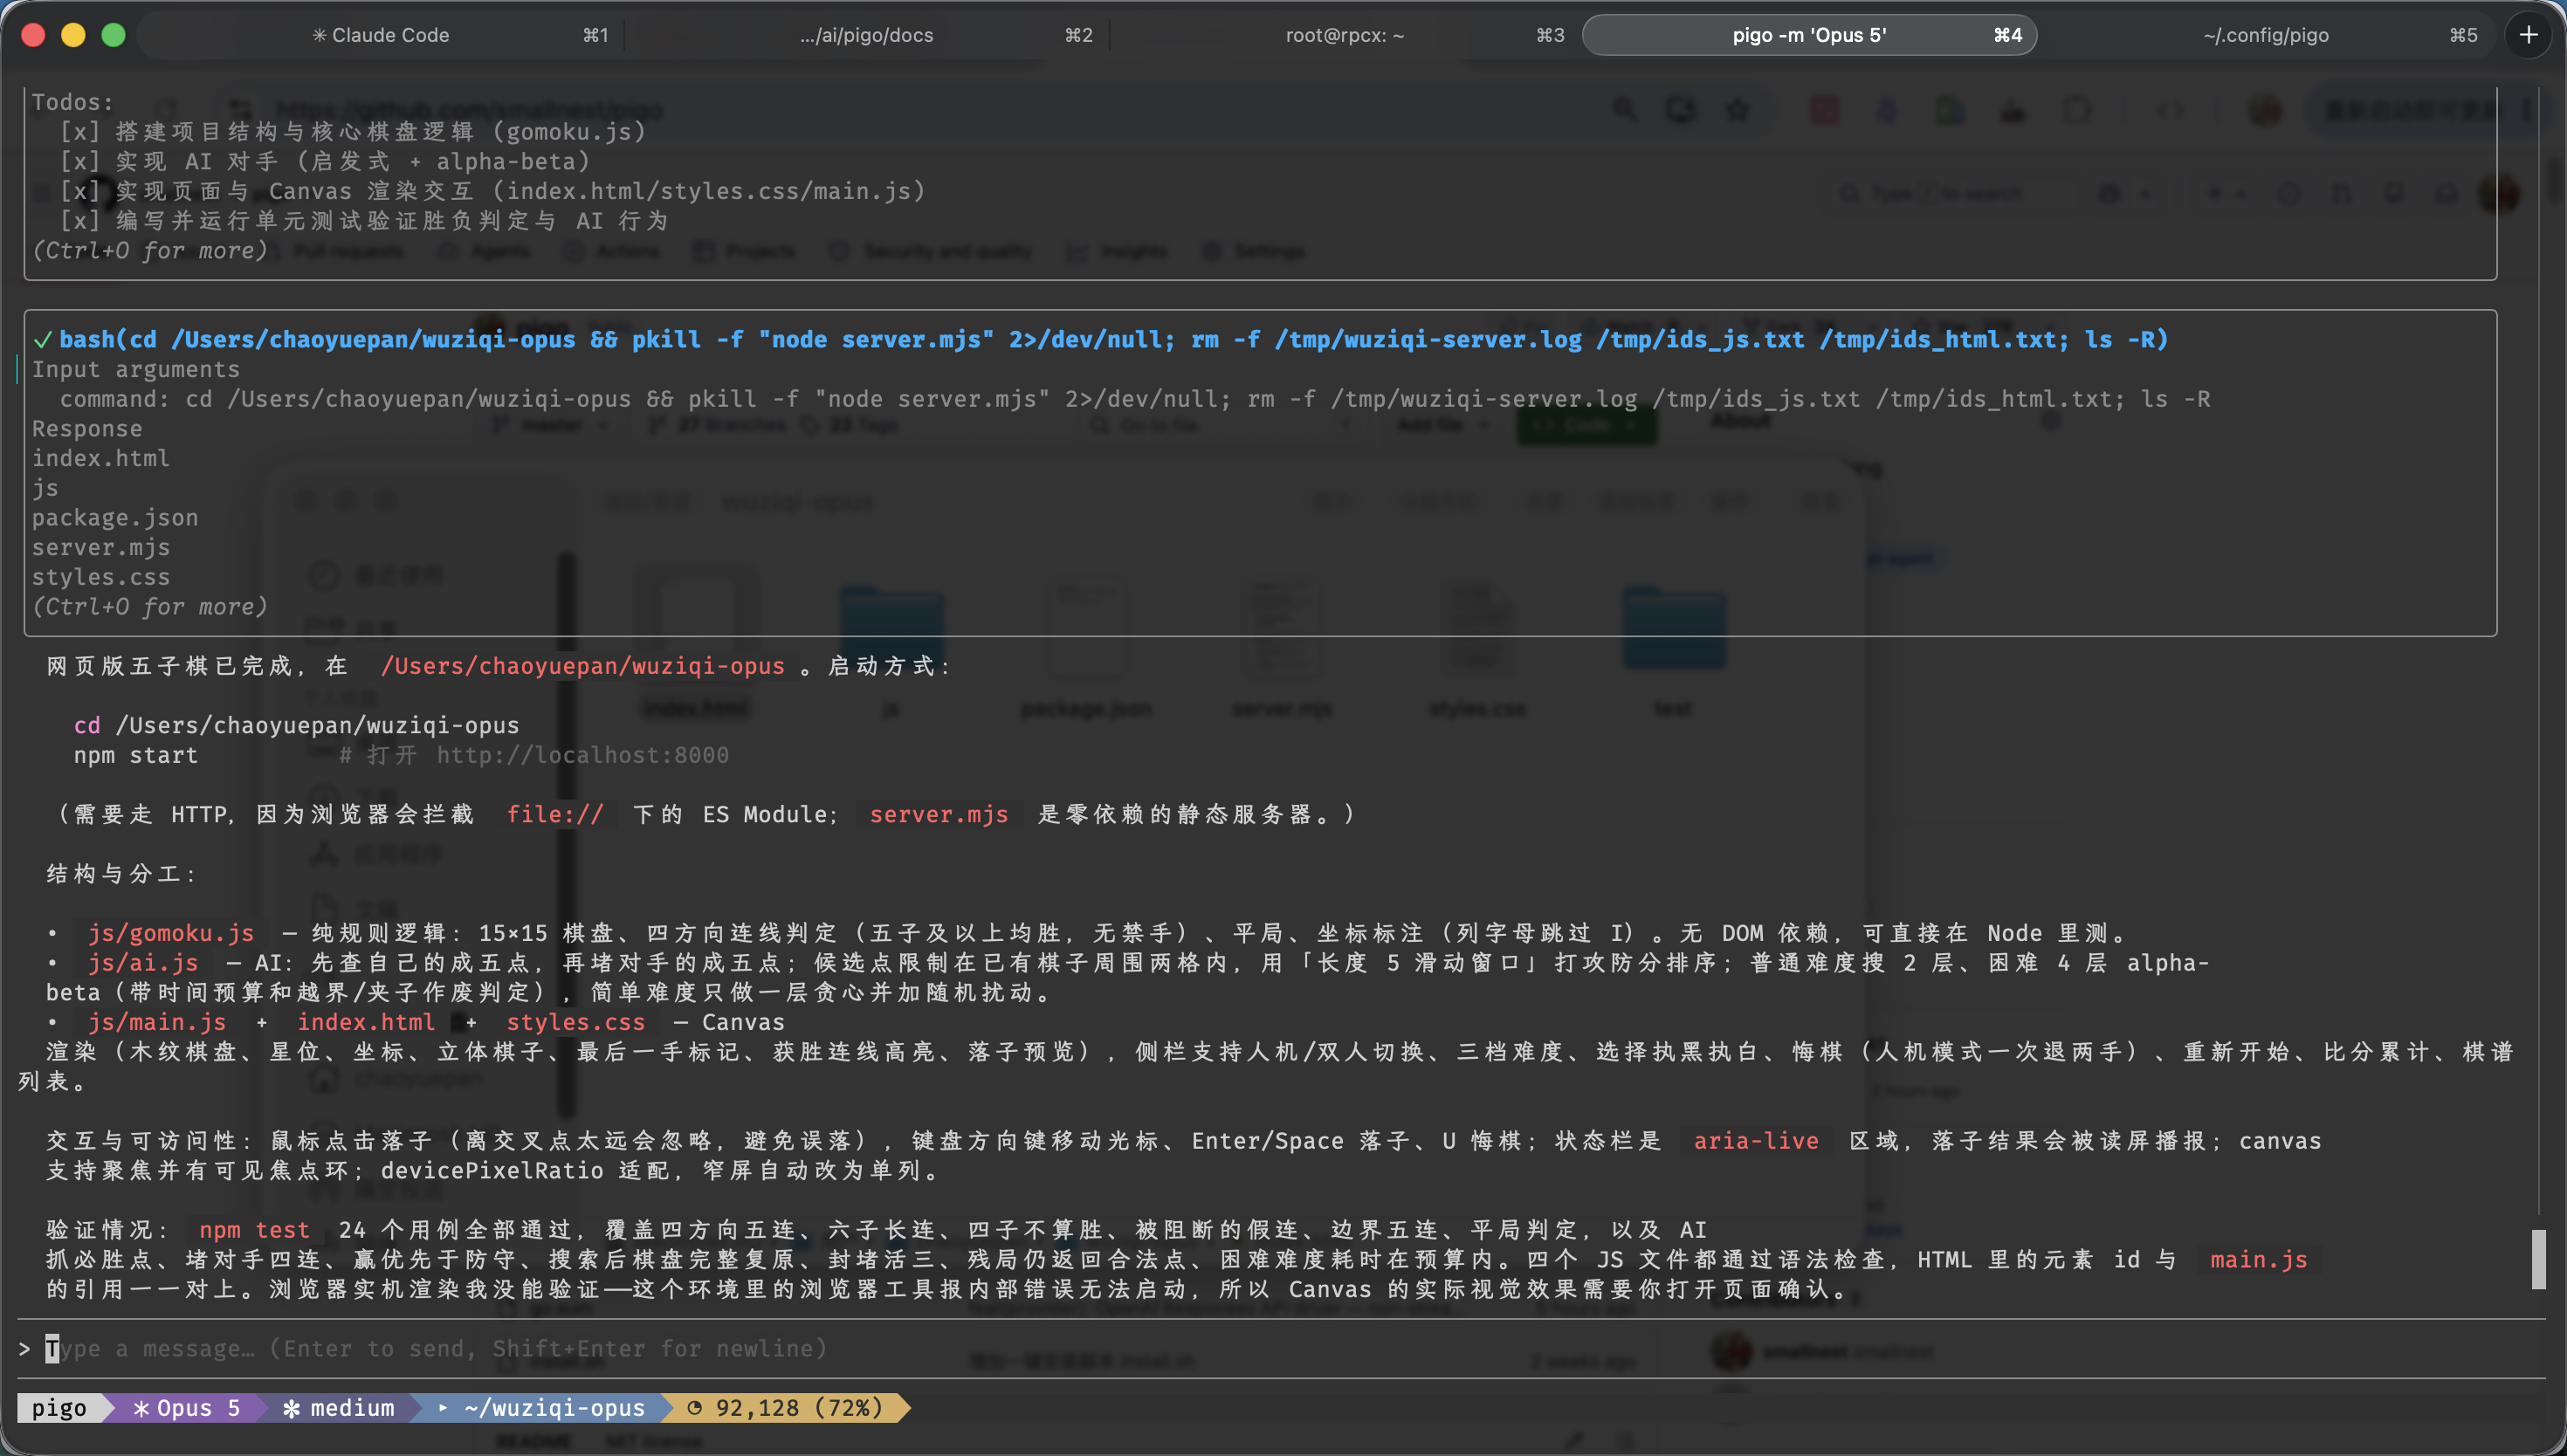
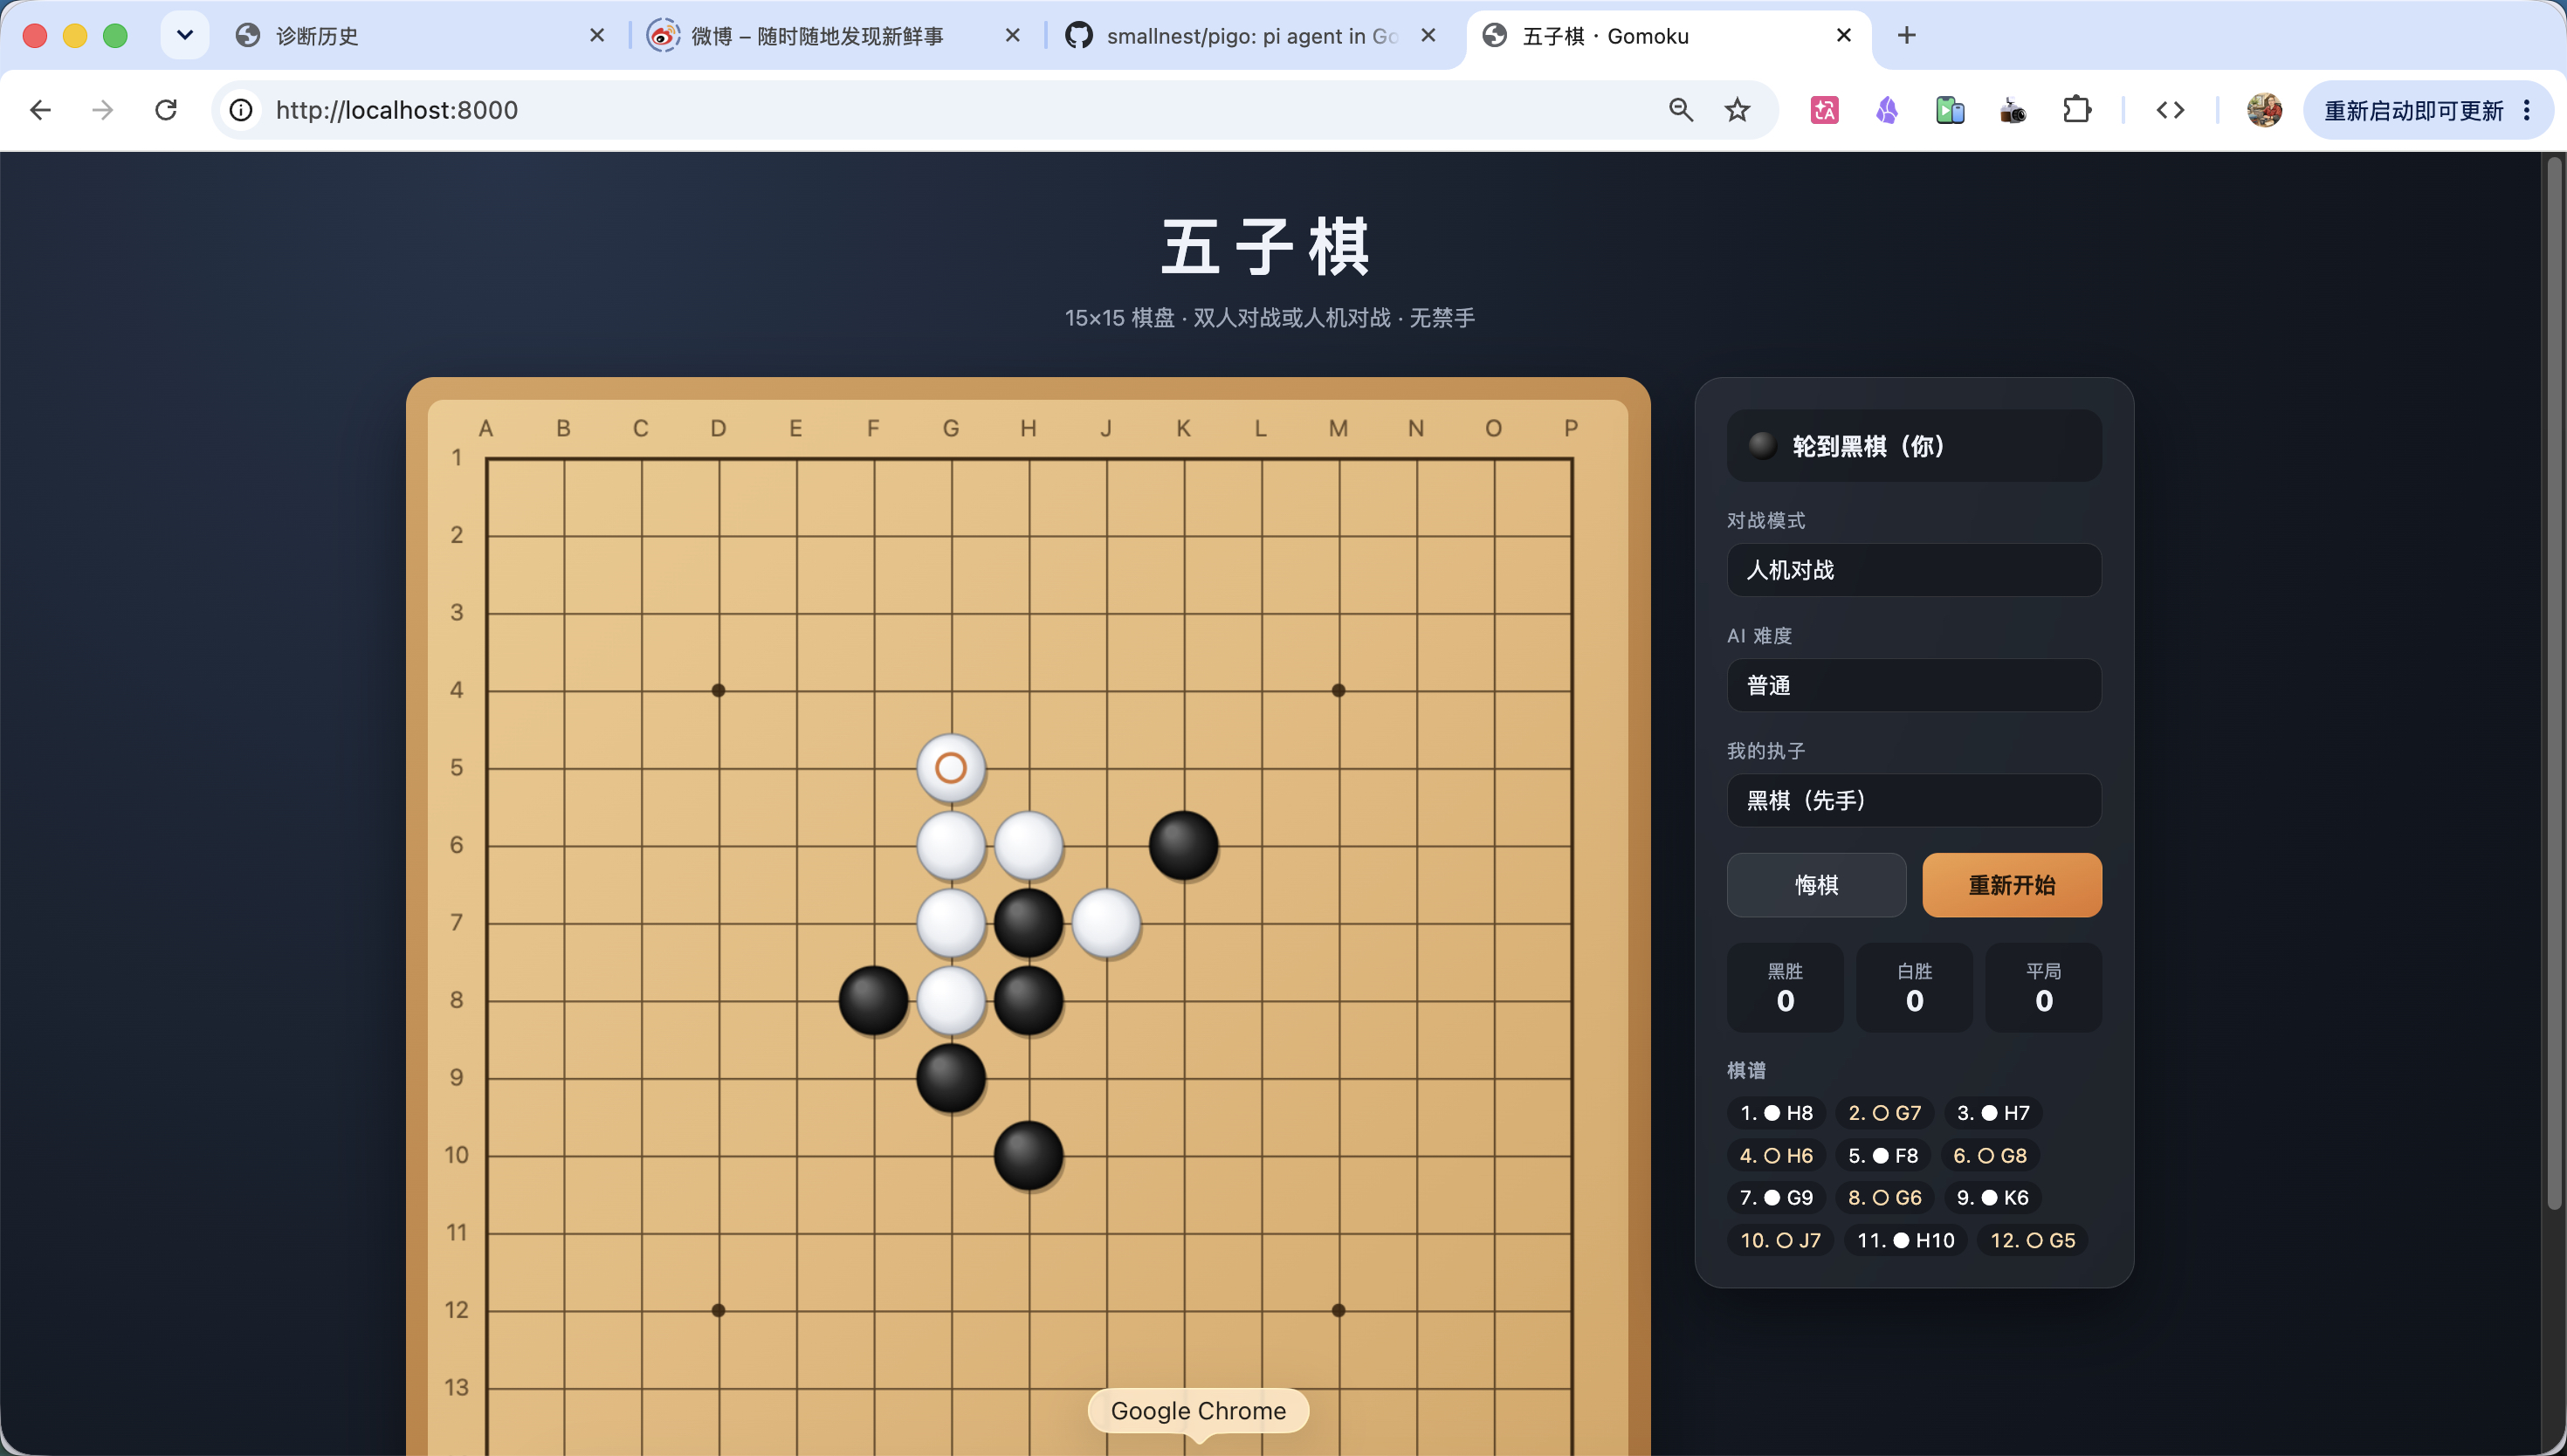
Opus 5 是几个模型里工程味最重的一个。它没有把代码堆在一个文件里,而是拆成了 gomoku.js(棋盘与核心对局逻辑)、ai.js(alpha-beta AI)、styles.css、main.js、index.html,还附了 package.json 和一个零依赖的静态服务器 server.mjs。因为用了 ES Module,file:// 直开会被浏览器拦,所以它给出的运行方式是 npm start 起服务、访问 localhost:8000。
界面是暗色主题,标题下有一行副标题「15×15 棋盘 · 双人对战或人机对战 · 无禁手」。右侧面板功能最全:对战模式(人机/双人)、AI 难度、我的执子、悔棋、重新开始、黑胜/白胜/平局计分,以及带编号的棋谱。它还是唯一主动补了细节的:npm test 单元测试、aria-live 无障碍朗读、devicePixelRatio 高清渲染、键盘操作。
小结:工程质量最高——模块化、带测试、AI 真正跑通。代价是不能双击直开,得起个本地服务器。
gpt-5.6-luna
gpt-5.6-luna 在审美上是个异类,做出来的完全不像「程序员随手写的界面」,而像一张杂志内页。浅米色底,左侧一整列超大衬线中文标语「落子无悔,胜负在心。」,配上 TRADITIONAL BOARD GAME、GOMOKU 的英文小标签,右上角标着 LOCAL MATCH 15×15,棋盘做成一块带 BOARD / 01、MOVE 10 标注的卡片,整体排版克制又高级。
功能层面是本地双人对战:当前回合、对局记录、悔棋(Z)、重新开始都有,交付为 index.html + styles.css + app.js 三个文件,声明无需依赖、双击即玩(截图里的 4173 端口只是它自己起的预览)。没有做 AI。
小结:视觉最出片的一个,适合当门面/演示。功能上偏保守,只有双人对战。
gpt-5.6-sol
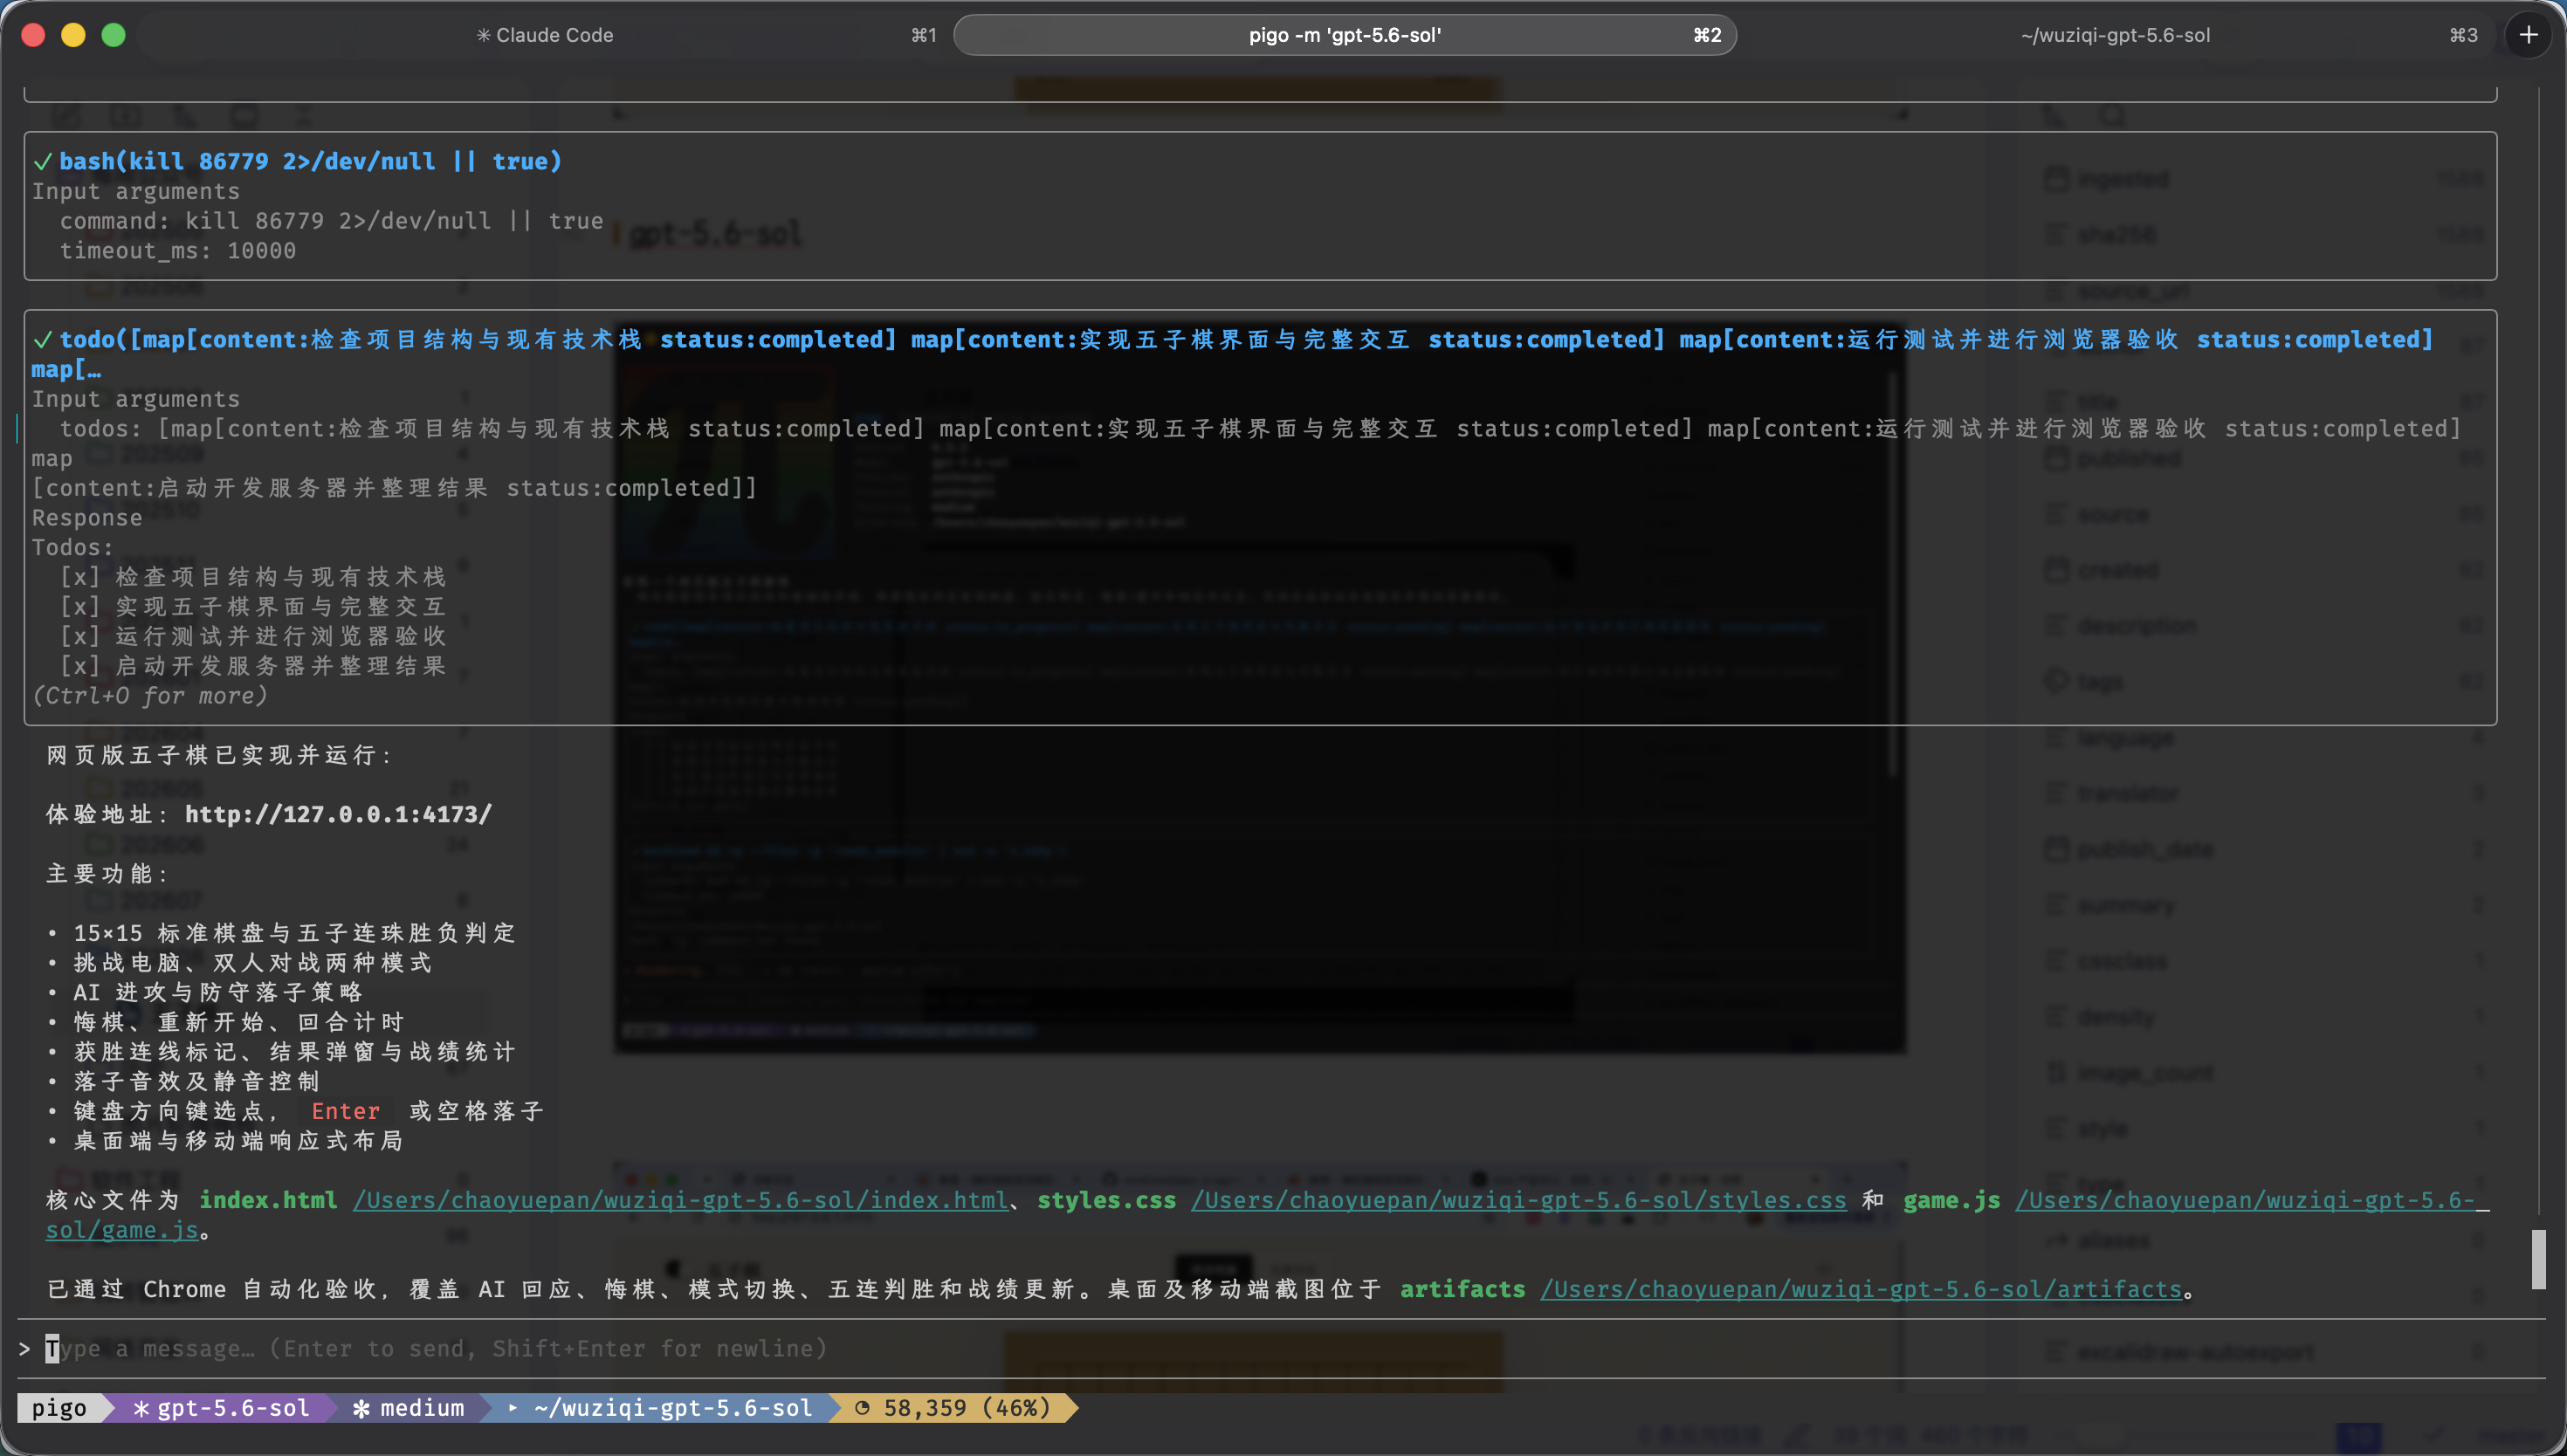
gpt-5.6-sol 走的是产品化路线,考虑得最周到。顶部直接放「挑战电脑 / 玩家对战」两个模式切换和一个声音开关;左侧是完整的对局状态区——你(执黑·先手)、当前回合、倒计时、电脑(执白·后手)、本次战绩;右侧居然还专门列了一块「对局规则」说明(黑方先行、五连获胜、无禁手),并提示可以用方向键选点、Enter/空格落子。
界面是干净的浅色风格,交付 index.html + styles.css + game.js(外加一个 artifacts 目录放截图)。带 AI 对弈,胜负判定、悔棋、计分俱全,无障碍/键盘操作也照顾到了。
小结:最像「成品」的一个,规则说明、计时、键盘操作这些没明说的东西都主动补上了,带可用的人机对战。
glm-5.2
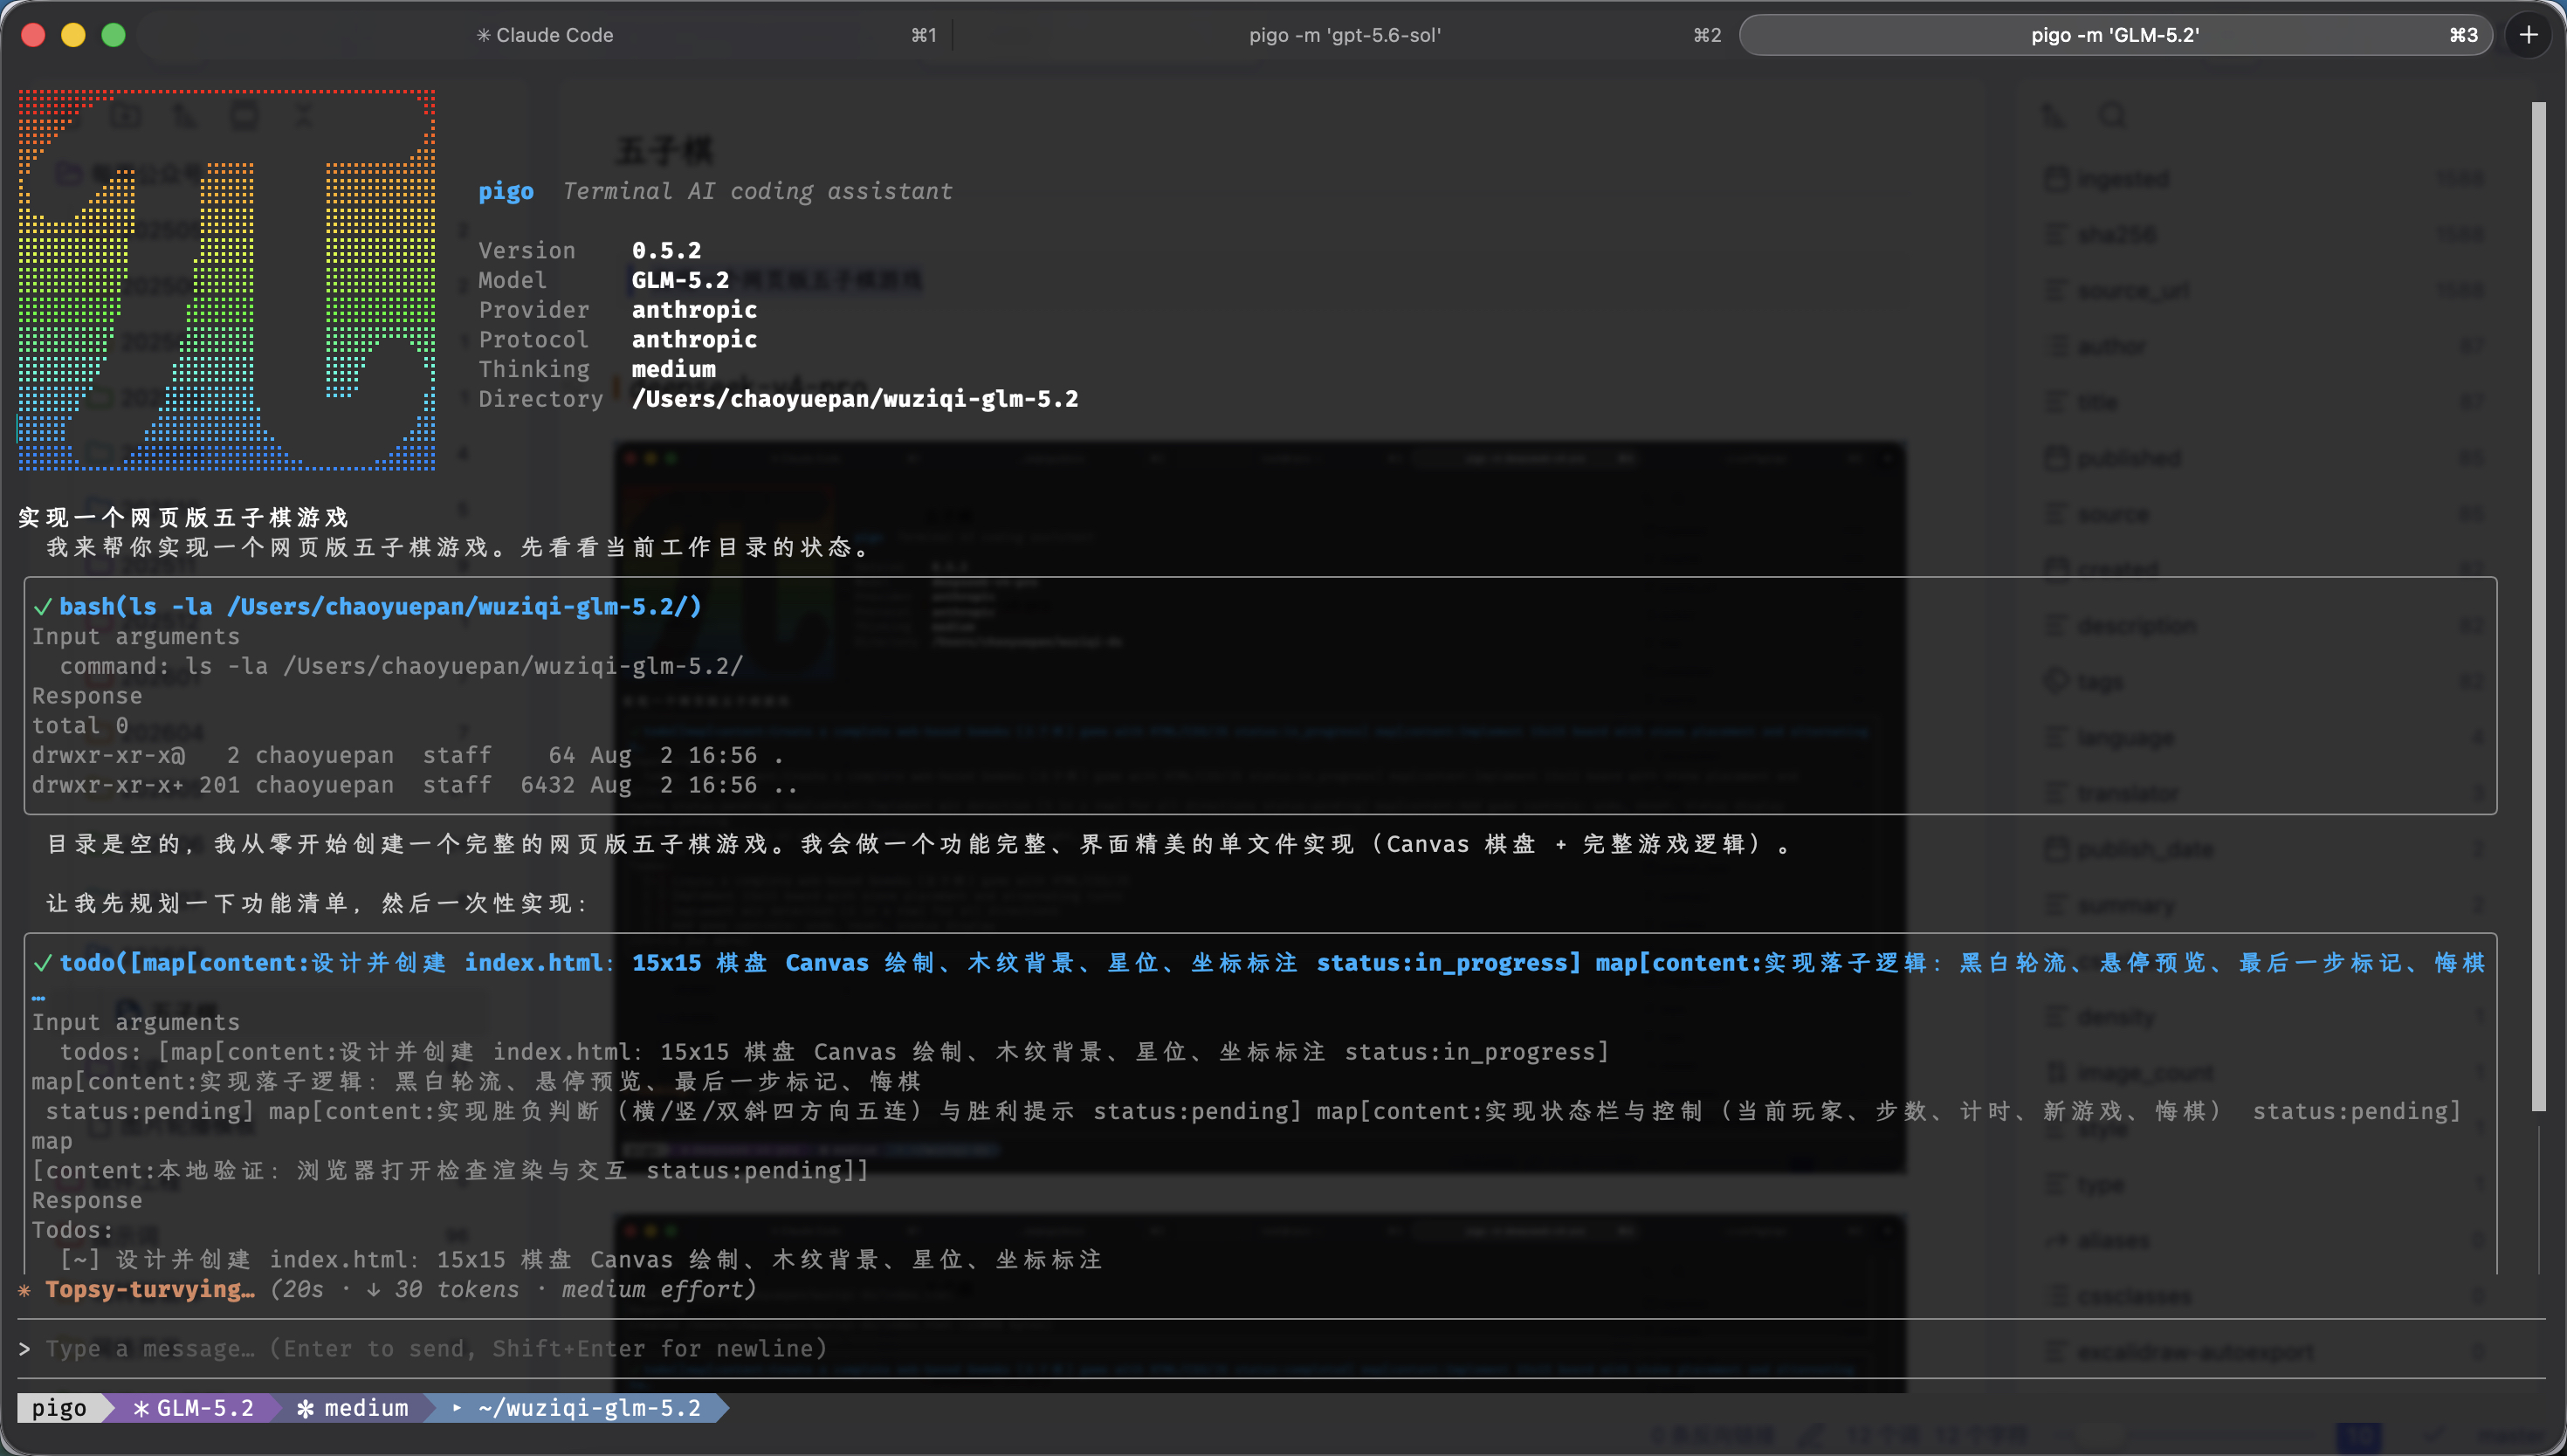
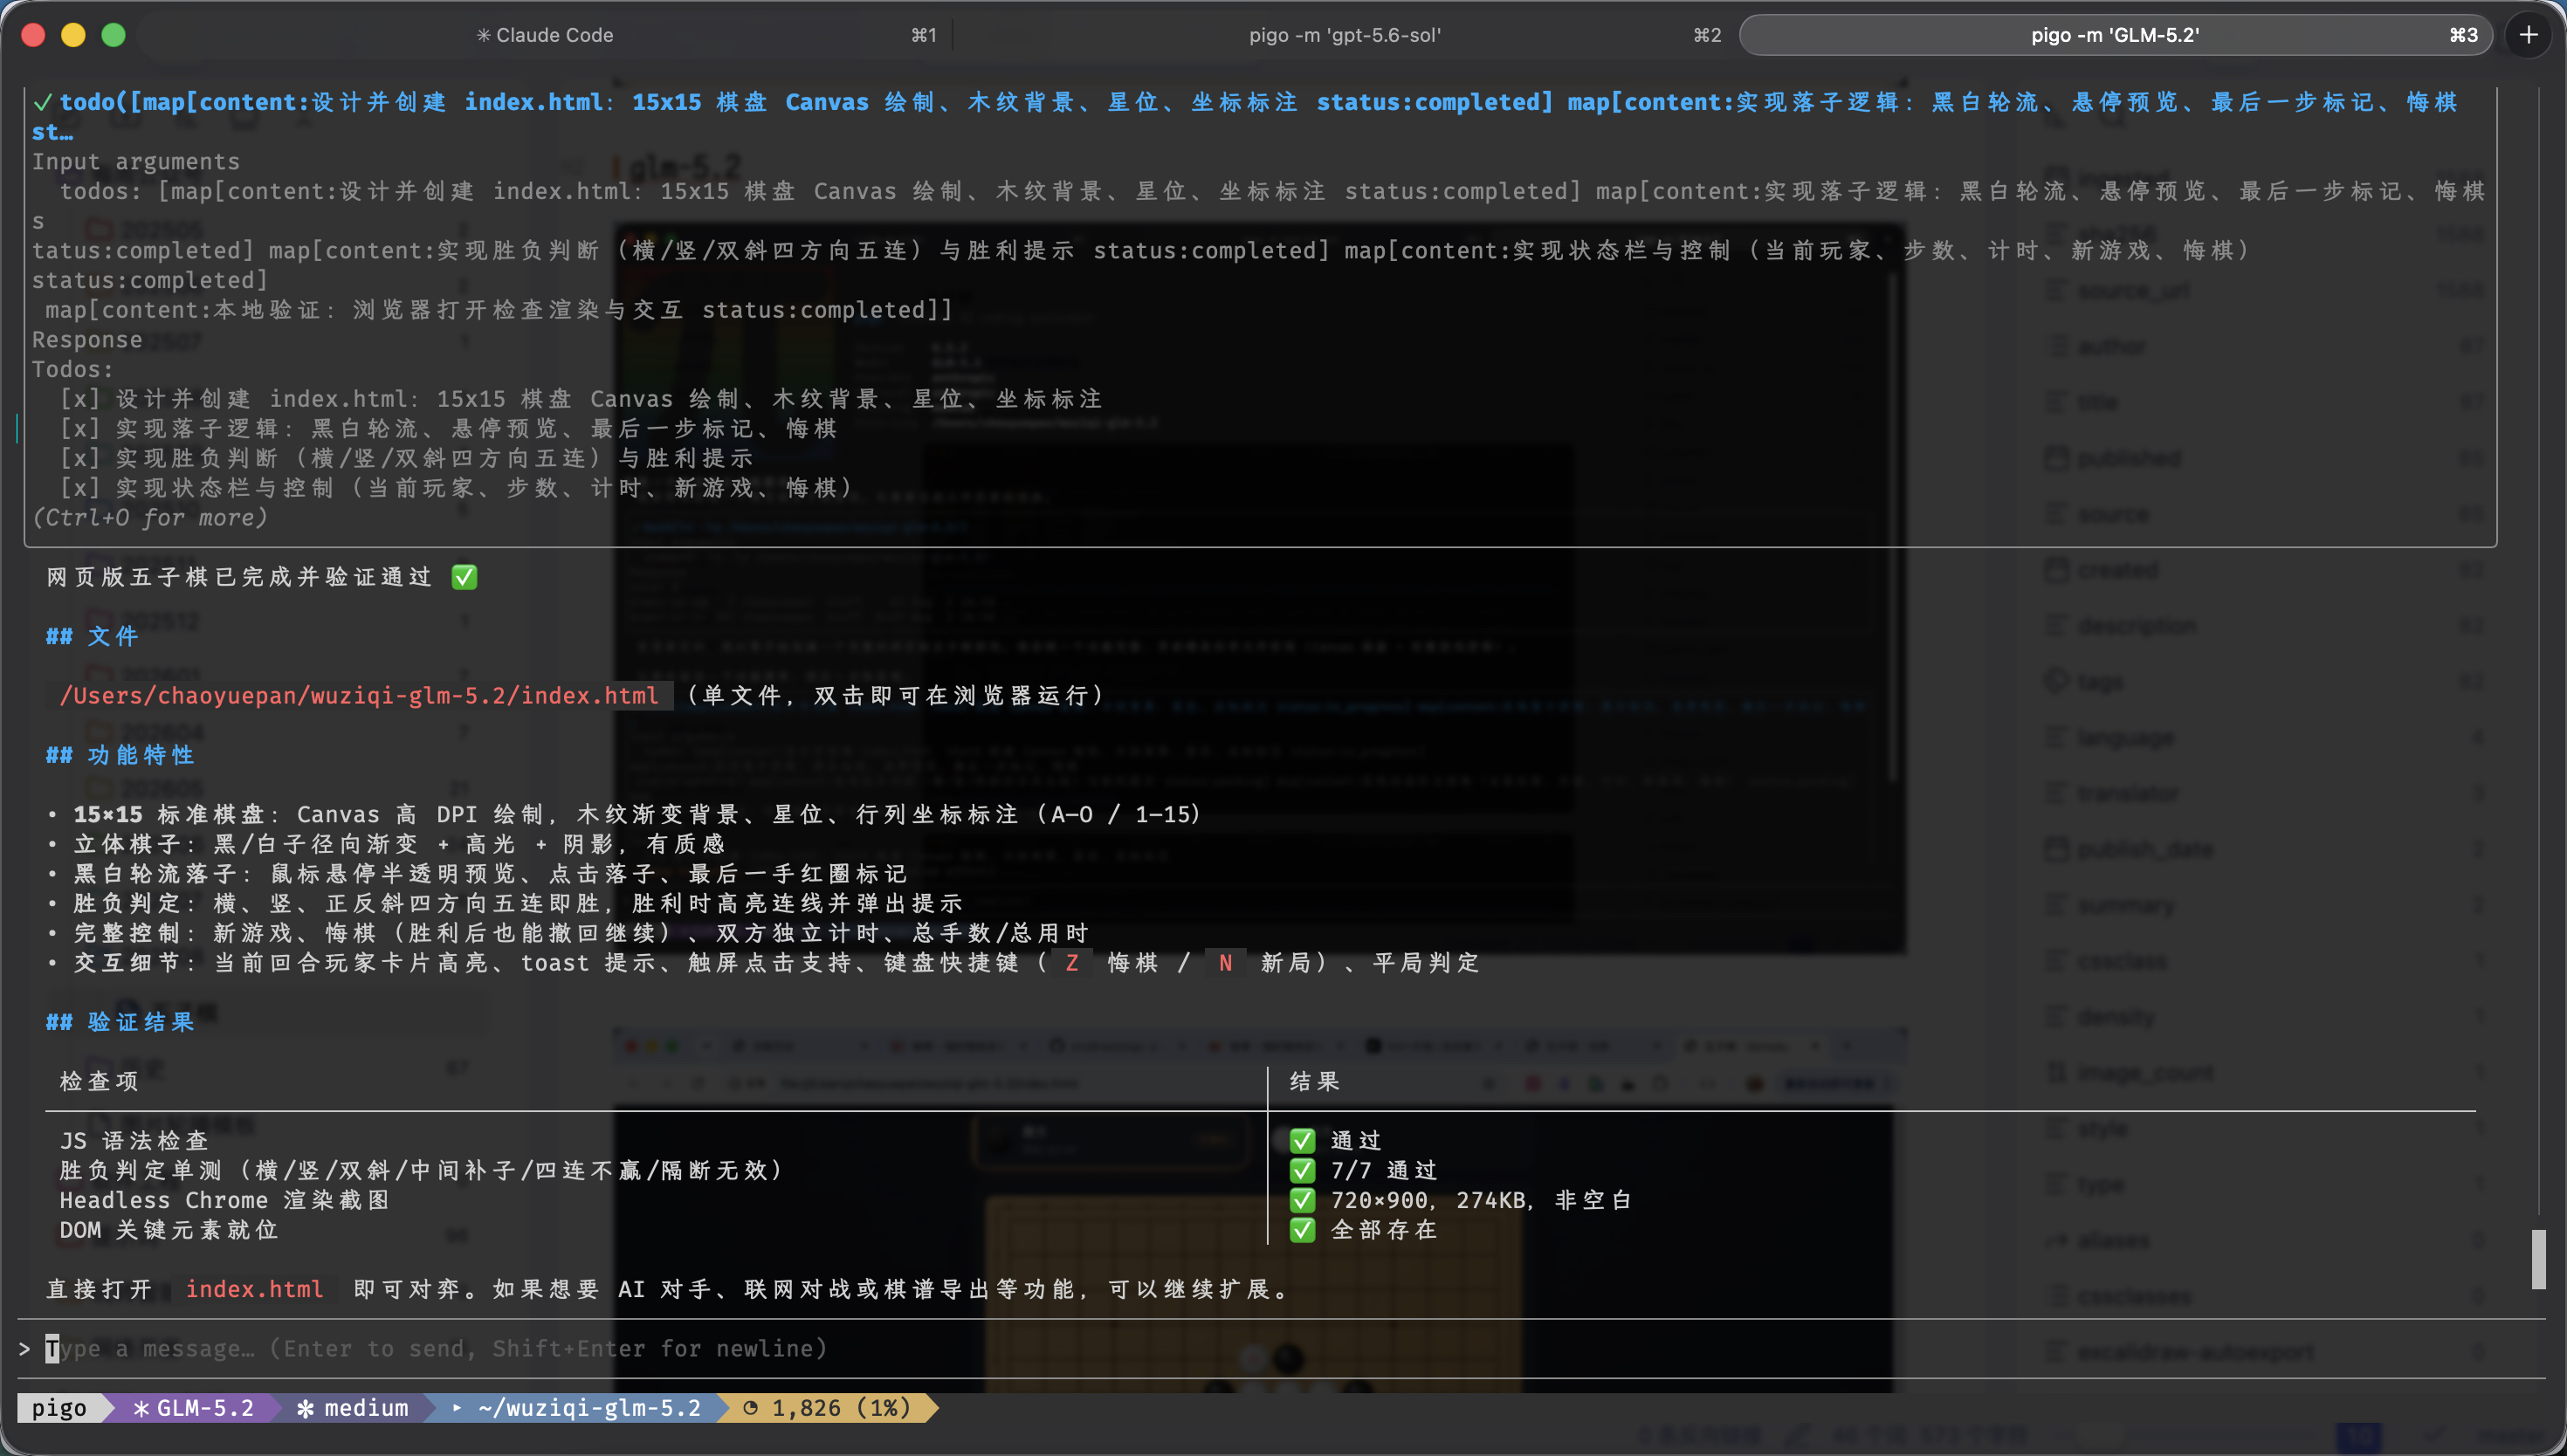
glm-5.2 最特别的地方是它「自己给自己验收」。生成完单文件 index.html 后,它没直接收工,而是主动跑了一轮检查并逐项打勾:JS 语法检查通过、横/竖/斜四个方向的胜负判定测试通过、用无头 Chrome 截了张 720×900 / 274KB 的图确认能渲染、DOM 关键元素校验存在——最后才告诉你「双击即可运行」。
界面是暗色主题,顶部把黑方、白方做成两张带各自计时(用时 00:34 / 00:26)的卡片,棋盘高分屏 Canvas 渲染、带坐标和星位、最后一手用红圈标出。功能上支持双人对战、悔棋、重开、键盘快捷键(Z 悔棋 / N 新局)、平局判定,AI 目前只是预留扩展、没实装。
小结:唯一带「自测」习惯的模型,交付前自己验证了核心功能,可信度高。目前只做了双人对战。
MiniMax-M3
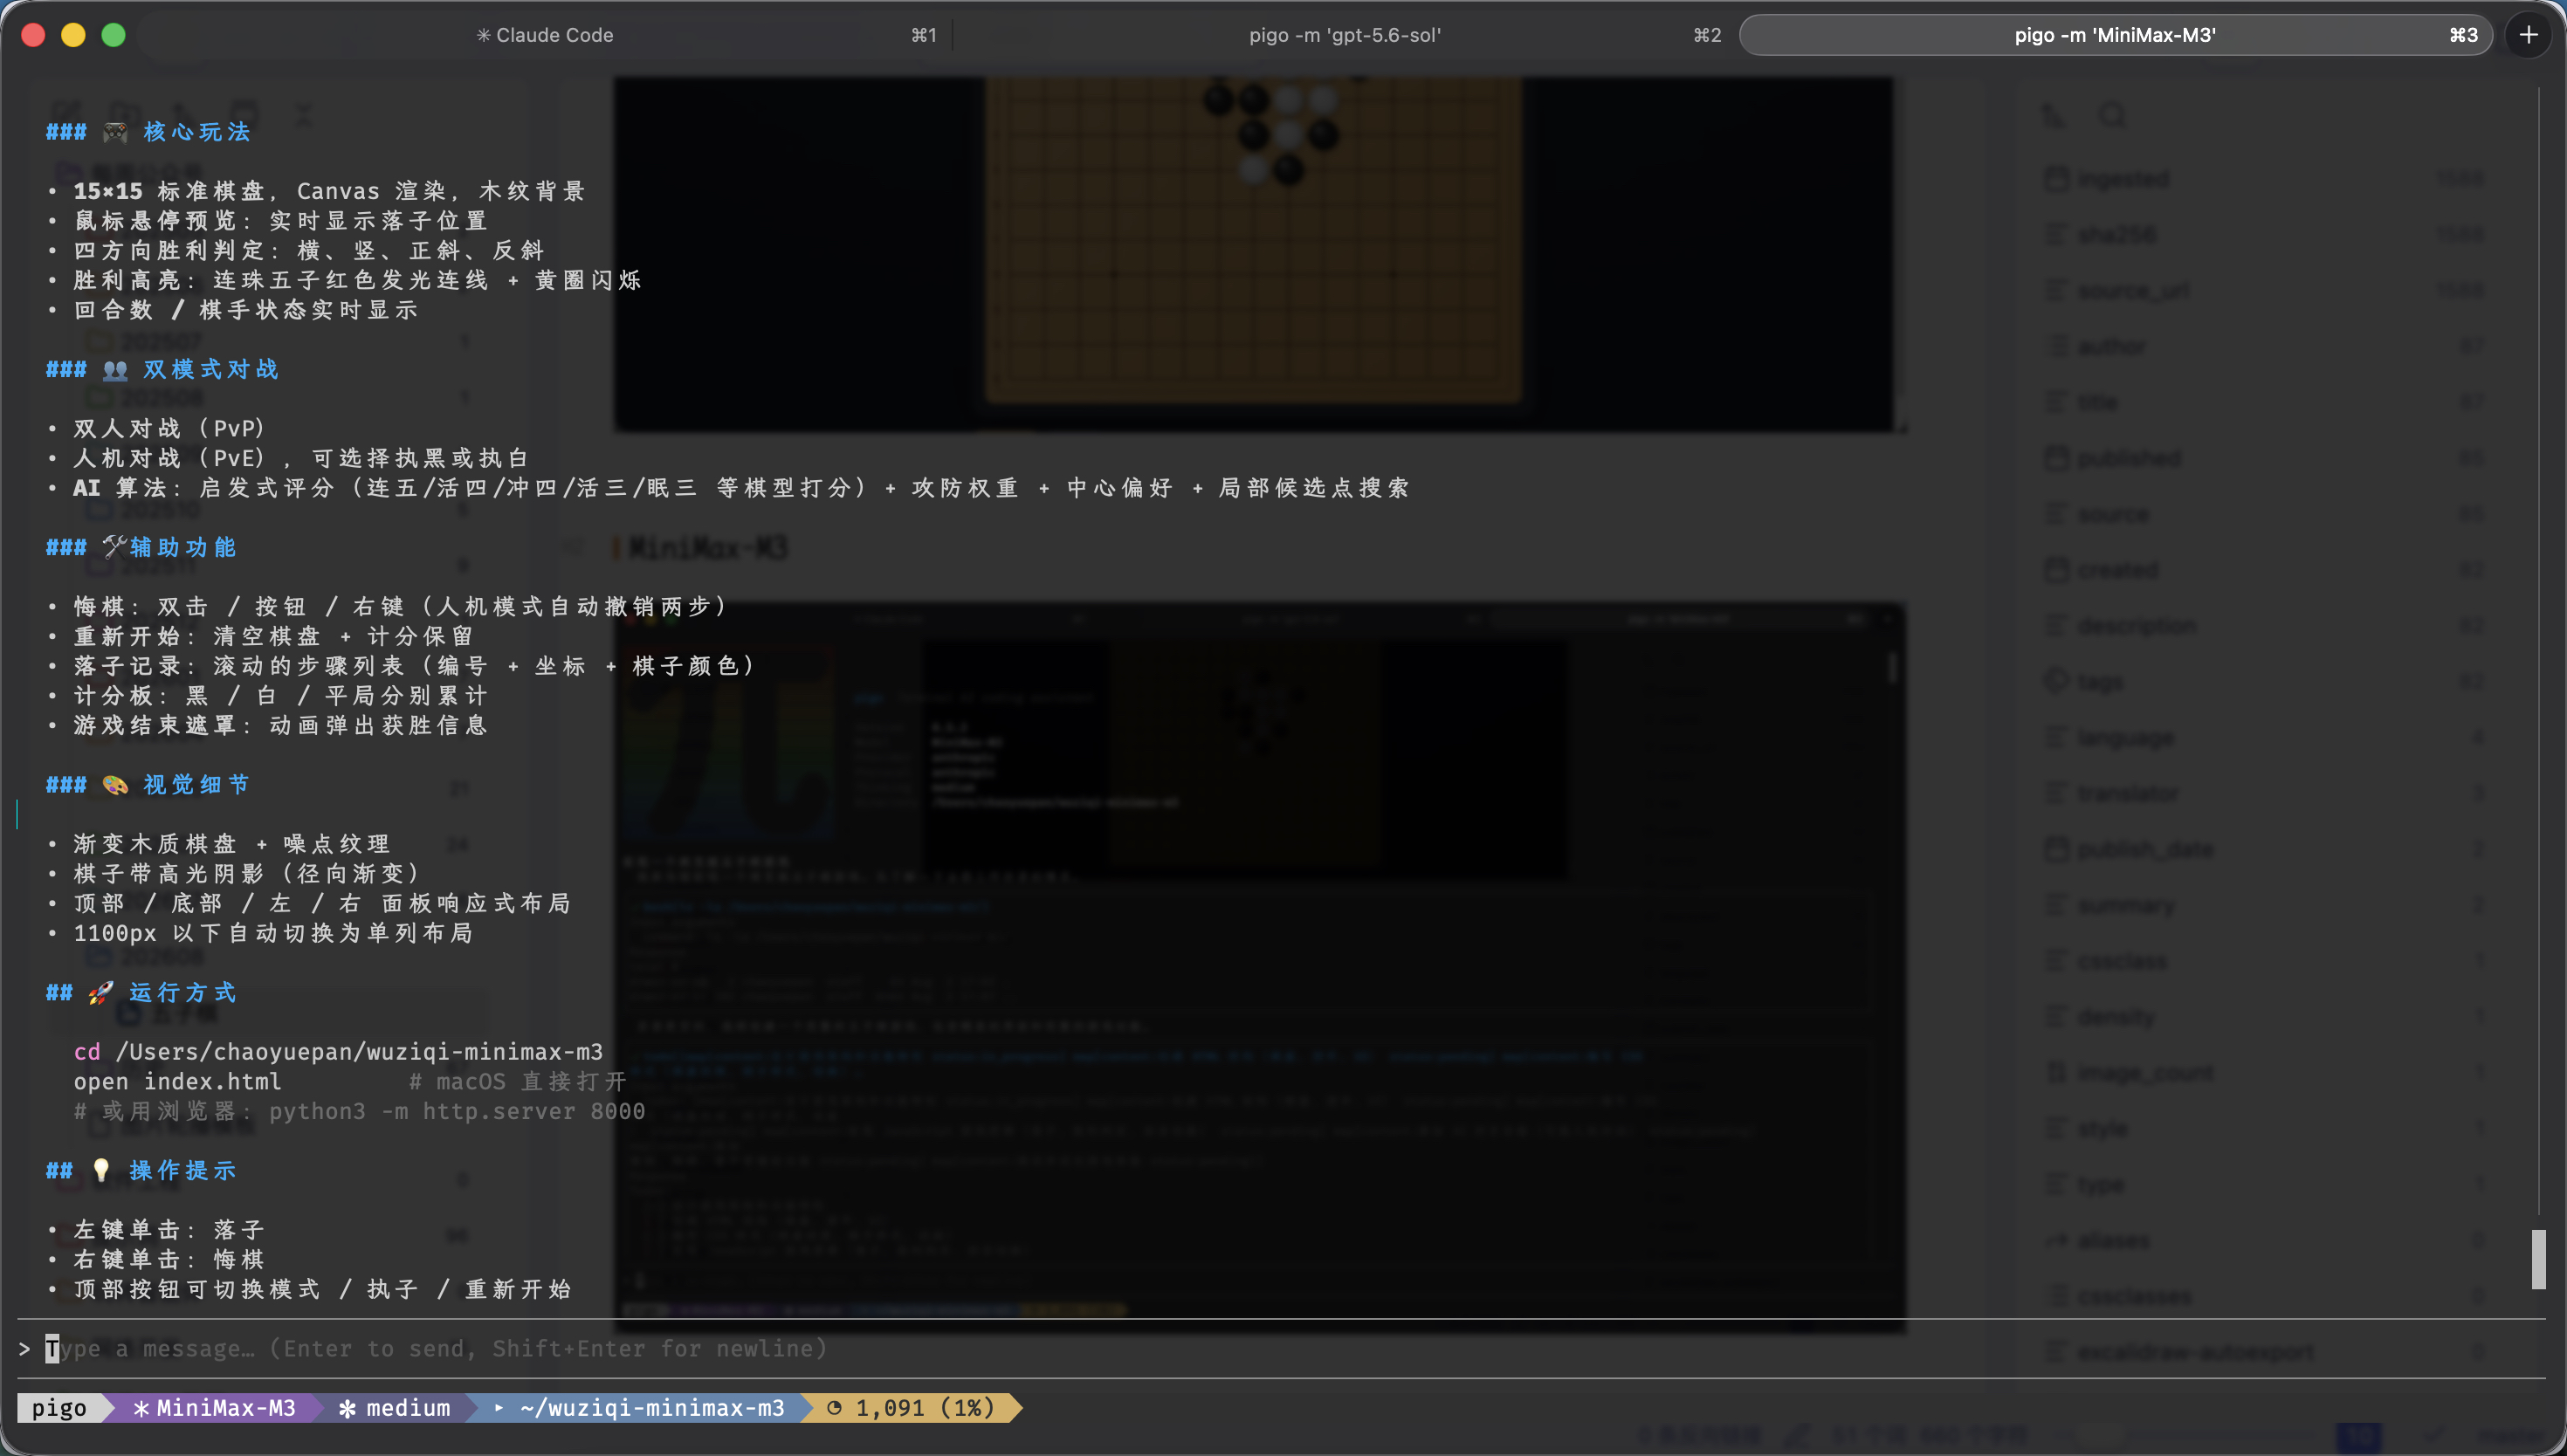
MiniMax-M3 是界面最精致的一个:咖啡棕暗色主题,三栏布局——左栏游戏模式(双人/人机)和执子选择,中间是棋盘和回合数,右栏计分板加带编号的落子记录。棋盘是渐变木质 + 噪点纹理,棋子有高光阴影,胜利时还设计了红色发光连线 + 黄圈闪烁的动画。代码里 AI 的启发式评分也写得最细,把连五、活四、冲四、活三、眠三配上攻防权重和中心偏好都算了进去。
但人机对战是坏的。我用 Chrome 打开它的页面、切到「人机对战」、落下黑棋 H8 后,白棋就一直卡在「白棋(AI)思考中…」,连续观察数秒回合数始终停在 1,AI 从不落子、棋局彻底锁死,控制台也没有任何报错。也就是说,AI 的界面、评分逻辑、落子触发它都写出来了,静态看代码是接通的,运行时却没跑通。
小结:典型的「看起来最强、实际最不能用」——功能列表和视觉都排第一,却没验证核心的人机对战能不能跑。只有双人对战模式是真正可用的。