上一篇文章的结尾,我留了一个话题。
我引用了那句话:"你可以外包你的思考,但是你不能外包你的理解。"
有读者在后台问我:道理都懂,可 AI 一天给我生成的代码,比我自己一年写的都多。思考我可以外包给 AI,理解我肯定要自己消化——但是消化也得有时间和精力啊。生成是光速,理解是步行,AI拉的是一大坨,理解缺是要细嚼慢咽,这道题怎么解?
一、先说困境:生成和理解之间的速率差
我们已经有了一个共识了,对吧:AI Coding Agent 已经把"写代码"这个环节的产能拉爆了。
我们现在的日常是这样的:早上给 agent 派一个 Issue,去泡杯咖啡回来,一个几百行的功能已经躺在工作区里了,测试都跑绿了。我们在AI的帮助下梳理好一个需求文档,要是用 /loop-it 或者 /graph 批量跑几个 Issue,一个下午的工作区里能堆出过去一周的变更量。
生成的一大坨代码,诚实的讲,很多情况下我们跑过测试和Code Review就提交了,我们已经不读代码了。
但代码不会因为你没读它,就自动变成"你的"代码。
背后有个很少有人挑明的速率差:
- 生成是并发的。你可以开十个 agent 同时干活,产能理论上无限。
- 理解是串行的。理解只能发生在你一个人的脑子里,一行一行过,一夜一夜熬。
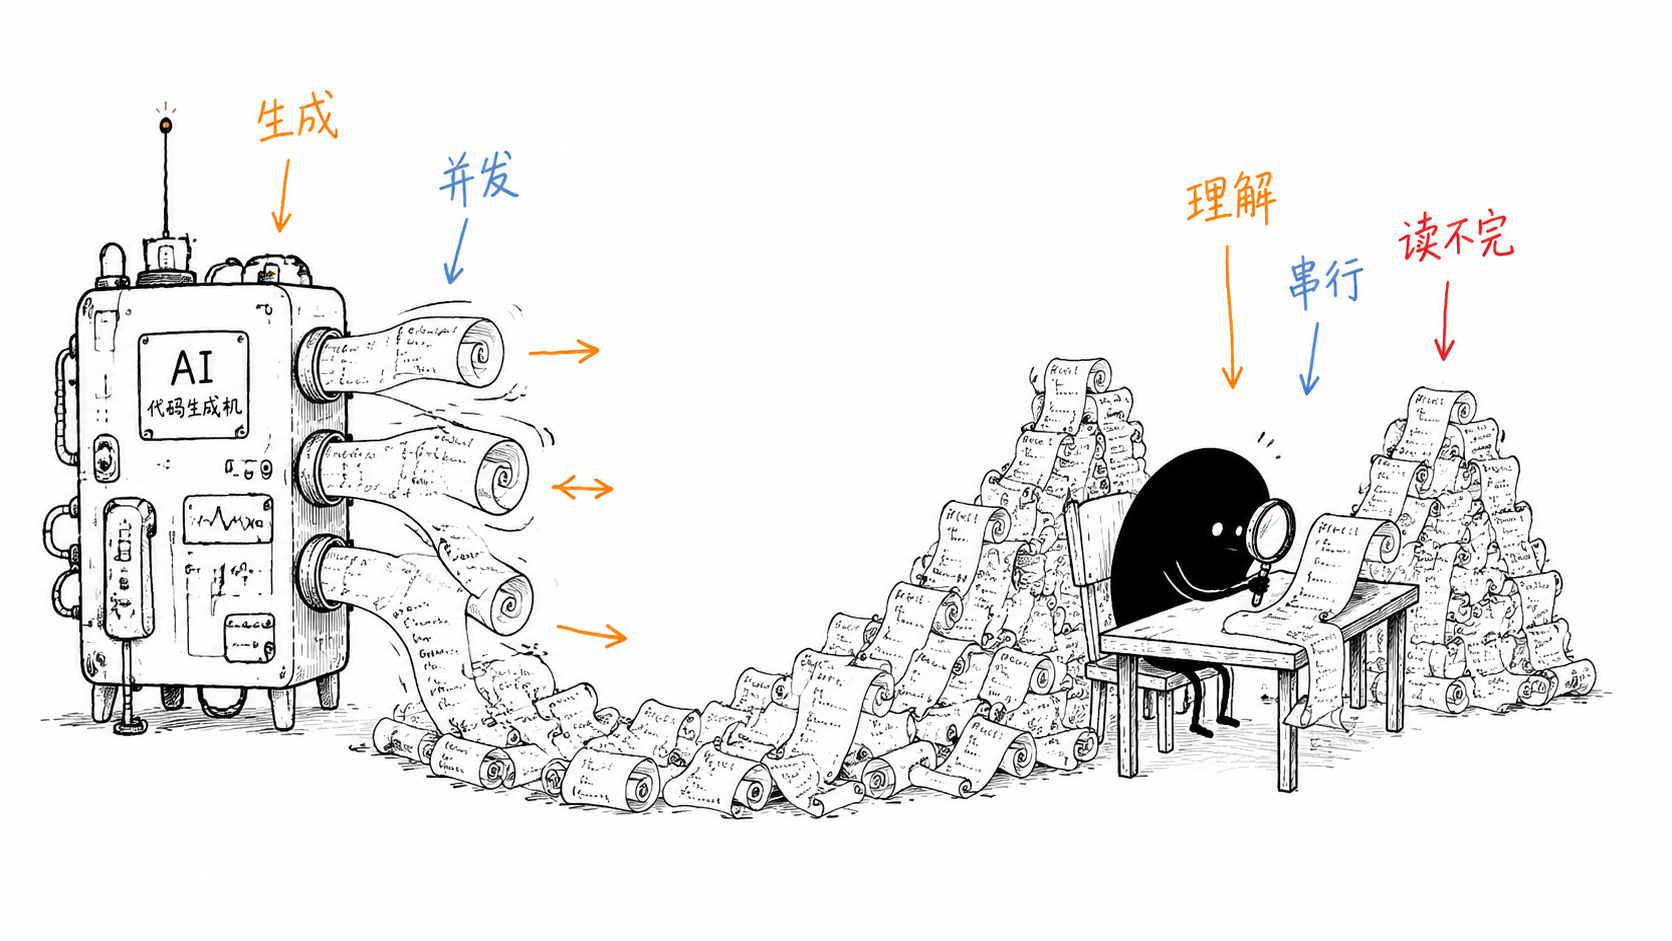
以前人写代码,生成速度约等于理解速度——你写一行就懂一行,代码库长在你脑子里。现在倒过来了:代码库膨胀的速度是脑子的十倍、百倍。用不了多久,这个项目对你来说就变成了"考古现场":每一行代码都认识你,你不认识它们。
不理解的代码,具体坑你三件事:
- 不敢动。 改之前你不知道哪里有雷,只能小心翼翼绕着走。绕来绕去,代码库就被"谁都不敢碰的祖传区域"占满了。
- 答不上。 这是我最切肤的痛。团队协作里,同学指着一段代码问你"这块为什么这么写",你不能说"等我问问 AI"。那一刻你不是工程师,是传话筒。项目里有你名的部分,你得能立刻接住。还有QA同学测试时,测试出问题,需要你快速的解答。
- 背不动。 线上出了事故,root cause 藏在三个月前 AI 生成的一段代码里。锅是你的,因为你 review 过、提交过。可你连它为什么存在都不知道,怎么背?
那怎么办?我也试过几招,逐一汇报失败原因:
- 不读,靠测试兜底。 这是 Uncle Bob 的路子:不读代码,用单元测试、变异测试、覆盖率把约束焊死。这套对"保证质量"有效,但注意——它保证的是代码没有错,不是你懂了这段代码。测试通过只能告诉你程序行为符合预期,不能把意图装进你脑子里。
- 粗读。 diff 打开,扫一眼,"嗯,看着没啥问题"。这是骗自己。三分钟后你不记得看过什么,五分钟后这段代码在精神上已经易主了。
- 让 AI 再总结一遍。 这是我一开始最寄予希望的:既然读不过来,让 AI 读,给我写个总结。问题是——读总结和理解代码,根本不是一件事。我增加
/note-itskill尝试做这个。总结是二手转述,会失真;更麻烦的是,总结飘在代码之外,你看到"本模块实现了限流逻辑"这句话,但限流逻辑具体落在哪几行、为什么是滑动窗口不是令牌桶、边界条件怎么处理的,总结里全没有。你等于把"不读代码"换成了"读另一篇更短的代码",理解并没有发生。
绕了一圈你会发现,理解这个东西没法并行,没法压缩,也没法托付给别人。它只能发生在你脑子里。
这周末我也看到了两篇文档:
- 如何验收 AI 拉出来的屎山?
- 如何保证产品的AI代码可以持续迭代、好维护、不腐化。
当然不止于此了,很多人也在思考这个问题。
所以这个困境说穿了就是:AI 能替你写代码,但不能替你长出理解。生成速度可以外包,理解速度不行。
没别的办法,理解的产能提不上去,那就把理解的成本降下来。让 AI 干完活之后,顺手把"备课"也做了,把变更的来龙去脉整理好,摆在你面前,你只需要沿着台阶爬。
这就是我做 /understand 这个 skill 的初衷。
二、我的尝试:/understand,让 AI 指着代码给你讲解
/understand 是我的 goal-workflow 工作流里的一个技能,它干的事很简单:把你刚生成的改动(通常是 AI 写的)变成一个可以交互的审阅网页,帮你在采纳之前吃透这次改动。
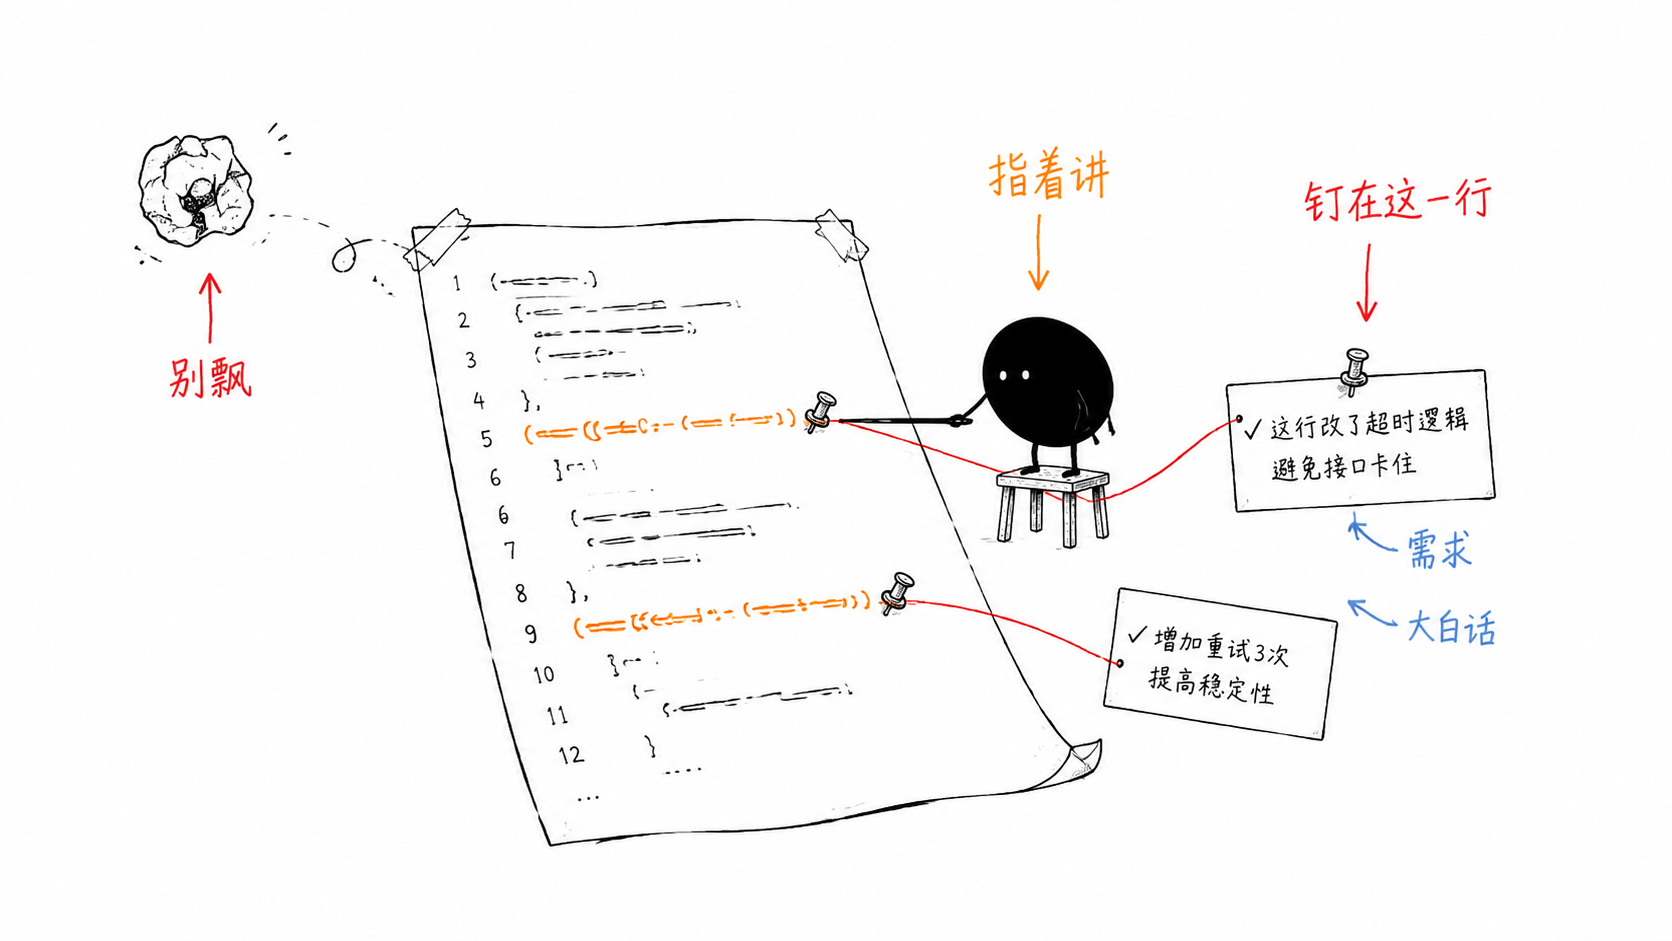
我换了个思路:别让 AI 替你读代码,让它指着代码给你讲解。
区别在哪?前者给你一篇总结,飘在半空;后者的每一条解释都钉在具体的代码行上,指着这一段讲这一段。你拿到的不是转述,是带定位的导读,读到哪一段,屏幕上就是哪一段。
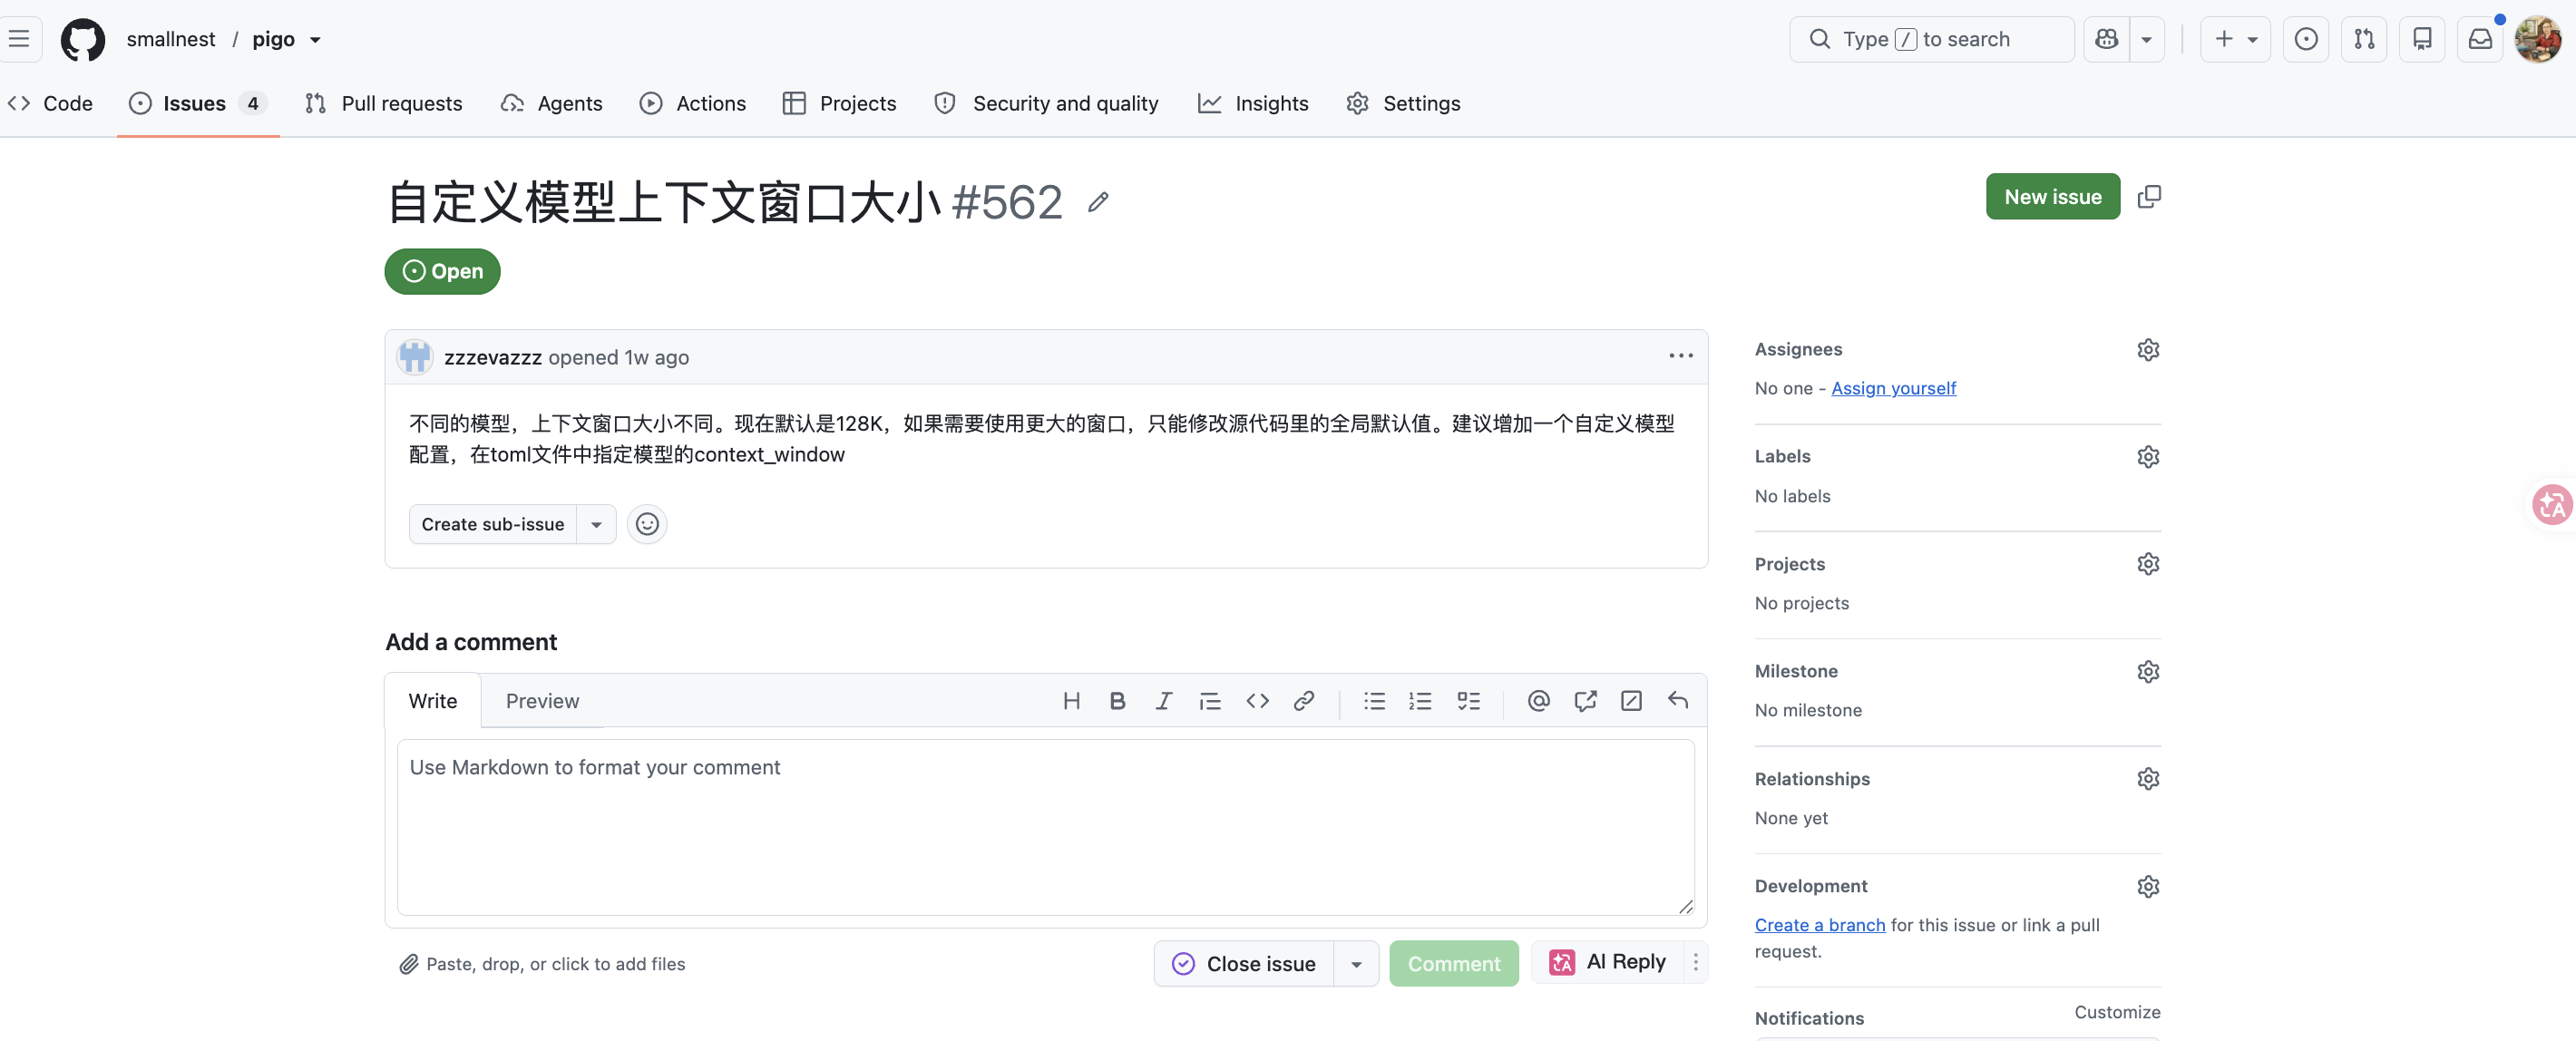
以实现这个pigo的issue为例:
工作流程三步:
第一步,扫描变更。
1 | python3 understand.py scan |
以当前分支和主分支的 merge-base 为基线,把这次变更一网打尽:已提交的、已暂存的、未暂存的、连没跟踪的新文件都不放过。解析成结构化的 diff 数据。
事实上你也可以指定多个变更,某一时间段的变更,某个需求的变更等等,提示词由你写,你可以自由的圈定范围
第二步,Agent 通读改动,逐段写注释。
这一步是灵魂。Agent 把每处改动读一遍,然后给关键段落各写一张"卡片",每张卡片两个东西:
- 相关单位需求——这段代码是为了满足哪条需求而存在的。这个依据不能瞎编:优先从 commit message、需求文档、issue 里找真实出处;实在找不到,就明确标注为"推测意图"。
- 代码解释——大白话讲这段在干嘛、为什么这么写、有什么坑。比如"这里把 Instant 改绑成 OffsetDateTime,因为 PG 客户端不认 Instant,不改运行期必炸"这种,才是真正有用的注释。
第三步,渲染成一个网页。
1 | python3 understand.py render |
产出是一个单文件 HTML,长这个样子:
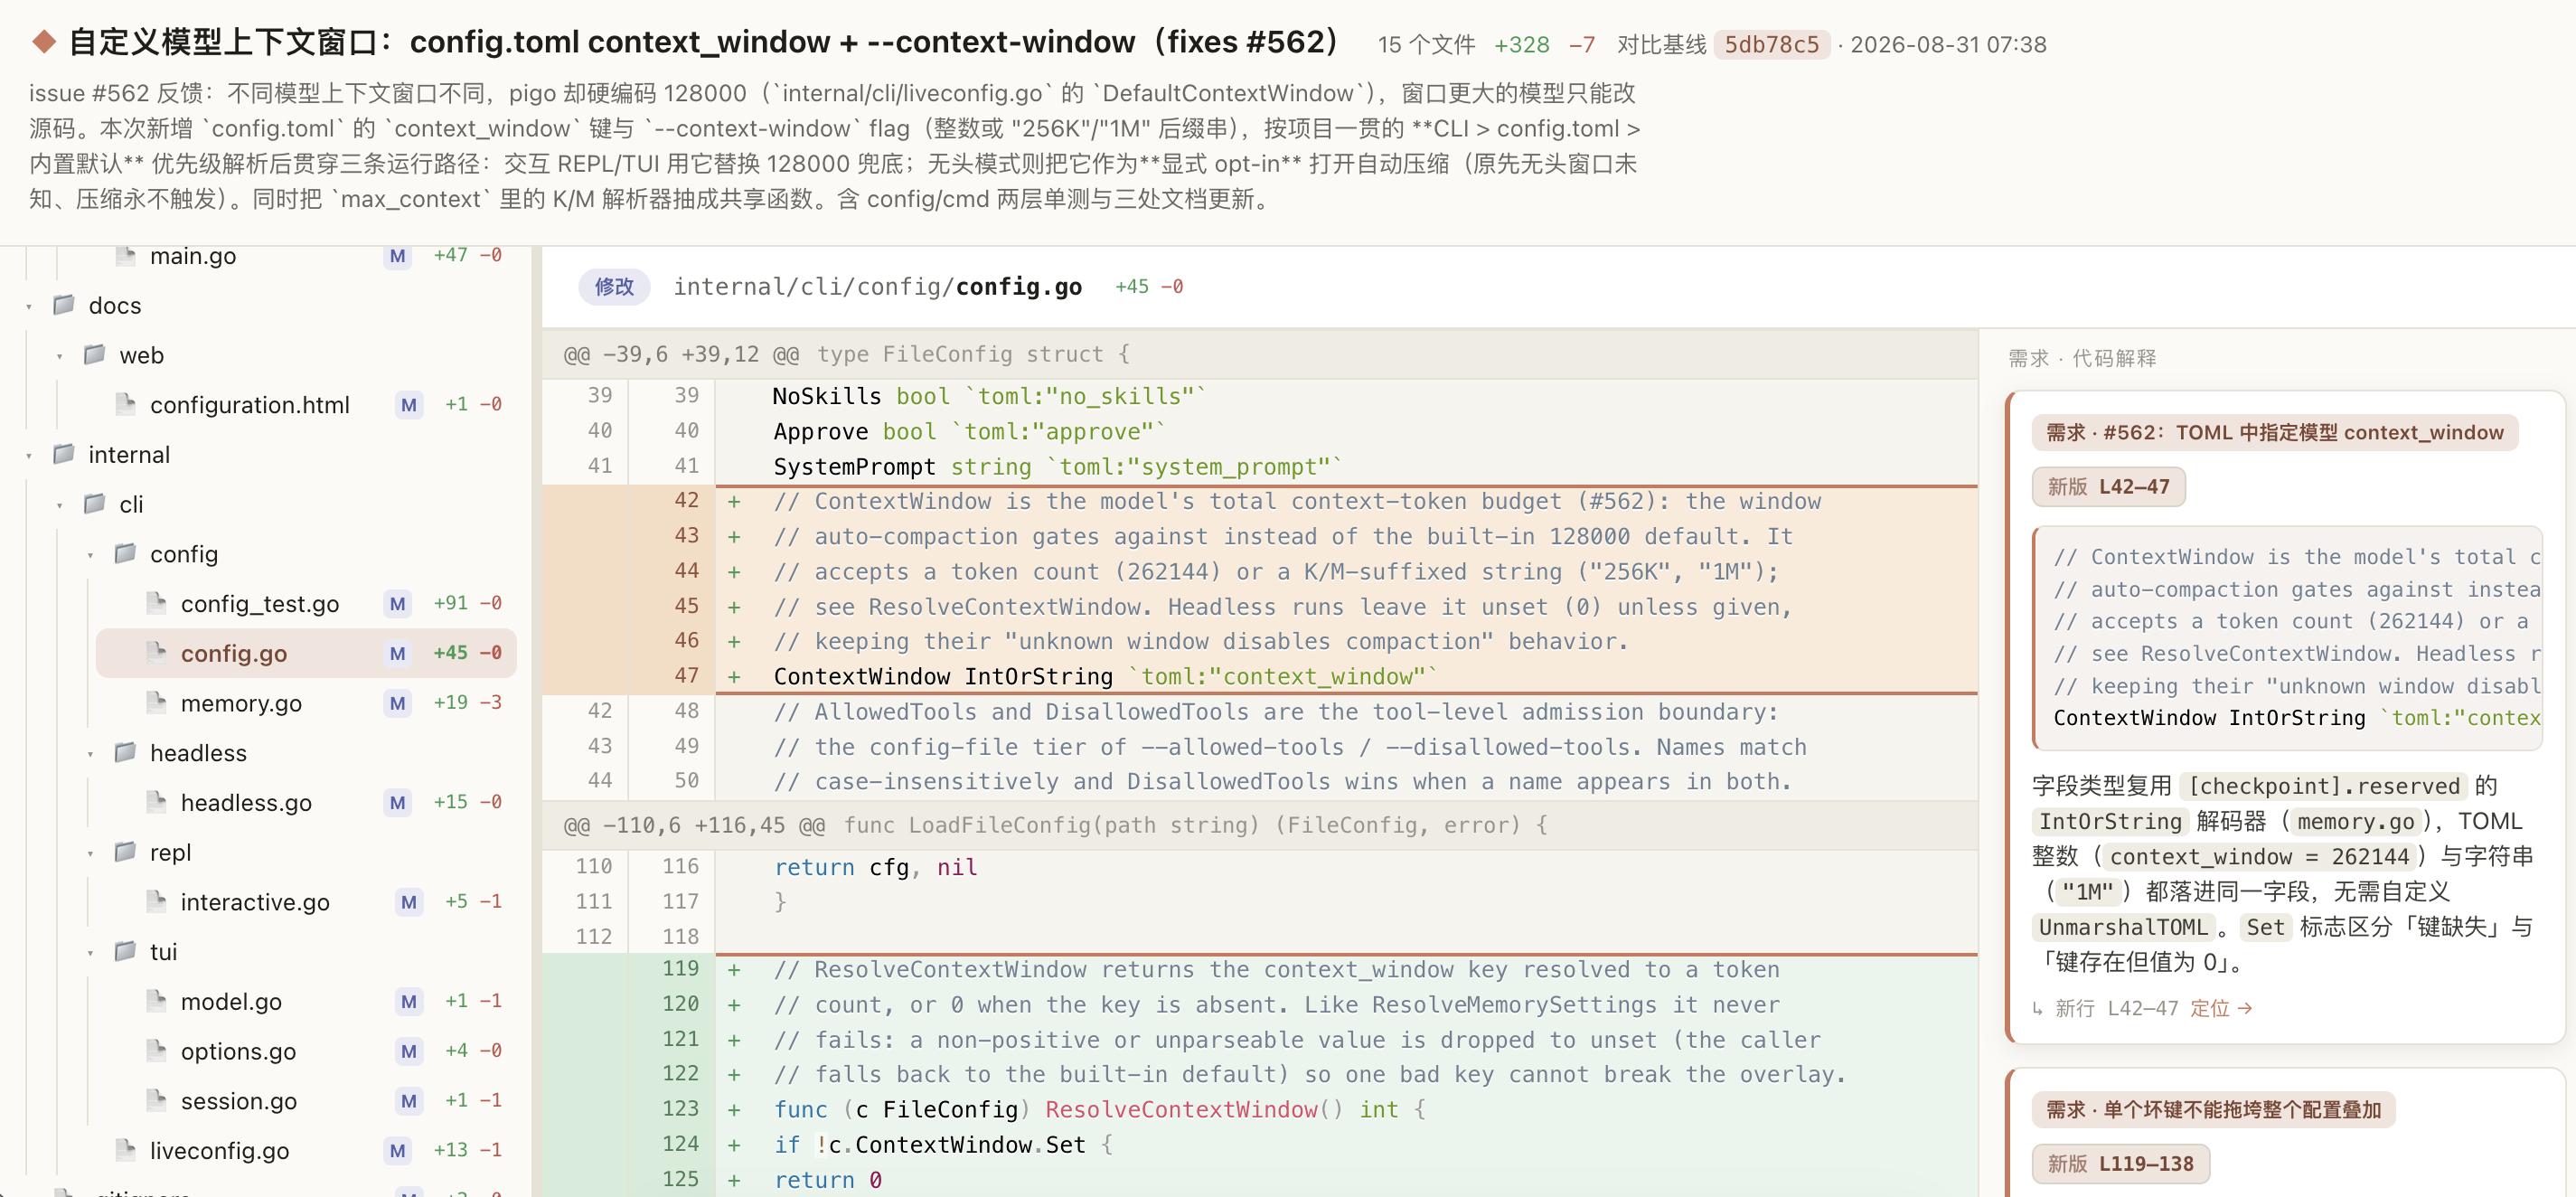
- 左边是变更文件的目录树,按真实项目结构排列,每个文件标着 A/M/D/R 状态和增删行数;
- 右边是所选文件的语法高亮 diff,增、删、未变更代码一眼可分,行号是文件真实行号;
- 右侧边栏就是第二步生成的卡片流:一张需求卡片 + 一段大白话解释,点击卡片,右侧 diff 会跳到对应代码行,高亮闪一下。
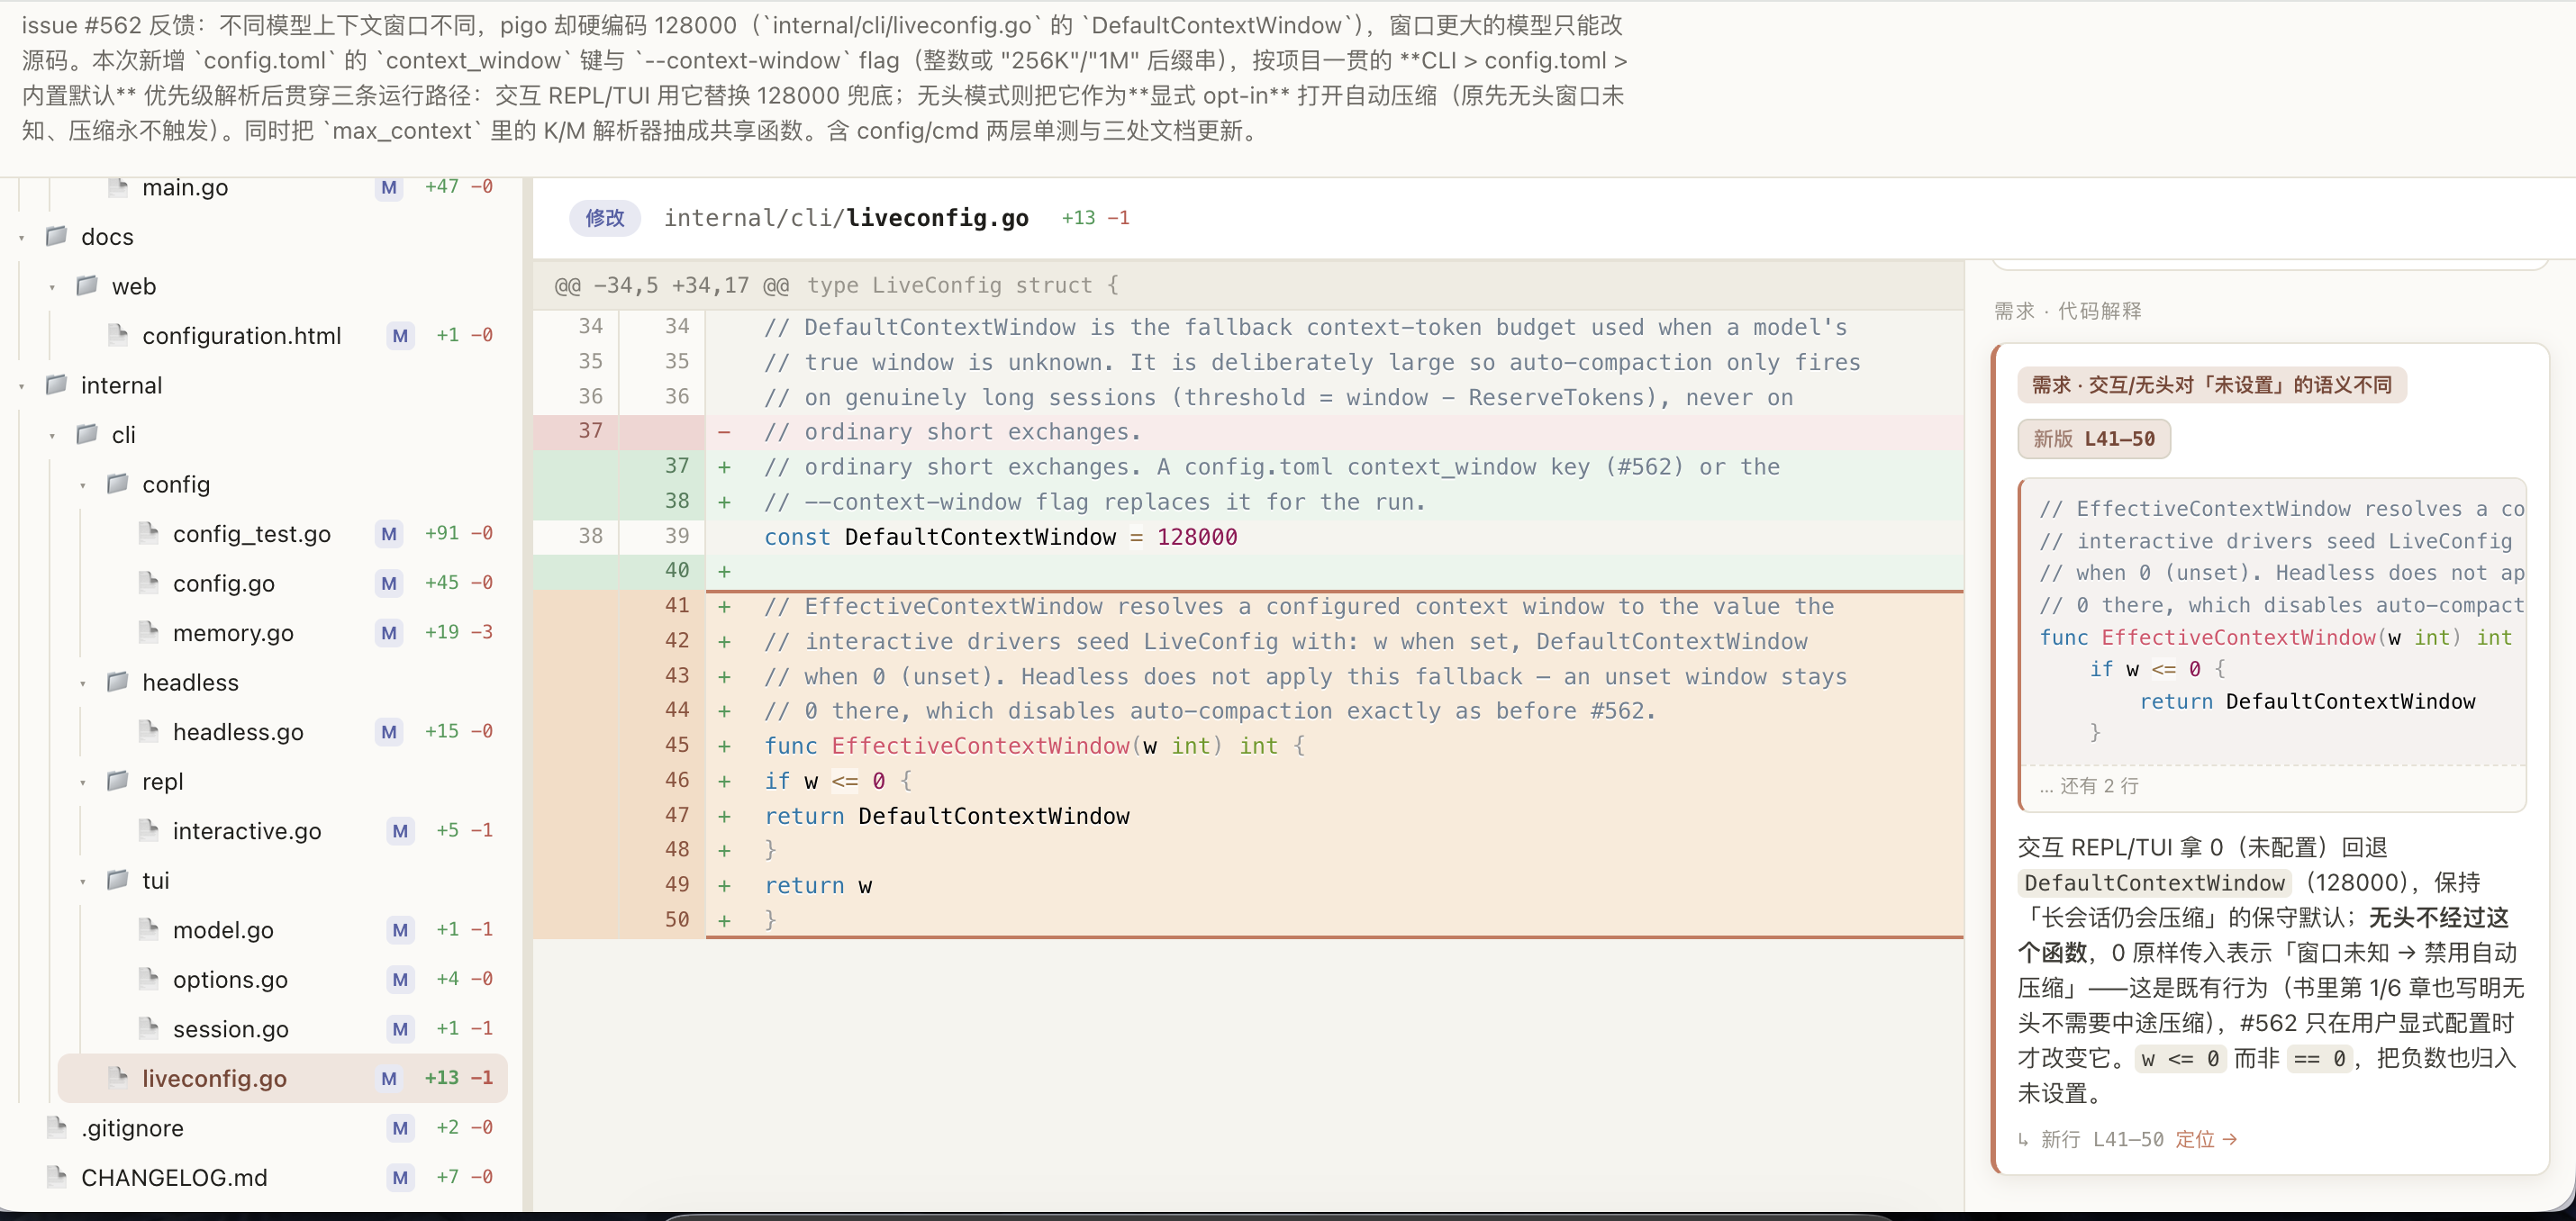
使用体验有点像:一个刚写完代码的同事,把 diff 推给你,然后陪你逐段过一遍,指认每一处改动背后的需求和理由——只不过这个"同事"三秒钟就能到位,而且随叫随到。
三、几个我特意坚持的设计细节
做这个 skill 的时候,有几个决策我纠结过,最后都坚持了,说说为什么。
一是"推测意图"必须显式标灰,不许伪装成事实。
AI 最讨嫌的地方是它永远语气笃定。如果让它写"这段对应需求 X",它会毫不犹豫地编一个听起来很合理的需求 X 出来。但一个需要是编的,这个注释就从导读变成了误导——你以为你在学代码的真实意图,其实在学 AI 的脑补。
所以 annotations 里专门有一个 inferred 字段:找到真实出处的需求,正常展示;纯属推测的,前端渲染成灰色的"推测意图"标签。诚实比好看重要。
二是解释必须锚定真实行号,点击必须能跳。
前面说了,这个 skill 和"让 AI 写篇总结"的本质区别就是锚定。所以注释的坐标用的是文件真实行号(不是 diff 里的序号),点击卡片必须跳转、必须闪动高亮。解释不许离开代码独立存在——你想看解释,就得看着代码看。
三是注释密度刻意克制,只讲关键段落。
逐行注释听起来很认真,实际是灾难——满屏卡片等于没有卡片。我的规则是每个重要文件 1~5 条,只挑三类地方下笔:新增的核心逻辑、边界和易错点、最能体现需求的段落。专挑讲决策的地方下笔,其余的闭嘴。
四是单文件产物,离线可用。
report.html 是一个单文件,不依赖任何服务。这意味着它可以进 code review 的评论、可以扔进群聊、可以归档到 docs/ 里——三个月后考古这段代码时,当年的讲解还在。
四、它和 /review-it 是一对搭档
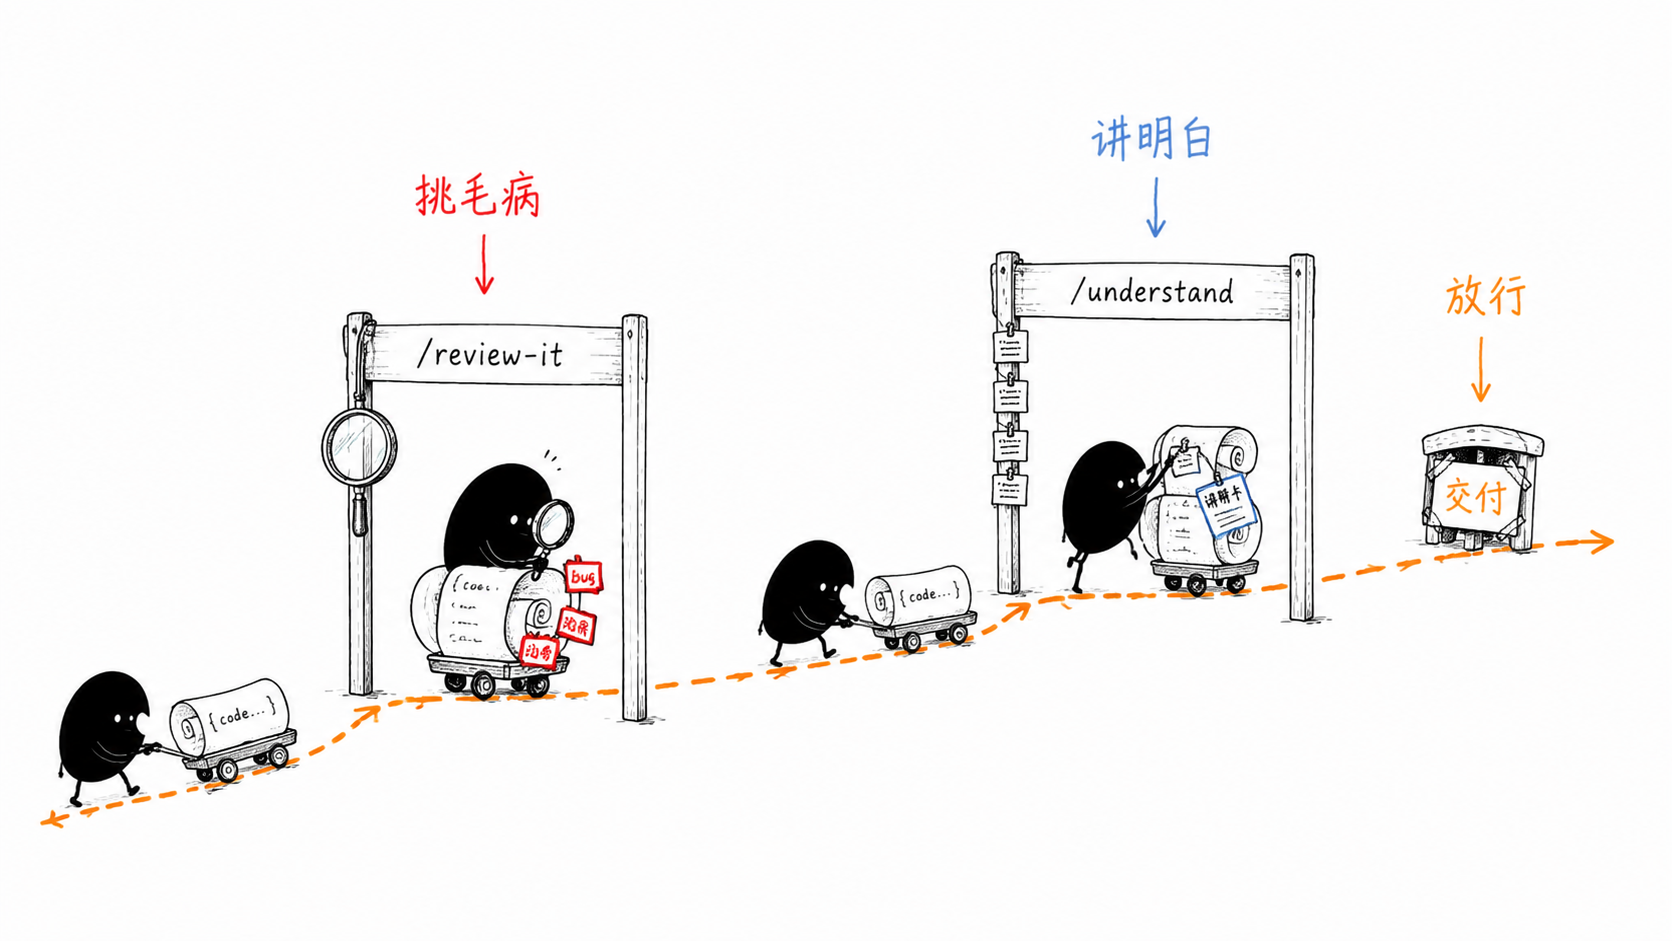
在 goal-workflow 里,/understand 的定位是 /review-it 的"理解型搭档",这两个是一套组合拳:
- /review-it 问的是"这段代码有没有问题"——它挑毛病、验证发现、迭代修复,对代码负责;
- /understand 回答的是"这段代码为什么存在"——它讲意图、讲需求、讲理由,对你负责。
一个管质量,一个管理解。合起来才是一个完整的 review。Review 这个词本义就是"重新看一遍",既看它对不对,也看它是什么。
一个可行的日常开发顺序是:AI 生成代码 → /review-it 把明显的问题筛掉修掉 → /understand 生成审阅网页 → 我花十几分钟逐段过卡片 → 确认吃透了 → /ship-it 交付。理解这道工序,被明确地放进了流水线,而不是靠"回头再看"这种永远不会发生的口头承诺。或者将 /understand 放在 /ship-it 之后。
/understand 是 goal-workflow 的一部分,开源在 github.com/smallnest/goal-workflow,安装:
1 | npx skills add smallnest/goal-workflow --skill understand |
在 Claude Code 里输入 /understand,或者直接说"解释一下这批新生成的代码",就能用了。工作流介绍页:https://goal.rpcx.io/index_cn.html
欢迎你反馈使用体验和优化建议。
