
本文深入分析 Matt Pocock 的 Skills 系统——目前社区中设计最精良、哲学最自洽的 AI Agent 能力单元框架之一。它不追求最大最全,但它对「什么是一个好的 Skill」这个问题的思考深度,远超同类项目。从 Prompt-Driven 到 Skill-Driven——Prompt 消失在对话历史里,Skill 留在工具链里。
本文深入分析 Matt Pocock 的 Skills 系统——目前社区中设计最精良、哲学最自洽的 AI Agent 能力单元框架之一。它不追求最大最全,但它对「什么是一个好的 Skill」这个问题的思考深度,远超同类项目。从 Prompt-Driven 到 Skill-Driven——Prompt 消失在对话历史里,Skill 留在工具链里。
"Same person. Different era. The difference is the tooling."
人未变,时代已改。拉开差距的,全在工具。——Garry Tan, Y Combinator 总裁 & CEO, 2026 年
卷首语用五个人的故事画出了一幅图景:Karpathy 半年没写代码,Amodei 预言 90% 代码将由 AI 完成,Garry Tan 的产出翻了 810 倍,Boris Cherny 不再写代码只审查代码,antirez 放下了亲手雕琢每一行的执念。这些信号指向同一个结论——软件工程正在经历自 1968 年这门学科诞生以来最深刻的一次范式转换。
本章建立理解这场变革所需的概念坐标。它是怎么一步步走到今天的?新旧范式之间真正的断裂在哪里?全书贯穿的那根主线——"用结构化知识驾驭非结构化 AI 能力"——是怎么来的?
"I don't think I've typed like a line of code probably since December, basically, which is an extremely large change."
从去年十二月起,我基本上一行代码都没写过,这是一个巨大的变化。——Andrej Karpathy,No Priors 播客,2026 年 3 月

Machine Learning Transformers LLM Neural Networks AI
本文带你走一遍 LLM 的工作原理。现代 LLM 大多是由 transformer 块反复堆叠而成的,因此理解了 transformer 机制,你就掌握了大部分。
我将覆盖现代基于 transformer 的 LLM 内部的核心机制,避开那些复杂的数学。别误会,你应该学数学,但本文可以作为一个入门。
大多数现代 LLM 共享同一套 transformer 家族的骨架。差异来自于各自的训练数据、规模和配置选择,以及在此之上的后训练。读完本文后,你应该能够阅读许多现代 LLM 论文或模型卡,并知道每个部分在讲架构中的哪个组件。
路线如下:
2026年5月28日 · Mike Piccolo, iii 创始人兼 CEO
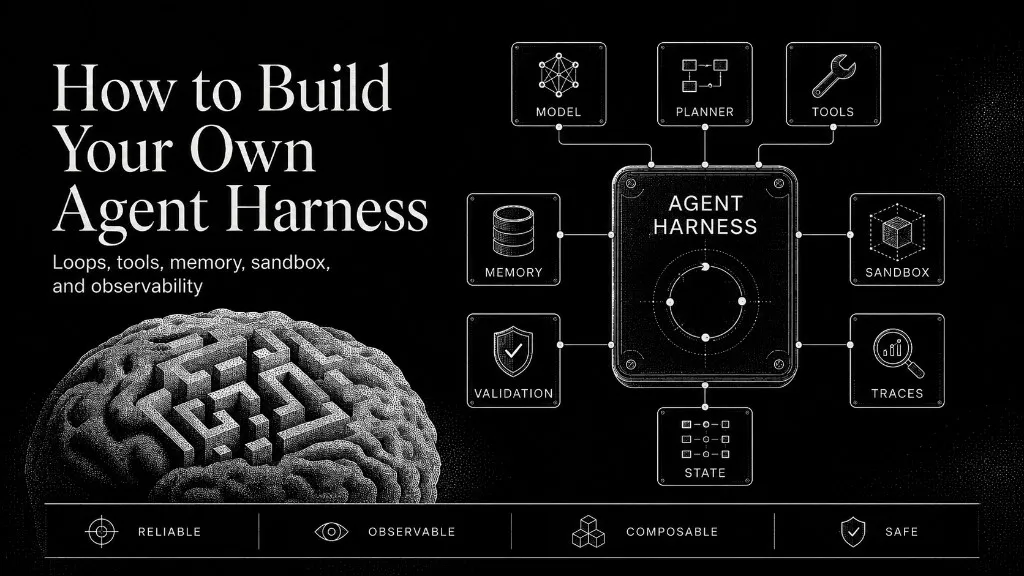
大多数 agent 团队不构建运行时。他们采用一个。LangChain、LangGraph、OpenAI Agents SDK、Anthropic SDK、CrewAI、AutoGen——循环、工具、记忆、编排,都是作为一个单一决策从货架上挑选的。运行时是一个你 import 的框架。如果里面的什么东西不合适,你就 fork 它、跟它斗争、或者绕过它。
你有没有过这样的经历:接手一个"跑了三年没人敢动"的项目,打开代码仓库一看——
src/ 下面 200 多个文件平铺在一个目录里,没有分层,没有模块边界。一个叫 UserService 的类 1800 行,发邮件、对接支付、状态管理全塞在里面,还挂着三个 TODO 标着"后面要重构"。业务逻辑全堆在 Service 层,Model 类只剩 getter 和 setter,贫血得像张纸。数据库查询藏在 for 循环里,每循环一次发一条 SQL。你问老员工这模块谁负责,得到一句:"这个……已经没人记得了。"
Martin Fowler 把这类问题叫做"代码坏味道"(Code Smell)。Brian Foote 和 Joseph Yoder 在 1997 年的论文里给了一个更直白的名字:Big Ball of Mud(大泥球)。
去年我还在折腾 langchain/langgraph 开发智能体,弄了个 langgraphgo 项目,把 langgraph 往 Go 生态圈里搬。那会儿网上做智能体的,十个有八个用 langchain/Crew AI。
一个阶段有一个阶段的玩法。
现在我看到了另一种路子:大家直接用 Claude Code、Codex、OpenCode、Pi 这些 coding agent "套壳"来实现智能体。
先说两个很多人搞混的点。
别觉得这些工具只能写代码。Claude Code、Codex 的架构走的是通用智能体模式,早就不止 coding 了。
也别把"套壳"当贬义词。Manus 刚火那阵,就有同事撇嘴说"这不就是 Claude 的套壳"。但你看,Claude、Codex、Antigravity 一个个都在推 SDK,巴不得你基于它们二次开发。牛顿怎么说的,站在巨人肩膀上不丢人。
你是否曾经有过这样的经历:
写了一篇 PRD,结果开发实现的时候完全跑偏
实现完代码后,发现还有一堆体力活要做:代码审查、写 commit、创建 PR、等待 CI 检查...
团队成员对同一个需求理解不一致,导致返工
多次开会同步需求进度,但最终代码还是和预期不一样
Issue 拆得太细或太粗,开发时常卡住不知道下一步该做什么
每次提交都要重新敲一遍规范的 commit message,累死了


CLIProxyAPI 是一个轻量级 AI API 代理服务器,核心功能是在 OpenAI Responses API 和 Chat Completions API 之间做双向格式转换。它使得仅支持 Responses API 的客户端(如 OpenAI Codex CLI)能够访问仅提供 Chat Completions API 的模型(DeepSeek、GLM、Kimi 等)。

1 | Codex CLI |
instructions → system message,input → messages)
Peter Steinberger(GitHub 上的 steipete)是一个在 AI 开发工具领域绕不开的名字。他曾白手起家将 PSPDFKit 做到百万美元 ARR 并成功退出,如今在 OpenAI 负责 Agent 相关研发。他创建的 OpenClaw 项目收获了 37 万+ stars,而 Clawpatch 和 codex-review skill 是他 AI 编程工具链中专注于代码审查这一环的两个代表作。
传统代码审查有个结构性矛盾:审查者往往不熟悉被审查代码的完整上下文,所以要么流于表面(看看命名、格式),要么只能依赖作者写的 PR 描述来理解意图。AI 时代的解法很直接——让一个能读懂整个代码库的 Agent 来做审查。但不是随便把代码丢给 LLM 让它"看看有没有问题"就行,真正的挑战在于:如何划定审查边界、如何确保证据可追溯、以及发现问题后如何安全地修复。
Clawpatch 和 codex-review skill 分别从"工具链自动化"和"工作流规范化"两个角度回答了这些问题。
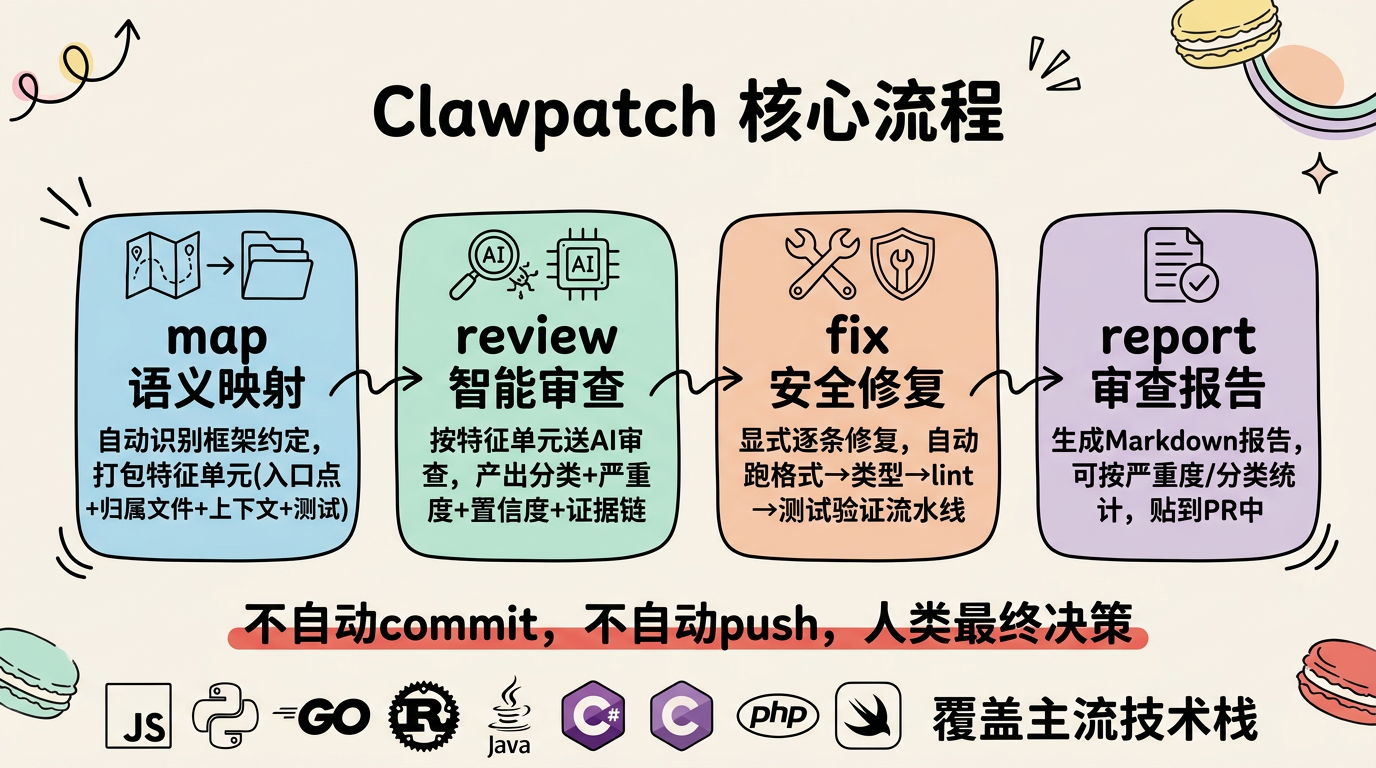
Clawpatch(clawpatch.ai,GitHub:openclaw/clawpatch)是一个命令行代码审查工具,MIT 协议开源。它的核心思路是把代码审查从"逐文件扫描"升级为"按语义单元审查"。
