目前顶尖的云服务商都包含百万台服务器、数十甚至上百个机房、上万台网络设备、百万级网络链路。单单一个GPU集群,就有上万卡的级别。对这些网络和服务器的监控,一个分钟级别的故障,可能就是上百万资产的损失。
这不是一个ping能解决的问题。
今天,我们将百度物理网络黑盒监控方向的工具集 nettools 开源了(https://github.com/baidu/nettools),第一批放出的是 bitflip 和 bitflip6,用于检测网络丢包和比特翻转,在百度内部跑了很长时间了。
目前顶尖的云服务商都包含百万台服务器、数十甚至上百个机房、上万台网络设备、百万级网络链路。单单一个GPU集群,就有上万卡的级别。对这些网络和服务器的监控,一个分钟级别的故障,可能就是上百万资产的损失。
这不是一个ping能解决的问题。
今天,我们将百度物理网络黑盒监控方向的工具集 nettools 开源了(https://github.com/baidu/nettools),第一批放出的是 bitflip 和 bitflip6,用于检测网络丢包和比特翻转,在百度内部跑了很长时间了。
上一个工具 bitflip/baize 解决的是丢包和改包持续检测,在百度baize常常用在点到点之间的常态检测中,比如机房内集群间的监控,专线的检测, 新网络方案测试和灰度观察、核心网络设备的切回前检测等场景。
今天介绍的lidar工具,区别于传统的pingmesh探测方案,是我来百度后创造的第一个特殊的底层网络方案,我将其称之为lidar(激光扫描)方案,是一个很形象的比喻,我会话专门一节详细介绍它的优缺点,在这之前,我们介绍传统的赫赫有名的机房大规模的网络监控方案 pingmesh。
PingMesh("Pingmesh: A Large-Scale System for Data Center Network Latency Measurement and Analysis")是微软在SIGCOMM 2015上发表的论文。作者团队来自微软研究院和Azure网络部门。
5000 包/秒高频探测 + 无需时钟同步的单向丢包检测 + 全路径覆盖。内部跑了多年,现在开源了。
先讲一个实际case。
线上服务突然超时,用户投诉电话打爆了。打开监控大盘,一切正常——没有任何告警。折腾两小时,最后发现是某条链路间歇性轻微丢包,丢包率 0.3‰,传统监控压根抓不到。
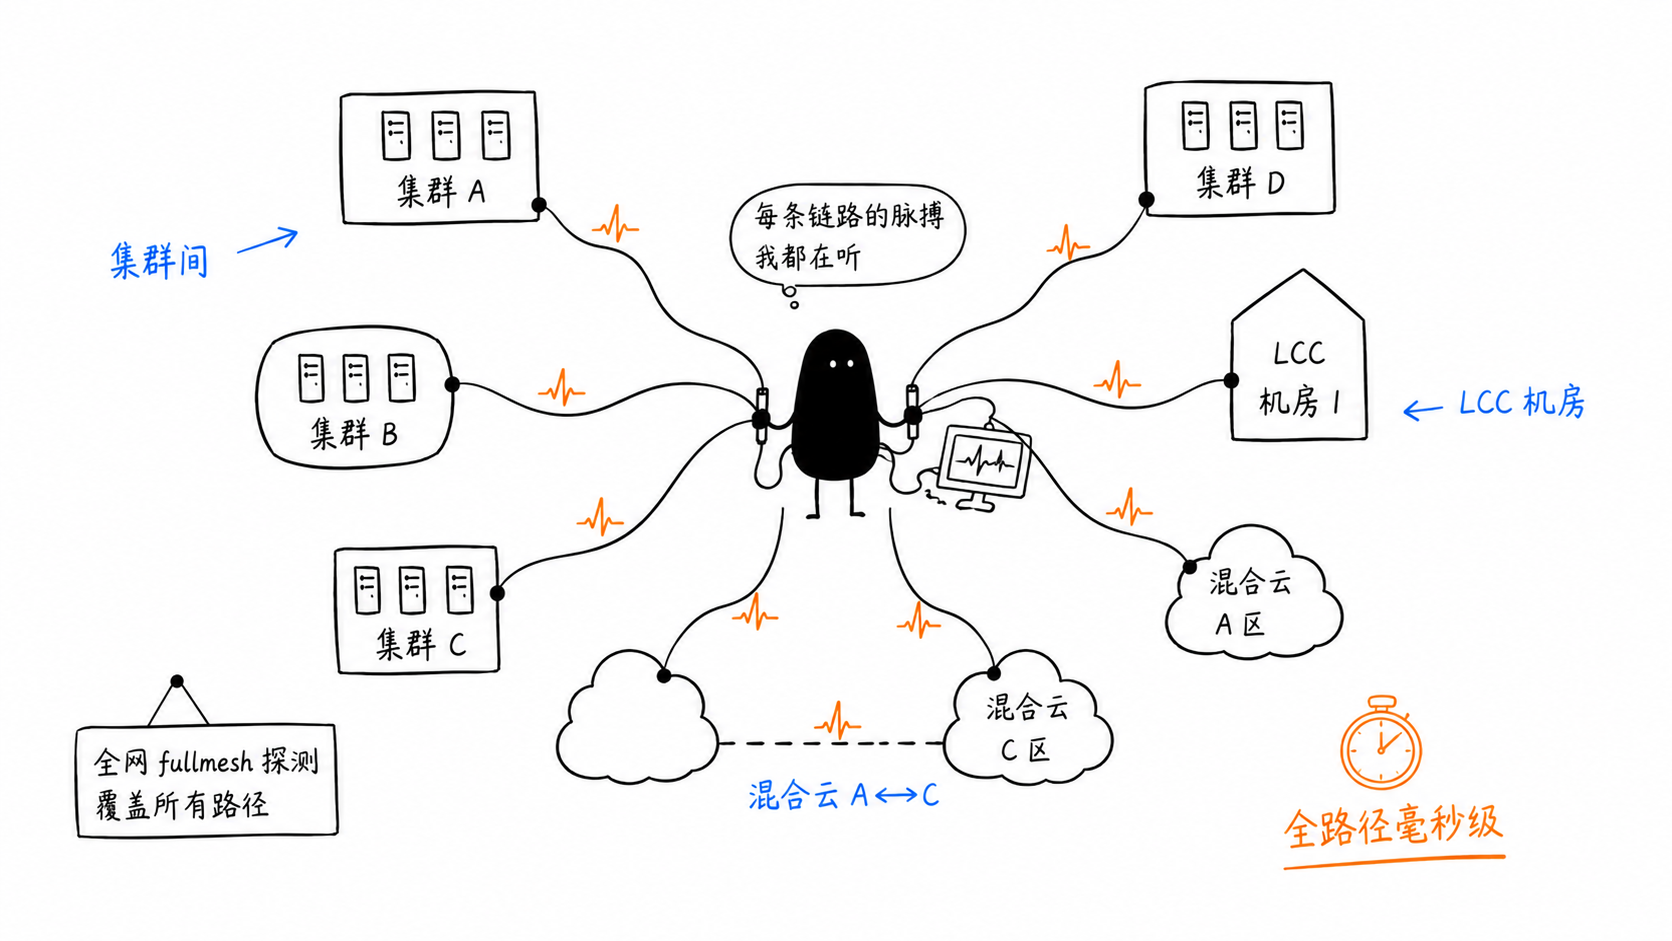
百度内部,baize 跑了多年:
baize 是百度 nettools 工具集的第二个开源工具,MIT 协议。
内部版还支持从数据库拉配置、推数据到 Kafka 聚合,开源版做了简化,但留了可插拔的 Sender 接口——你可以自己实现,把数据发到 ClickHouse、Prometheus 或者任意后端。
网络监控这件事,不是能不能做的问题,是做得够不够细的问题。
每一条链路、每一个端口、每一个比特,都值得被监控。 这是我们在百度内部坚持的标准,今天开源出来,希望对你有用。
被间歇性轻微丢包折磨过的话,去 GitHub 点个 Star,试试 baize。
Go 网络编程,大家第一反应就是 gopacket。但如果你用过 Scapy,你会发现 gopacket 的 API 繁琐得让人抓狂。goscapy 把 Scapy 的优雅搬到了 Go 里——流式构建、自动校验和、协议自动推断、一行代码搞定数据包,还能嗅探、发送、收响应。
最早接触到python生态圈的scapy是两年前,在和交换机的同学搞交换机探针的时候,他写了几行python代码就实现了一个发包探测程序,我立马就被scapy吸引了,居然写网络测试程序可以这么简单?
构造包只是故事的一半,解析包是另一半。
goscapy 的 Dissect 能从原始字节自动推断出完整的协议栈:
1 | raw := []byte{0xff, 0xff, 0xff, 0xff, 0xff, 0xff, 0xaa, 0xbb, ...} |
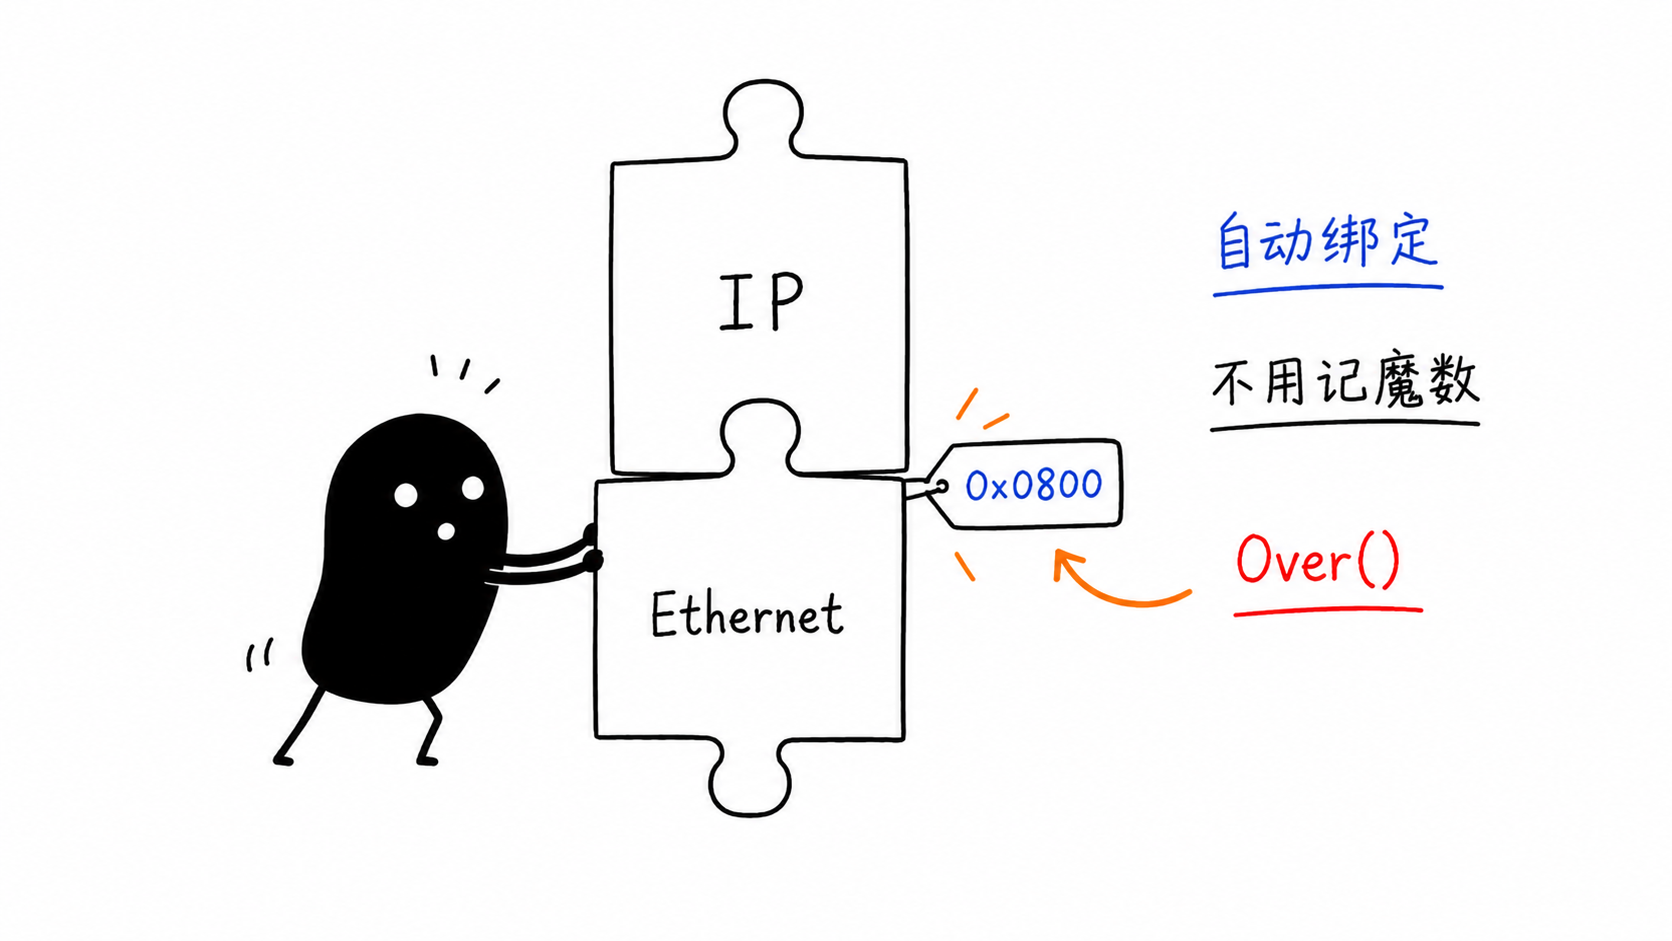
解析引擎靠注册表驱动。每一层解析完后,查 keyField 找到下一层——Ethernet 看看 type 字段(0x0800 → IP),IP 看看 proto 字段(6 → TCP),TCP 看看 dport(80 → HTTP)。VXLAN 这种隧道协议还能递归解析内层包,最多支持 8 层嵌套。
启发式规则也注册了一大堆:UDP 53 端口 → DNS,TCP 80 → HTTP,UDP 4789 → VXLAN,IP proto 47 → GRE……抓到的包基本都能自动识别到应用层。

写过 Scapy 的人一定对 sr() 和 sr1() 不陌生——发一个包,自动等响应,还能做协议级匹配。goscapy 把这套逻辑完整搬过来了。
1 | // 构造结构化的 Packet 对象(不是 Build 出 []byte) |
1 | // 类似 Scapy 的 sr1():发 ICMP Echo,等第一个响应 |
DefaultMatch 自动匹配响应包——ICMP Echo Request 配 Echo Reply(ID 匹配),TCP SYN 配 SYN-ACK(端口翻转 + ack = seq+1),UDP 配端口翻转,DNS 匹 transaction ID,ARP 配 IP 交换。不用写一行匹配逻辑。
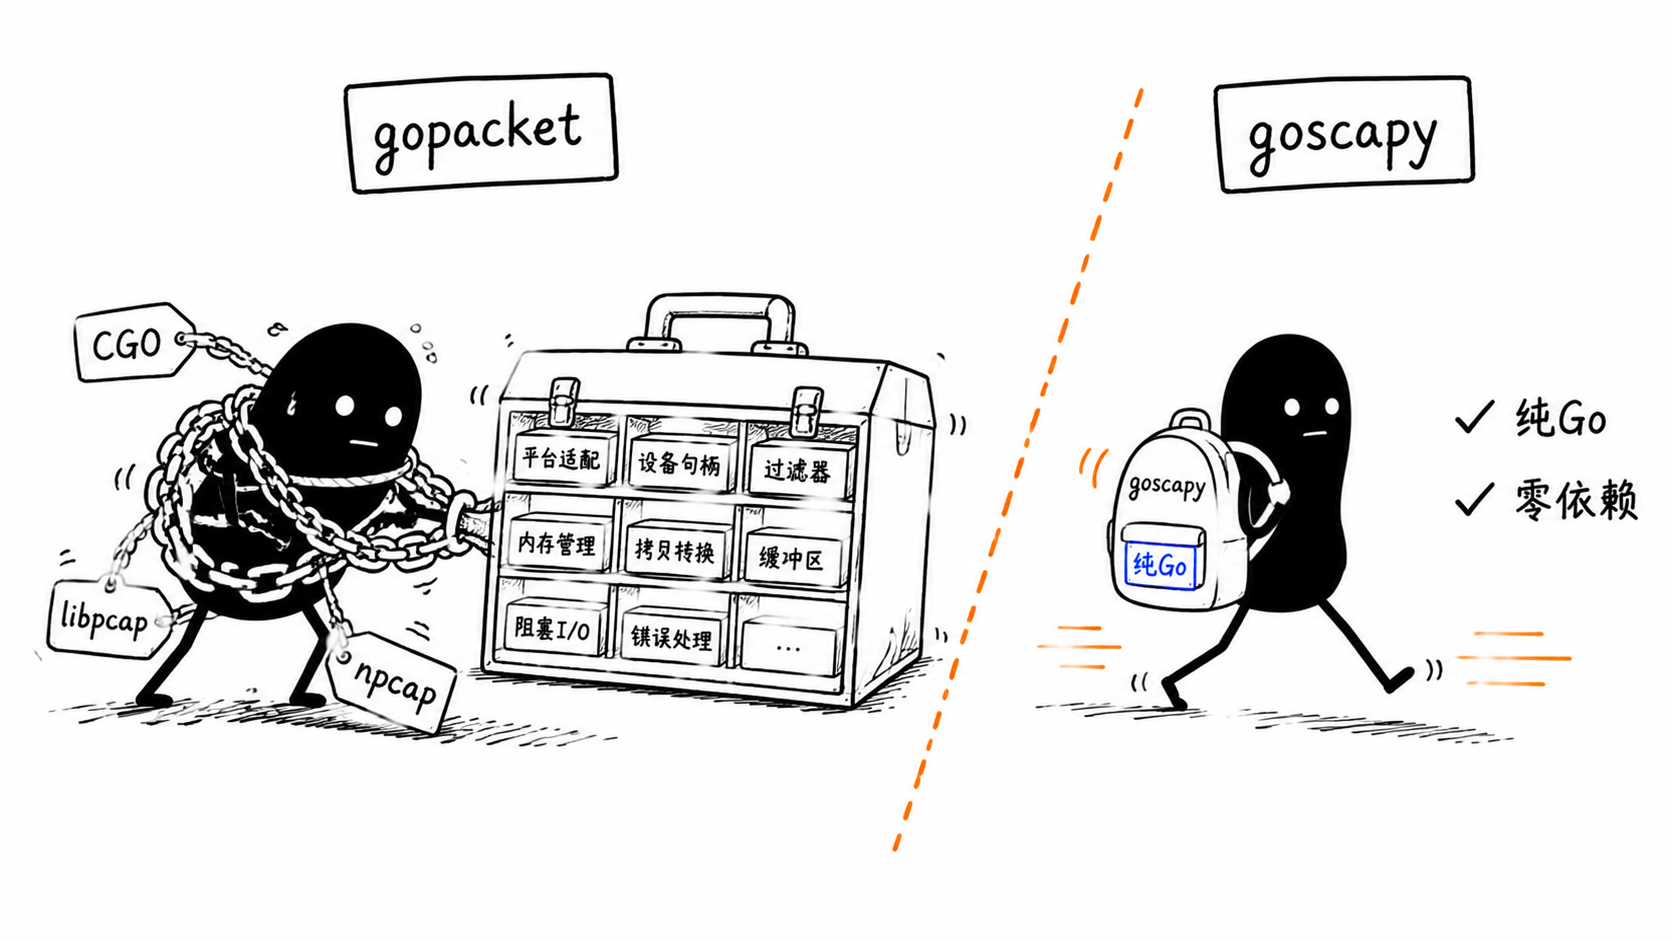
gopacket 更适合:需要解析冷门协议、对 pcap 文件读写有强需求、已经重度依赖 libpcap 生态的项目。
goscapy 更适合:网络工具开发、安全扫描、协议测试、网络监控探测——任何需要快速构造和收发数据包的场景。纯 Go 部署简单,API 用起来舒服。
goscapy 在序列化上做了不少优化:
SerializeInto:直接写入目标 buffer,无额外堆分配BuildInto:用户提供 buffer,整个包一次序列化完成RecvInto:收包直接读入用户 buffer,减少一次拷贝checksumIPv4Pseudo 直接折叠多个内存区域,不拼接WireSize:预计算序列化大小,一次分配精确大小的 buffer1 | // 零拷贝发送 |
还有 Linux 特有的高性能接收模式——AF_PACKET mmap、零拷贝 (PACKET_QDISC_BYPASS)、io_uring 原始套接字——适合高频探测场景。这些在 examples 目录里有完整示例(23-packet-mmap、21-zerocopy、22-uring-raw-socket)。
goscapy 自带了 50+ 个示例,覆盖从基础到高级的几乎所有场景:
每个示例都是可编译运行的小程序,直接 go run 就能跑。
项目地址:github.com/smallnest/goscapy
纯 Go,MIT 协议,零 C 依赖。go get github.com/smallnest/goscapy 就能用。
如果你在做网络工具、安全扫描、协议测试、监控探测——试试 goscapy,可能会让你重新爱上 Go 网络编程。

2026年5月28日 · Mike Piccolo, iii 创始人兼 CEO
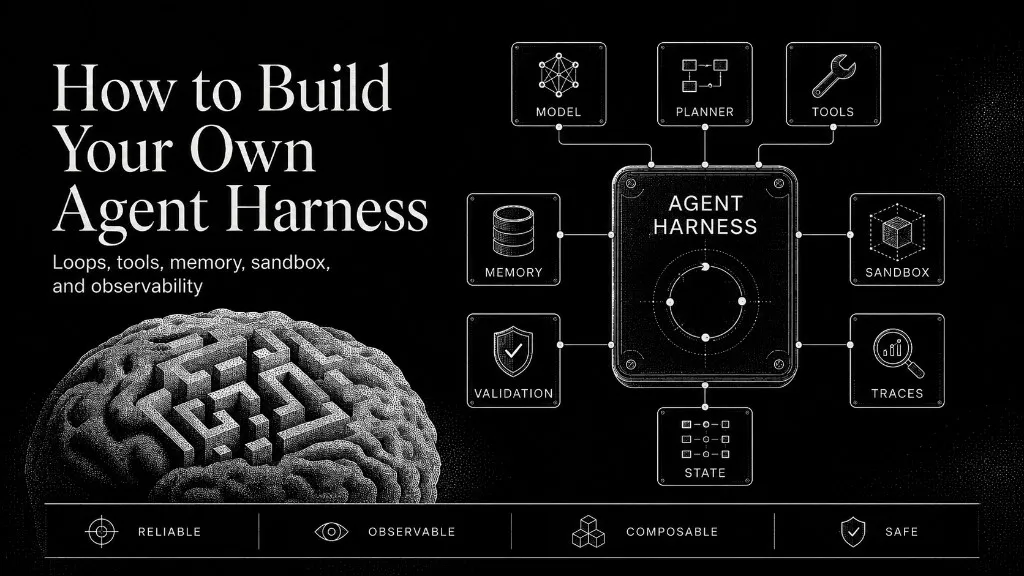
大多数 agent 团队不构建运行时。他们采用一个。LangChain、LangGraph、OpenAI Agents SDK、Anthropic SDK、CrewAI、AutoGen——循环、工具、记忆、编排,都是作为一个单一决策从货架上挑选的。运行时是一个你 import 的框架。如果里面的什么东西不合适,你就 fork 它、跟它斗争、或者绕过它。
你有没有过这样的经历:接手一个"跑了三年没人敢动"的项目,打开代码仓库一看——
src/ 下面 200 多个文件平铺在一个目录里,没有分层,没有模块边界。一个叫 UserService 的类 1800 行,发邮件、对接支付、状态管理全塞在里面,还挂着三个 TODO 标着"后面要重构"。业务逻辑全堆在 Service 层,Model 类只剩 getter 和 setter,贫血得像张纸。数据库查询藏在 for 循环里,每循环一次发一条 SQL。你问老员工这模块谁负责,得到一句:"这个……已经没人记得了。"
Martin Fowler 把这类问题叫做"代码坏味道"(Code Smell)。Brian Foote 和 Joseph Yoder 在 1997 年的论文里给了一个更直白的名字:Big Ball of Mud(大泥球)。
去年我还在折腾 langchain/langgraph 开发智能体,弄了个 langgraphgo 项目,把 langgraph 往 Go 生态圈里搬。那会儿网上做智能体的,十个有八个用 langchain/Crew AI。
一个阶段有一个阶段的玩法。
现在我看到了另一种路子:大家直接用 Claude Code、Codex、OpenCode、Pi 这些 coding agent "套壳"来实现智能体。
先说两个很多人搞混的点。
别觉得这些工具只能写代码。Claude Code、Codex 的架构走的是通用智能体模式,早就不止 coding 了。
也别把"套壳"当贬义词。Manus 刚火那阵,就有同事撇嘴说"这不就是 Claude 的套壳"。但你看,Claude、Codex、Antigravity 一个个都在推 SDK,巴不得你基于它们二次开发。牛顿怎么说的,站在巨人肩膀上不丢人。
你是不是也曾经盯着 pprof 火焰图发呆?
线上服务 P99 延迟从 50ms 飙到 800ms,Grafana 告警刷了满屏。CPU profile 翻来覆去看了三遍,热点函数是 sync.Mutex.Lock —— 锁竞争。但问题出在哪?锁粒度大、false sharing、还是并发模型本身选错了?脑子里闪过一堆可能性,每一条都够排查半小时。
如果有一个 Go语言的并发专家和性能专家在身边多好。
还有,对于有经验的老Go程序员,已经习惯了历史的Go语法和代码,对于新的特性反而没有新手更了解,如何保持与时俱进而不被新人所唾弃?
现在,这个愿望变成了现实:三个skill = 顶级有活力的Go语言专家。
做 Go 开发这些年,我发现 Go 程序员面对的最棘手的问题,几乎都可以归为三类:
第一类:并发。 死锁、数据竞争、goroutine 泄漏、channel 关闭时机不对、WaitGroup 计数配不平、锁重入导致自死锁……你写过 Go,就一定被其中至少一个坑过。
PRD(产品需求文档)和 SPEC(设计/技术规格说明书)是软件及硬件产品开发中两个不同阶段的核心文档,其核心区别在于:PRD 解释“做什么以及为什么做”(What & Why),而 SPEC 解释“怎么做以及做成什么样”(How & What exactly)。
| 维度 | PRD (Product Requirement Document) | SPEC (Specification) |
|---|---|---|
| 中文名称 | 产品需求文档 | 规格说明书(产品/技术/功能规格) |
| 核心回答 | 解决什么用户痛点?产品要实现哪些功能? | 系统如何实现?输入输出的标准和边界是什么? |
| 主要撰写者 | 产品经理 (PM) / 产品负责人 (PO) | 架构师 / 技术主管 (Tech Lead) / 资深工程师 |
| 维度 | 方案设计 (Design Doc / Proposal) | SPEC (Specification) |
|---|---|---|
| 所处阶段 | 技术调研与评审阶段(写代码前) | 最终确认与开发阶段(写代码时) |
| 核心目的 | 寻找解法,权衡利弊(Trade-offs) | 统一标准,指导施工(作为交付契约) |
| 内容特点 | 包含多种备选方案(方案A vs 方案B) | 只有一种确定的、极度详细的最终方案 |
| 状态变化 | 动态的,讨论后会被修改或推翻 | 静态的,通过评审后作为基线,轻易不改 |
